

分群跑完、標籤命名完之後,會議螢幕上開啟了一份彙整清單。
那是第一次有人把整年的通報攤在同一張表上看。清單上有二十幾條,每一條後面掛著件數、涉及哪幾個單位、對應哪幾個標籤。
然後會議就卡住了。
不是因為有爭議。是因為每一條都是真的。每一條都有人點頭。7B 的陳護理長翻完那張表,說了一句很誠實的話:
「這些我們都知道啊。」
我知道她不是在反駁。她的意思是:知道跟做得到之間,隔的不是資訊。
桌子另一頭坐著臨床科的黃主任,他整場沒有發言。
那天散會的時候,清單還是二十幾條。大家回去各做各的。
那份清單是我做的。這是這份工作裡最讓人挫折的一種失敗——不是找不到問題,是找到太多問題,然後一個都沒改。
第二週前面幾篇一直在拆同一件事:怎麼看得更多。抽樣改全量、判準寫下來、自由文字變成欄位——每一件都在把 recall 往上推。而 recall 上去了,這份清單只會變長,不會變短。
於是瓶頸換了位置。它從「找得到嗎」,變成「要做哪一個」。
選題有一張現成的表:影響度、可行性、可量測性,各給分,加總或相乘,排序。品管圈的第一步就是把這張表填完。
先講清楚一件事:這三個準則是我自己改過的版本。品管圈通行的選題評價用的是上級政策、重要性、迫切性、圈能力四項。我把上級政策收進權重那一層——它本來就是價值判斷,不是題目的屬性;把重要性與迫切性併成影響度;圈能力改叫可行性。然後加了一項原版沒有的:可量測性。加它的理由在後面那一節。
看起來很陽春。但這張表在分配的是全院最貴、也最不可再生的東西——單位同仁的注意力。第一線的班表本來就滿了,改善案是額外加上去的:每兩週開一次會、量一次數據、改一次做了十年的流程,做上大半年,那些時間全部是從別的地方擠出來的。
所以選錯題目的成本,不是浪費了那大半年。是下一次你再提改善案,沒有人想參加。這個成本會累積,而且很難還。
而這張表拆開來看,三層的性質完全不同。
| 層 | 做什麼 | 誰做 |
|---|---|---|
| 評分 | 每個候選題目在每個準則上是幾分 | 大部分可以交給機器 |
| 聚合 | 幾個分數怎麼變成一個順序 | 純算術,四十年前就自動化了 |
| 權重 | 哪個準則比較重要 | 人,而且只能是人 |
中間那層根本用不到 AI。上面那層是 Day 8 談過的判準形式化——把「影響度算幾分」寫成一組機器判得動的 acceptance criteria,同一套做法搬過來就是。
麻煩的是第三層。
因為權重不在資料裡。
它反映的是機構此刻的處境:今年的病安年度目標是哪幾條、上次評鑑被挑到什麼、哪個單位剛換主管所以這半年沒有餘力、哪一類事情最近上過新聞。沒有一項寫在通報資料裡,它們只存在於會議室裡那幾個人的腦袋裡,而且會隨著時間變。
但更根本的理由是:權重不該有標準答案。
它是一個機構決定「我們現在最在乎什麼」的動作。如果它有標準答案,品質委員會就不必開了。
這一層就是這個系列一直在講的那一半——不是還沒被寫下來,是本來就不該被寫死。形式化的部分交給系統,價值判斷留給人,而這條界線剛好疊在另一條線上:誰要負責。
權重是可以被質疑的東西。「為什麼可行性佔這麼重」是一個合理的問題,而坐在那張桌子旁邊的人——包括那天沒有發言的黃主任——必須答得出來。委員會可以對一組權重表決,但沒辦法對一段 embedding 表決。(判錯算誰的、誰簽名,是第五週整篇要談的事。)
所以權重要放在哪裡?
放在一份獨立的設定檔裡,跟 prompt 分開存放、分開版本控管。
理由不是工程整潔。是因為調權重是一個決策,而決策要留得下紀錄:什麼時候改的、改成什麼、誰決定的、當時的理由是什麼。
埋在 prompt 中間的那句「可行性請給予較高的比重」,改掉了沒有人會知道;下一季排序變了,也沒有人講得出來為什麼變。
把權重從 prompt 裡拉出來,不是為了讓程式好看,是為了讓「改變優先順序」這件事變成一個有人簽名的動作。
分數怎麼算是工程問題,權重多少是價值問題。兩者混在同一個地方的系統,症狀跟一條把 threshold 硬寫在規則裡的告警一模一樣:沒有人記得那個數字當初為什麼是那個數字,於是沒有人敢動它。
最直覺的用法是這樣問:「這二十幾條從通報裡整理出來的問題,幫我排出最值得做的三個。」
它會給你答案,而且答案通常不離譜。問題是它沒有留下任何可以檢查的東西:沒有分項、沒有理由、沒有一個可以拿去 diff 的中間輸出。
當你覺得第一名不對的時候,你分不出是它讀錯了那個問題的描述,還是它對「值得」的理解跟你不一樣。這跟昨天那個萃取與判斷分不開的情況是同一個病。把一個複合判斷拆成幾層各自可以驗證的東西,是這個系列從頭到尾在做的同一件事。
拆開之後,馬上會看到一件很尷尬的事。
三個準則裡,AI 能評的其實只有一個半。
但它一定會給你一個分數。
它不會說「我不知道」,它會給你一個中間偏高的數字。
這不是知識的失效,是把握程度的失效——而且這種失效比答錯難處理得多,因為輸出的形狀完全正常:型別對、範圍對、null 一個都沒有。一個 1 到 5 的整數,跟旁邊兩個準則長得一模一樣,印在同一張表上發給委員,看不出來哪一欄是有根據的、哪一欄是編出來的。
所以設計上的判斷是:可行性這一欄不自動評分。 它由單位自己填,或至少強制標成待人工複核。少一欄自動化,換一整張表的可信度,這筆交易划算得不必考慮。
這件事推廣開來是一條通則:決定要不要讓模型評一個維度,看的不是它評不評得出來,是它手上有沒有那個維度的資訊。 它永遠評得出來,這正是問題所在。
第二個設計決定,是關於那個總分。
三個準則算出一個分數,兩個題目同分——這兩個題目可能長得完全不一樣。一個是「影響很大但幾乎不可行」,一個是「影響普通但下週就能做」。
在管理上這是兩種完全不同的東西:前者要拆成小步驟,或往上呈報到品質委員會去要資源;後者現在就可以動手。但總分把這個差別抹掉了,而且抹掉之後救不回來。
這不是新問題。工業界長期使用的那類「嚴重度乘以發生率乘以可偵測性」的乘積分數,被詬病最久的正是這一點:同一個分數可以來自完全不同的風險輪廓。 三個中等分數的乘積,跟一個極端值配兩個低分的乘積,可以是同一個數字,但它們是兩種完全不同的危險。(醫療版的做法不是把第三個維度拿掉,是換了位置:危害計分只留嚴重度乘發生率,可偵測性移進決策樹當篩選問題。為什麼要這樣搬、搬完之後代價是什麼,是 Day 16 一整篇。)
你們那邊也有同一件事:同樣掛 P1 的兩個 incident,一個影響全站但已經有 workaround,一個只影響一個單位但完全沒有退路——壓成一個等級之後,on-call 的人看不出來該先接哪一個。而在我這邊,那張表是要發給品質委員會與各單位主管看的,看不出輪廓的代價是整場會議都在問「所以第一名為什麼是它」。
補救的方法不是去找一個更聰明的公式。是不要只輸出一個數字:排序旁邊保留每個準則的分數,讓輪廓看得見。排序負責決定討論順序,輪廓負責決定討論內容。
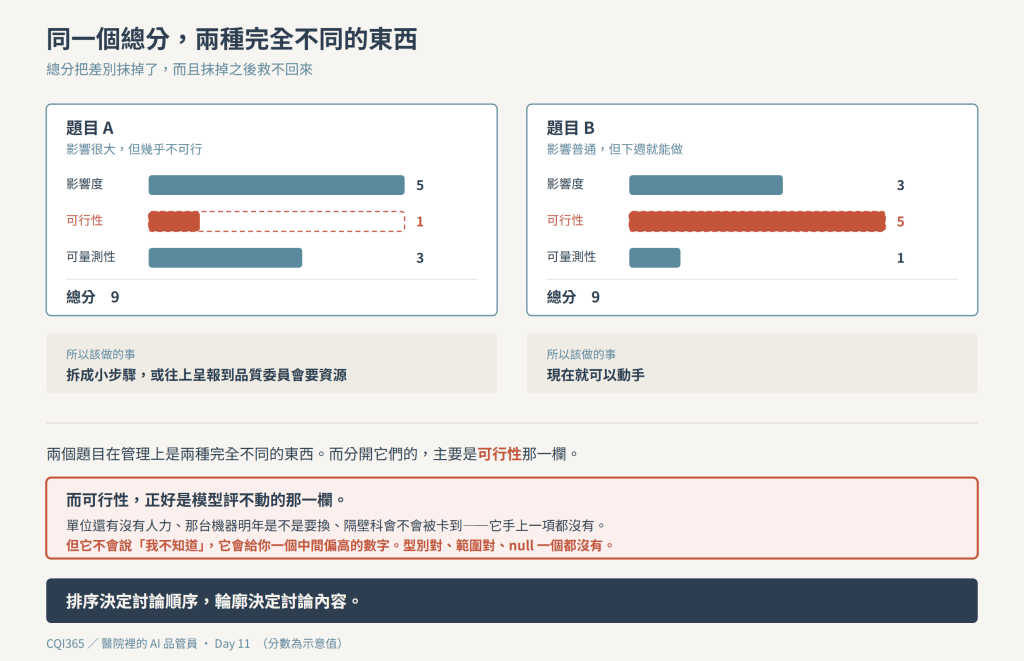
我們這個總分,就是你們那個 severity 標籤:它被設計出來是為了回答「要不要現在把人叫起來」,然後變成後面所有統計唯一的輸入。多維壓成一維,壓下去那一刻資訊就沒了,而且不可逆。
最後一件事,是這套東西怎麼從一份會議資料變成一個工具。
排序要能重跑,而且要能很方便地換一組權重重跑。原因是這樣:如果權重動一點點排序就翻天覆地,那代表這個排序不穩,不該拿去開會。
反過來,如果不管怎麼調權重,某一條都待在前三,那一條就是真的該做——它的優先性不依賴於你剛好挑了哪一組權重。這個判斷不需要任何統計知識,只需要你肯多跑幾次。你們調告警門檻的時候做的是同一件事:不是找一個對的數字,是找一個換了數字結論也不會翻掉的區間。
而這件事真正改變的,是這張表在會議室裡的用法。
最有用的一句話不是「系統說這題排第一」,是「權重要調成什麼樣子,你那一題才會排進前三」。
前者是宣布,只會引來防衛。後者是把選擇的結構攤開來,讓每個人看見自己真正在乎的是什麼。當陳護理長回你一句「那把可行性調低一點試試看」,這張表就從一份結論,變成了一個工具。
最後一件事跟排序沒有關係,但它決定前面所有東西會不會被用到。
這件事不是醫院獨有的。跟醫院一點關係都沒有的中小企業與製造業,導 AI 的時候最先卡住的也不是技術,是順序。
不要開一個「AI 專案」,要開一個品質改善專案——只是這一次,對策欄裡填的是 AI。
開「AI 專案」,第一個問題會是「要買哪一套」。然後你花三個月比廠商、看 demo、算授權費,而這三個月裡沒有任何一個人被要求說清楚「我們要改善的指標是什麼」。
開「品質改善專案」,第一個問題是「現在哪裡最痛、要改善的指標是什麼」。答完這一題才輪到問用什麼對策——而 AI 只是被選中的對策之一,搞不好還不是最好的那一個。
順序反過來的版本是先成立一個「AI 小組」,再回頭找題目。那個順序註定卡住:小組成立的那一天,它的 KPI 就變成「要有 AI 成果」,不是「那個指標要變好」。之後所有題目都會被往 AI 的方向挑,包括那些其實改一張表單就解決的。
這也是為什麼今天這張表上,三欄裡沒有一欄叫「適不適合用 AI」。那一欄不該存在——它是對策的性質,不是問題的性質,而選題選的是問題。
明天是第二週的回顧——從一個剛來的同仁問我的四個問題開始。


 iThome鐵人賽
 看影片追技術