
昨天講完 USE 和 RED 兩套方法論,也把三個服務的 RED 九宮格做出來了。今天做另外一半:節點的 USE。
然後我打算做一個小實驗,把 pricing 擴成兩份,示範「聚合會藏東西」。本來以為這只是一個五分鐘的示範,結果它變成今天最長的一節——因為實驗結果跟我預期的完全不一樣。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
今天要比較節點之間、Pod 之間的差異,不要被故障干擾。Grafana 一樣先開起來:
kubectl port-forward -n monitoring svc/kps-grafana 3000:80
節點的資源指標由 node-exporter 提供,這些不是我埋的,是裝 kube-prometheus-stack 就有的:
# CPU 使用率:1 減掉閒置的比例
1 - avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) by (instance)

# CPU 飽和度:等待中的任務數除以核心數
node_load1
  / on(instance) count by (instance) (node_cpu_seconds_total{mode="idle"})

# 記憶體使用率
1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes
第二條就是前面說的飽和度。node_load1 是「過去一分鐘平均有幾個任務在跑或在等」,除以核心數之後,超過 1 就代表任務比核心多,開始排隊了。
而這一條讓我卡了兩次,兩個坑都值得講。
第一個坑:沒有 on(instance) 的話,圖是空的。
我一開始寫的是 node_load1 / count by (instance) (...),結果什麼都沒有。原因是 node_load1 帶著 instance、job 等好幾個標籤,而 count by (instance) 只留下 instance 一個。PromQL 的除法預設要求兩邊標籤完全一致才配得起來,job 只有左邊有,配不上,結果就是空的。
on(instance) 的意思是「只用 instance 這個標籤來配對,其他的別管」。加上去之後圖就出來了。
又是空的。這已經是第三種了:查詢寫錯是空的、沒有資料是空的、標籤配不起來也是空的。
第二個坑:Grafana 會跳一個提示,但它是誤判。
Selected metric is a counter.
Consider calculating rate of counter by adding rate().
它看到 node_cpu_seconds_total 這種 _total 結尾的 counter 沒有包 rate(),就自動建議。但是這裡不該包——我要的不是 counter 的「值」,是它的「條數」。count() 數的是有幾條序列,每顆 CPU 核心會產生一條 mode="idle" 的序列,所以 count(...) 就等於核心數。這個數字跟 counter 累積到多少完全無關,包了 rate() 反而算出一個沒意義的東西。
提示是黃色的、查詢照樣跑,可以忽略。但這件事本身也是一課:工具的建議是規則比對出來的,它不知道你想幹嘛。
Day 5 多開兩個 worker 節點的價值在這裡兌現:三個節點的數字可以互相比較。如果只有一個節點,我根本不知道「這個數字算高還是低」。
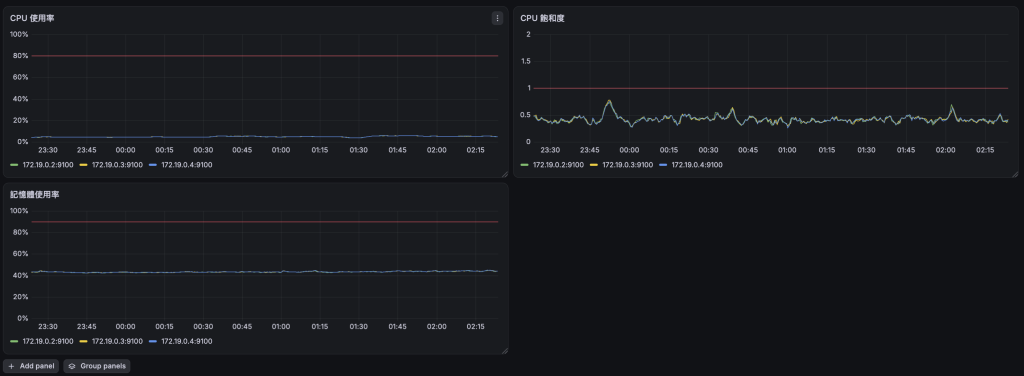
這三張的 Y 軸邏輯跟 RED 那組又不一樣:
| 面板 | Unit | Min | Max | Threshold |
|---|---|---|---|---|
| CPU 使用率 | Percent (0.0-1.0) | 0 | 1 | 0.8 |
| CPU 飽和度 | 不設,它是比值 | 0 | 2 | 1 |
| 記憶體使用率 | Percent (0.0-1.0) | 0 | 1 | 0.9 |
使用率的 Max 設 1,不要自動縮放。 這裡跟 Day 9 那張 SLI 圖的判斷相反:SLI 我只在乎 95% 到 100% 之間,所以把範圍縮很窄;但是 CPU 使用率我在乎的是整個 0 到 100%,因為危險區在 80% 以上。設成 0–1 之後,線貼在底部附近——那條低低的線就是答案,它在說「我離塞爆還很遠」。如果讓它自動縮放,2% 的波動會撐滿整張圖,反而看不出這件事。
飽和度的門檻一定要設在 1,因為那是這張圖唯一有意義的線:超過 1 代表等待的任務比核心多,開始排隊了。現在在 0.5 上下跳,離那條線還有一半的距離。
還有一個小坑:記憶體那張的圖例一開始壞掉,三行都在印一整串標籤(container=、endpoint=、namespace=、pod=⋯⋯)。原因是前兩條查詢有做聚合,avg by (instance) 和 count by (instance) 會把其他標籤丟掉;第三條沒有聚合,標籤就原封不動全留著。在查詢的 Legend 選 Custom 填 {{instance}} 就跟其他兩張一致了。
最值得看的是:三條線幾乎完全重疊。
這代表三個節點的負載是平均的,Kubernetes 的排程有在做事。而這正是 Day 5 多開兩個 worker 的價值兌現的地方——哪天有一條線岔開,那個岔開本身就是訊號。只有一個節點的話,我根本沒有東西可以比,也就不知道「這個數字算高還是低」。
這是今天最值得動手做的一個小實驗,而且它的結果跟我原本預期的完全不一樣。
kubectl scale deploy/pricing --replicas=2
然後把剛剛 RED 的 Rate 查詢加上 by (pod):
sum(rate(http_requests_total{job="pricing"}[5m])) by (pod)
我預期會看到兩條線、各自大約一半的流量。結果是這樣:
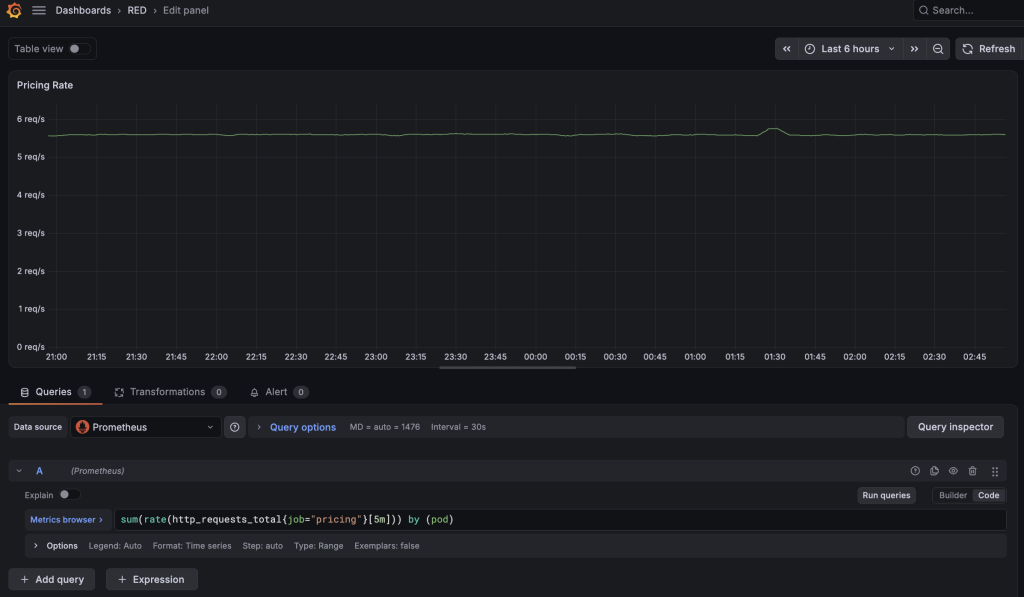
只有一條線,而且數字沒變,還是 5.6 req/s。
我第一個反應是第二個 Pod 還沒起來,去看了一下:
kubectl get pods -l app=pricing
兩個都是 Running。再確認它有沒有被掛進 Service:
kubectl get endpointslice -l kubernetes.io/service-name=pricing \
  -o jsonpath='{range .items[*]}{.endpoints[*].addresses}{"\n"}{end}'
兩個 IP 都在。所以 Kubernetes 那邊該做的都做了。
那就直接問兩個 Pod 各自處理了幾筆。這裡不用 rate,直接看累計值就好:
sum(http_requests_total{job="pricing"}) by (pod)
切到 Table 分頁看,結果是:
| Pod | 累計請求數 |
|---|---|
pricing-...-xwb48(舊的) |
129,633 |
pricing-...-8pwc5(新的) |
0 |
新的那個 Pod 活得好好的、也在 Service 裡面,但是一個請求都沒收到。
查了之後發現,這不是誰寫錯,是兩個各自正確的設計撞在一起。
第一層是 catalog 的程式碼。 它建立了一個模組層級的 HTTP client:
client = httpx.AsyncClient(timeout=10.0)
要解釋這一行為什麼有影響,得先講一件底層的事:兩個服務要講話,中間得先建立一條 TCP 連線,而建立連線本身是有成本的,需透過三方交握法才能建立連線,而這一來一回就是好幾毫秒。
所以一般的 HTTP client 都不會每送一個請求就重來一次,而是連線建好之後留著一直重複用,這個行為叫做 keep-alive。catalog 這個 client 也是如此:它對 http://pricing 開一條連線,之後十幾萬筆請求全部走這同一條。這是正確的做法,不是 bug。
第二層是 Kubernetes Service 的負載平衡。 問題出在它挑後端的時機。
Service 的負載平衡是 kube-proxy 靠 iptables 規則做的,而 iptables 看得到的只有連線,看不到裡面的 HTTP 請求。所以它是在連線建立的那一瞬間挑一個 Pod,挑完就記在一張對照表裡,之後這條連線上的所有封包一律送去同一個地方。它不知道你在這條連線上送了一個請求還是十萬個。
這件事用網路分層來講會更清楚一點:
| 層 | 是什麼 | 負責的事 |
|---|---|---|
| 第三層(網路層) | IP | 把封包送到哪一台機器 |
| 第四層(傳輸層) | TCP | 在兩端之間維持一條連線 |
| 第七層(應用層) | HTTP | 你送出去的那一個請求 |
kube-proxy 是第四層的負載平衡器,它認得的最小單位是「一條連線」,也就是一組 IP 加 port。但我想平均分配的最小單位其實是「一個請求」,那是第七層的東西。一條連線裡可以裝十萬個請求,而分配的動作只在連線建立的那一次發生——單位對不上,結果就是一條連線等於一個 Pod 扛全部。
用打電話來想的話:Service 是總機,兩個 Pod 是兩個客服。catalog 打電話進來,總機把它轉給甲;然後 catalog 就一直不掛電話,接下來所有問題全部問甲。總機能決定的是「這通電話轉給誰」(第四層,一通電話),但我真正想平均的是「每個問題找誰回答」(第七層,一個問題),而總機聽不到電話裡在問什麼。乙就這樣坐在位子上,一通都沒接到。
想驗證的話,重啟 catalog 逼它重新建連線:
kubectl rollout restart deploy/catalog
流量可能會跳到另一個 Pod,但是還是只有一個在收——因為它一樣只開一條連線。
這是很常見的真實問題,「我明明擴容了為什麼沒有變快」多半就是這個。真實世界的解法有幾種:關掉 keep-alive(簡單但是犧牲效能)、設定連線的最長壽命讓它定期重建、或者讓客戶端自己做負載平衡。而 Day 4 提過的 service mesh,解決的其中一件事就是這個——它在每個 Pod 旁邊塞一個第七層的代理,代理看得懂 HTTP,就可以逐個請求分配,不管它們是不是走在同一條連線上。
回到指標本身。這件事最可怕的地方是:從 sum(...) 那張圖完全看不出來。
九宮格上的 Pricing Rate 一直是 5.6 req/s,平穩、健康、沒有任何異常。要拆成 by (pod) 才會發現,兩個 Pod 裡有一個扛了 100% 的流量,另一個完全閒置——我以為我有兩份容量,實際上只有一份。
聚合藏的不是幾個百分點的誤差,是一半的容量。
這件事在故障三會再出現一次,而且更麻煩:如果兩個 Pod 只有一個在洩漏記憶體,平均看起來只是「稍微上升」,實際上有一個正在往 OOM 的路上走。
做完記得縮回去:
kubectl scale deploy/pricing --replicas=1
sum() 藏掉的可能不是幾個百分點,是一半的容量明天是 Metrics 區塊的最後一天,講自己埋指標,以及埋錯的代價,也就是那個叫 cardinality 爆炸的東西。


 iThome鐵人賽
 看影片追技術