

昨天把 pricing 擴成兩份,發現流量全壓在同一個 Pod 上,結論是「聚合會藏東西」。而聚合藏不藏得住,取決於當初把什麼寫進標籤裡。
這是 Metrics 區塊的最後一天。前面幾天一直在查 http_requests_total、http_request_duration_seconds、checkout_total,但我沒講過它們是怎麼來的——不是 Kubernetes 給的,是我自己寫在示範服務裡的。今天前半講怎麼埋,那部分真的只有十行;後半講埋錯的代價,而我在準備這篇的時候,在自己的程式裡找到兩個埋錯的地方。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=true LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
kubectl port-forward -n monitoring svc/kps-kube-prometheus-stack-prometheus 9090:9090
今天要看的其中一個 counter 埋在故障一的例外處理裡,故障不開就沒有數字。另外今天大多待在 Prometheus 的查詢頁面而不是 Grafana,所以 port-forward 轉的是 9090。
三個服務共用一個 common.py,指標都定義在裡面:
from prometheus_client import Counter, Histogram

requests_total = Counter(
    "http_requests_total", "HTTP 請求數", ["service", "path", "status"],
)
request_duration = Histogram(
    "http_request_duration_seconds", "HTTP 請求耗時", ["service", "path"],
    buckets=[0.01, 0.05, 0.1, 0.2, 0.3, 0.5, 1.0, 2.0, 5.0],
)
checkout_total = Counter("checkout_total", "結帳請求數", ["status"])
discount_missing_total = Counter(
    "discount_missing_total", "查不到折扣規則的次數", ["category"],
)
三個參數依序是名字、說明、標籤清單。說明會出現在 /metrics 的 # HELP 那行,Grafana 的指標選單也會顯示,值得好好寫。
定義完還要有人去動它。前兩個是在中介層(middleware)裡動的,每一筆請求都會經過:
requests_total.labels(SERVICE, path, str(response.status_code)).inc()
request_duration.labels(SERVICE, path).observe(elapsed)
.labels(...) 先把標籤的值填進去、拿到那一條序列,再對它做事:counter 做 .inc() 加一,histogram 做 .observe(耗時),把數字丟進對應的桶。
就這樣。加一個新指標的成本幾乎是零,這正是問題所在——太容易,所以很容易加一堆,也很容易加錯。
Prometheus 有一套命名慣例,不強制,但照著做別人才看得懂:
| 規則 | 例子 |
|---|---|
| 全小寫、用底線分隔 | http_requests_total |
counter 結尾加 _total |
checkout_total |
| 結尾帶單位 | _seconds、_bytes |
| 單位一律用基本單位 | 用秒不用毫秒、用 byte 不用 MB |
| 前面加上系統或服務名 | pricing_discount_missing_total |
單位那條最容易錯。直覺會想記毫秒因為數字好看,慣例卻是記秒,讓 Grafana 去做顯示的轉換——Day 9 設 Unit 就是在做這件事。混用單位的下場是有一天你把毫秒跟秒加在一起,而兩邊都是數字,不會有東西報錯。
最後一條我自己沒做到:checkout_total 應該叫 gateway_checkout_total 才對。現在沒事是因為整個叢集只有我在埋指標;真實環境一個 Prometheus 會抓幾十個團隊的服務,撞名不會有錯誤訊息,你只會查到兩邊的數字被加在一起。
histogram 唯一要動腦的地方就是桶。Day 10 講過桶是什麼,這裡講那九個數字怎麼挑。
buckets=[0.01, 0.05, 0.1, 0.2, 0.3, 0.5, 1.0, 2.0, 5.0]
原則是桶要圍繞你的門檻設。Day 2 定的延遲 SLO 是 P95 小於 300 毫秒,所以 0.3 必須是一個桶,而且兩側要有刻度,0.2 和 0.5 是刻意放的。因為 histogram_quantile 算出來的百分位數是在兩個桶之間內插的,不是真實數字——如果 0.2 到 0.5 之間空著,P95 落進這個區間就只能硬猜,誤差可能到一百毫秒,那個 SLO 等於白定。
兩端的 1.0、2.0、5.0 則故意稀疏,那裡我只想知道有沒有,不需要知道是 1.3 還是 1.4。
prometheus_client 的預設桶是 0.005 到 10 共十一個,適合一般的 HTTP 服務。改之前先問自己門檻在哪,答不出來就不要改。
discount_missing_total 埋在故障一的例外處理裡:
try:
    discount = RULES[product_id]
except KeyError:
    log.warning("discount rule not found", product_id=product_id, category=category)
    discount_missing_total.labels(category).inc()
    discount = 0
這就是 Day 6 埋的「算錯價但回 200」,Day 7 我們用 log 看到過那行 WARN,也講了一句「只有文字,不能聚合」。有了這個 counter 就數得了:
discount_missing_total
不過跑這行之前我先做了一件事:故障還沒打開的時候去查,結果是空的。 不是 0,是連名字都不在指標清單裡。我以為又是 ServiceMonitor 壞了,跑去看 targets,一切正常。
原因是 prometheus_client 對帶標籤的指標是懶的(lazy):Counter(...) 只是宣告,真正產生序列的是 .labels("hats") 第一次被呼叫的那一刻。故障沒開,那行例外處理沒跑過,/metrics 上就不會有這一條。
打開故障、等 loadgen 跑幾分鐘它就出現了,而且是兩條——壞掉的商品是 P013 和 P027,換算成分類剛好是 coats 和 hats。
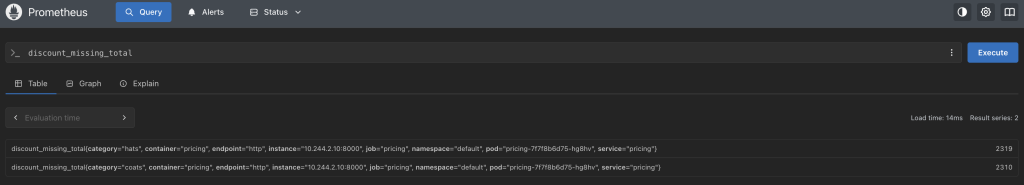
這有一個實務上的影響:不能靠「這個指標存在」來判斷服務是不是活著。 一個從沒被觸發過的錯誤 counter,跟一個根本沒起來的服務,查詢結果長得一模一樣,都是空的——跟 Day 11 那個 or vector(0) 是同一件事。
Day 11 做 RED 九宮格的時候,我的查詢全部寫 job="pricing",沒用 service="pricing",當時含糊帶過說「用 job 比較保險」。今天把標籤整個印出來,才知道實際發生了什麼事:
http_requests_total{
  job="pricing", service="pricing", exported_service="pricing",
  pod="pricing-68c85fbc7d-xwb48", namespace="default",
  container="pricing", instance="10.244.1.4:8000",
  path="/prices", status="200"
}
service 和 exported_service 同時存在,而 exported_service 那個才是我埋的。service 是 Prometheus 加的——ServiceMonitor 抓資料的時候會自動貼上這個 target 的 Kubernetes 身分,pod、namespace、container、service、job、instance 全都是它加的。
於是撞名了。Prometheus 遇到同名標籤,預設是保留自己的、把對方加上 exported_ 前綴,整個過程沒有警告。
結論是我那個 service 標籤從一開始就不該加,它跟 ServiceMonitor 給的完全重複。真正該我自己加的是 path 和 status,那兩個只有我的程式知道。規則很好記:埋標籤之前,先看一眼抓取端已經幫你貼了什麼。
Day 10 算過成本:一個 histogram 一組標籤是 12 條序列,而標籤之間相乘。今天講的是怎麼決定要不要加那個標籤。
序列的數量有個名字叫 cardinality(基數),每一組不同的標籤值組合就是一條獨立的序列,算法是乘法:
3 個服務 × 5 種狀態碼 × 4 種方法 = 60 條
還好。但如果手滑加一個使用者 ID:
3 × 5 × 4 × 10 萬個使用者 = 600 萬條
Prometheus 的記憶體大致跟活躍序列數成正比,所以這不是變慢,是記憶體暴漲之後被 OOMKilled——跟故障三同一種死法,只是死的是監控系統本身。
判斷原則只有一句:問自己這個標籤有幾種可能的值。 答案如果是「不知道」或「跟流量一起長」,就不能加。
| 不能加的標籤 | 為什麼 |
|---|---|
| 使用者 ID、Email | 有幾個使用者就有幾條 |
| 請求 ID、trace ID | 每一筆請求都是新的一條 |
| 含 ID 的完整網址 | /order/12345 每筆訂單都是新的 |
| 時間戳 | 每秒都是新的 |
| 錯誤訊息全文 | 訊息裡常常夾著變數 |
網址那條要特別小心,因為它看起來非常合理。正確做法是記路由樣板 /order/{id},不是實際路徑 /order/12345。
我得承認我的 path 就是直接抓 request.url.path,沒踩到坑純粹是運氣好——三個服務只有 /checkout、/prices、/items,沒有一個帶 ID。反過來 discount_missing_total 的 category 寫死在程式裡只有五種,是安全的。標籤該長的樣子就是這個:值的種類在寫程式的時候就數得出來。
講了半天乘法,不如直接看現在有幾條:
count({__name__=~".+"})
52,032 條。 老實說我第一次看到嚇一跳,因為我自己只埋了四個指標。那這五萬條是誰的?
topk(10, count by (job) ({__name__=~".+"}))
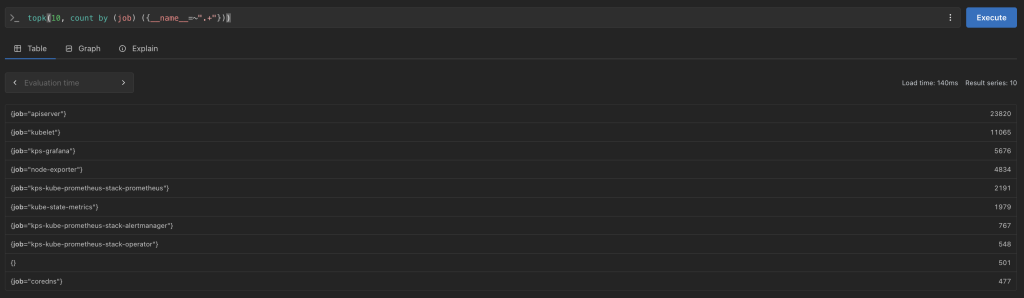
前兩名就佔了 67%,Kubernetes 自己的元件才是這個叢集裡最大的指標產生器,前十名裡連一個是我的都沒有——pricing、gateway、catalog 分別是 41、39、37 條,加起來 117 條,佔 0.22%。
再數一下有多少序列是 histogram 的桶:
count({__name__=~".+_bucket"})
26,954 條,佔全部的 52%。 序列數最多的單一指標是 apiserver_watch_events_dispatch_duration_seconds_bucket,一個指標就 2,982 條。這把 Day 10 的推導變成了看得見的東西:histogram 貴在一組標籤就是一整組桶,而 Kubernetes 的元件裡到處都是 histogram。
這個規模 Prometheus 自己吃 379 MiB 記憶體,跑在筆電上完全沒問題。但五萬乘以一百倍就不是了,而「乘以一百倍」在真實系統裡只需要有人加錯一個標籤。
Prometheus 還有一個現成的頁面在看同樣的東西:Status → TSDB Status,會列出序列數最多的指標和標籤,定期點進去看一眼,發現某個指標的序列數莫名其妙多,通常就是有人加錯標籤了。
那張表裡的東西不是不重要,只是放錯地方了:使用者 ID 和請求參數是 log 的工作,想追一筆請求走過哪些服務是 trace 的工作。metrics 的長處是聚合,而聚合的前提就是值的種類要少。
Day 3 講三大支柱的時候我把這個分工當成觀念在寫,今天它變成一條可以執行的判準:會讓序列數跟著資料量一起長的東西,就不屬於 metrics。
Metrics 區塊到這裡結束了。Day 1 那四句「看得到但看不懂」的抱怨劃掉了兩句——歷史有了,聚合也有了,剩下兩句要靠 logs 和 traces。
.labels() 之前不存在,查不到不代表服務有問題exported_
明天開始 Logs 區塊。為什麼 log 一定要寫成結構化的,後來發現它其實是後面所有查詢的前提。


 iThome鐵人賽
 看影片追技術