
昨天把 Metrics 區塊收尾了,今天開始 Logs。這一天一樣不裝任何東西,講一件我原本覺得很無聊、後來發現是整個區塊前提的事。
坦白說,我第一次看到「結構化日誌」這個詞的反應是:不就是把 log 寫成 JSON 嗎,這有什麼好講一整天的?
直到我試著回答一個問題才發現差別在哪:
過去一小時,折扣算錯的請求有幾筆?
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=true LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
今天要一直拿故障一那行警告當例子,讓它持續發生比較好對照。
先看兩種寫法。第一種是大部分人的預設,也是我以前寫 Python 只會 print() 的樣子:
2026-09-11 15:58:31 WARNING discount rule not found for product P013 in category coats
第二種是我現在的服務實際印出來的:
{"service": "pricing", "product_id": "P013", "category": "coats",
 "event": "discount rule not found", "level": "warning",
 "timestamp": "2026-09-11T15:58:31.619830Z"}
兩行裡面的資訊一模一樣。差別只有一個:第二種的每個值都有名字。
回到剛才那個問題。用第一種,我能做的只有 Day 7 做過的那件事:
kubectl logs deploy/pricing | grep "discount rule not found" | wc -l
這行有三個問題,Day 7 全部遇過了:只涵蓋這個容器還留著的那幾千行、沒辦法指定時間範圍、而且只要哪天有人把訊息從 not found 改成 missing,這個統計就會靜靜地變成 0,不會有任何東西告訴你。
用第二種,同樣的問題會變成一句查詢,而且可以按 category 分組、可以畫成圖、可以設告警。明天裝完收集器就會做這件事。
所以「結構化是前提」的意思不是它比較漂亮,而是沒有結構的 log 只能用眼睛看,有結構的 log 才能被計算。
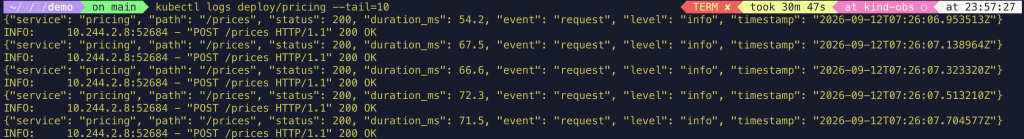
寫到這裡我去撈了一次實際的 log 想截圖,然後看到這個:
{"service": "pricing", "path": "/prices", "status": 200, "duration_ms": 70.9, "event": "request", "level": "info", "timestamp": "2026-09-11T15:58:51.169181Z"}
INFO:     10.244.2.8:58704 - "POST /prices HTTP/1.1" 200 OK
{"service": "pricing", "path": "/prices", "status": 200, "duration_ms": 73.8, "event": "request", "level": "info", "timestamp": "2026-09-11T15:58:51.351858Z"}
INFO:     10.244.2.8:58704 - "POST /prices HTTP/1.1" 200 OK
JSON 那幾行是我寫的,INFO: 開頭那幾行不是——那是 uvicorn(跑 FastAPI 的那個伺服器)自己的存取紀錄,它預設就會印,而且是純文字。
我數了最近 200 行:
| 行數 | 平均長度 | |
|---|---|---|
| 我的 JSON | 105 | 159 bytes |
| uvicorn 的純文字 | 95 | 59 bytes |
一半一半。 我以為我有一套結構化的 log,實際上每印一行可查詢的,旁邊就有一行不可查詢的。
這件事我覺得值得寫出來,是因為講結構化日誌的文章通常會說「要有紀律,不然團隊裡有人繼續用 print() 就破功了」。我原本以為那是在講同事,結果第一個破功的是我用的框架,而且它從第一天就在那裡印,我看了一個禮拜都沒注意到。
順帶一提,uvicorn 那行的資訊我其實已經有了——path、status 都在我自己的中介層裡,而且我還多記了 duration_ms。它唯一多給的是客戶端 IP。所以關掉它(啟動時加 --no-access-log)幾乎沒有損失,還可以少一半行數。
不過我決定先不關,因為明天裝收集器的時候,這種混雜格式正好可以看出解析器遇到非 JSON 的行會怎麼處理。
在講欄位之前,先講一個更前面的問題:log 要寫到哪裡。
很多教學會教你設定 log 檔案路徑、設定輪替(log rotation,就是檔案太大時自動切成好幾個、刪掉最舊的)。在容器裡不要這樣做。
原因 Day 7 已經親身踩過了:容器是短命的,Pod 一重啟,寫在容器裡的檔案就跟著消失。那天我想看重啟前的 log,只能靠 kubectl logs --previous 撈到前一個,再前面的就永遠不見了。
正確做法是把 log 印到標準輸出就好,剩下的交給平台:Kubernetes 會自動把容器的 stdout 接走、存成節點上的檔案,明天裝的收集器再去讀那些檔案。
這個原則出自 12-Factor App 的第十一條,一句話是「把 log 當成事件流」——程式只負責產生,不負責決定它被存到哪、留多久。
好處是我的三個服務完全不需要知道有沒有 Loki。哪天要換一套 log 系統,改的是收集器的設定,不是我的程式碼。
有幾個欄位幾乎每一行都該有:
| 欄位 | 為什麼 |
|---|---|
| 時間戳 | 用 ISO 8601 格式並且帶時區 |
| 等級 | 之後所有的過濾都靠它 |
| 訊息 | 固定字串,不要把變數串進去 |
| 服務名 | 多服務的時候一定要有,不然不知道是誰印的 |
| trace_id | 現在還是空的,後面接追蹤系統的時候會填 |
我的 common.py 裡設定的是 structlog,上面前四個它都自動處理掉了:
structlog.configure(
    processors=[
        structlog.processors.add_log_level,
        structlog.processors.TimeStamper(fmt="iso"),
        structlog.processors.JSONRenderer(ensure_ascii=False),
    ],
)
return structlog.get_logger(service=SERVICE)
三個處理器依序做三件事:補上 level、補上 ISO 格式的 timestamp、把整包轉成 JSON。get_logger(service=...) 則是把服務名綁在這個 logger 上,之後每一行都會自動帶著。
有一個小細節要先講,因為明天查詢的時候會用到:structlog 把訊息放在叫做 event 的欄位,不是比較常見的 msg 或 message。 這不是錯,只是它的慣例,但如果你的公司規定欄位叫 msg,記得加一個 EventRenamer("msg") 處理器去改名,不然兩套服務的 log 會對不起來。
上面那張表裡最容易做錯的是「訊息」那條。訊息本身要是固定的字串,變動的部分要放進獨立的欄位。
log.warning(f"discount rule not found for {product_id}")   # ✗
log.warning("discount rule not found", product_id=pid)     # ✓
第一種寫法會讓「同一類事件」變成無限多種訊息——每一個商品編號都產生一句不一樣的話。你沒辦法把它們歸成一類來計數,因為它們字面上就不一樣。
這跟昨天講的 cardinality 剛好是一體兩面:指標的標籤不能亂變,log 的訊息也不能亂變。 差別在於位置——指標是「值的種類不能多」,log 是「訊息不能多,但欄位裡的值愛多少種都可以」。log 天生就是拿來放高基數細節的,這也是為什麼昨天那些不能當標籤的東西要放在這裡。
等級的分法我查了一下,比較實用的判準是問「這一行會不會有人因為它而做事」:
| 等級 | 什麼時候用 |
|---|---|
| ERROR | 出事了,而且需要人介入 |
| WARN | 不對勁,但系統自己處理掉了 |
| INFO | 正常但重要的事件(服務啟動、收到請求) |
| DEBUG | 平常關掉,查問題的時候才開 |
故障一那行剛好是 WARN 的標準例子:查不到折扣規則(不對勁),但程式塞了個 0 進去繼續跑(自己處理掉了)。
而它同時也暴露了 WARN 的危險——WARN 的意思是「我幫你處理掉了」,但誰去確認那個處理方式是對的? 我那行 WARN 從服務上線第一天就一直在印,一直到 Day 7 我去 grep 才第一次被人看到。使用者這段時間拿到的價格全部是錯的,而系統從頭到尾都回 200。
這也是為什麼昨天要在那個 except 裡多埋一個 counter:WARN 只是把事情記下來,counter 才能讓它被數、被畫、被設成告警。
| 不要記 | 為什麼 |
|---|---|
| 密碼、API key、token | 一旦寫進 log 就等於外洩,而且會被收集器同步到各處 |
| 完整卡號、身分證字號 | 同上,而且違法 |
| 使用者的個人資料 | 除非有明確理由,而且要想清楚保存期限 |
| 整包 request body | 量大,而且常常就包含上面那幾項 |
最後一項是我覺得最容易犯的——除錯的時候把整個請求印出來超級方便,然後就忘了拿掉,上線之後它還在那裡印。
只講好處不太誠實,所以也講一下代價。
一、人眼不好讀。 一行 JSON 擠十個欄位,直接 kubectl logs 看真的很痛苦,尤其是上面那種跟純文字交錯的狀況。解法是分環境:本機開發用彩色的人類可讀格式,正式環境用 JSON,structlog 換一個 renderer 就好。
二、體積變大。 我上面量到的數字就是證據:同樣一筆請求,我的 JSON 是 159 bytes,uvicorn 的純文字是 59 bytes,差了大約 2.7 倍。以行數算我的只佔 53%,以位元組算卻佔了 75%。量大的系統這個差距是要付錢的。
三、要有紀律。 只要有一個地方繼續印純文字,查詢的時候就會出現破洞——而這篇的主角就是我自己的破洞。
不過對這個系列來說三個代價都不痛:我的流量很小,紀律問題只有我一個人,而 uvicorn 那半邊正好留著當明天的教材。
event 不是 msg,跨團隊的時候要統一明天裝 Loki 開始收 log,並且做一件我滿期待的事:把 log 跟指標放在同一個畫面上對照。


 iThome鐵人賽
 看影片追技術