
今天是這個系列第一次破案。
Day 6 埋了三個故障,第一個是「算錯價但回 200」——部分商品沒套到折扣,狀態碼正常、速度正常、錯誤率 0。Day 7 用 kubectl 查它,結論是查不出來。Day 13 埋了一個 counter 讓它有數字,但那時候我已經知道答案了。
今天假裝不知道,用 LogQL 從頭把它挖出來。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=true LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
kubectl port-forward -n monitoring svc/kps-grafana 3000:80
開了之後等幾分鐘讓 log 累積。
LogQL 是 Loki 的查詢語言,語法刻意做得跟 PromQL 很像。一個查詢最多三段:
{app="pricing"}  |  json | level="warning"  |  count_over_time(... [5m])
   1. 選流            2. 處理                   3. 聚合(選用)
第一段是必要的,而且只能用標籤。這是 Loki 逼你先縮小範圍——沒有這段它不知道要掃哪些資料。第二段做解析和過濾,昨天 | json 就是這裡。第三段把 log 變成數字,等一下會看到它是 LogQL 跟 grep 的分水嶺。
假設客服轉來一句「有使用者說折扣沒算到」。跟 Day 3 那句「結帳很慢」一樣,沒有可行動的資訊。
先看系統正不正常——打開 Day 9 做的 SLI 儀表板:
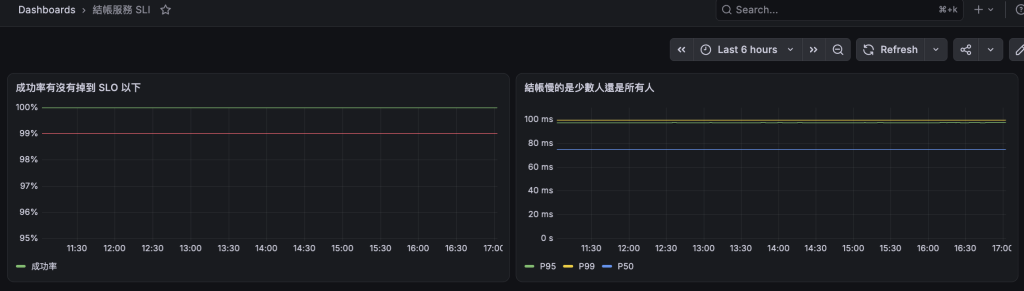
成功率 100%,穩穩貼在 SLO 那條 99% 紅線上面;P50 78 毫秒、P95 和 P99 都在 97 毫秒左右,三條線全平。這是六小時的範圍,故障是最後半小時才打開的,圖上看不出任何變化。
全綠。如果我只有 metrics,調查到這裡就結束了,結論是「查無異常,請使用者提供更多資訊」。這正是故障一被設計成這樣的原因。
既然是折扣的問題,先看 pricing。到 Explore,資料源選 Loki:
{app="pricing"} | json | level=~"warning|error"
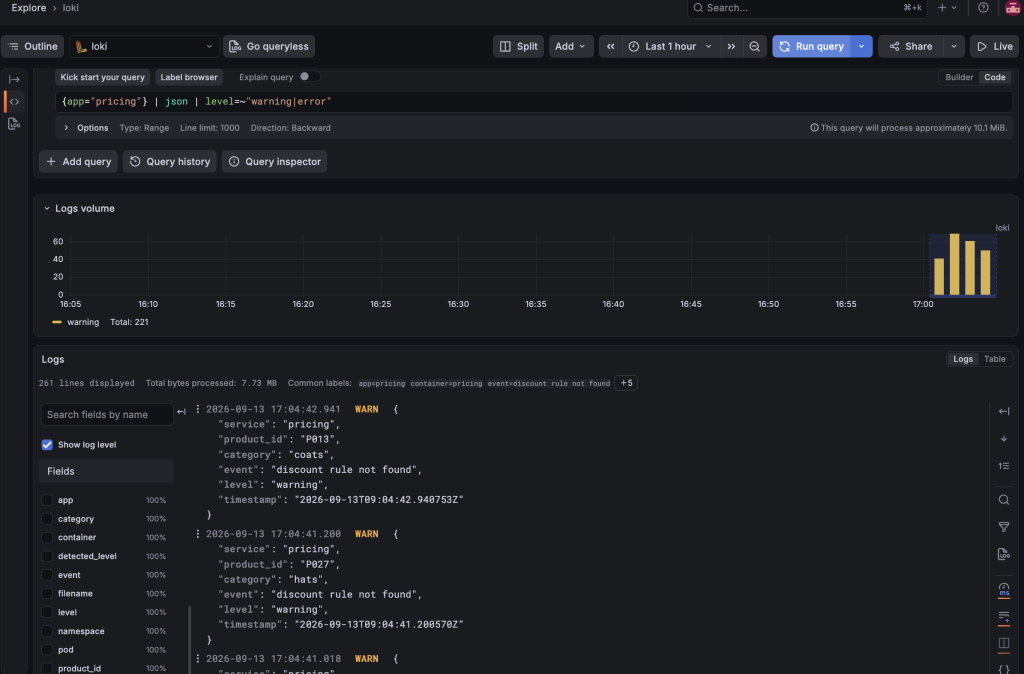
找到了。上面 Logs volume 只有 17:00 之後有黃色柱子,那是我打開故障的時間,之前一整個小時都是零。Common labels 那行寫著 event=discount rule not found,意思是查到的 261 行全部是同一件事;展開任何一行,product_id 不是 P013 就是 P027。
但這只是看到,還不算查到——我還答不出它有多嚴重、從什麼時候開始、影響誰。
sum(count_over_time({app="pricing"} | json | event="discount rule not found" [5m]))
count_over_time 數出每五分鐘出現幾筆,sum 把所有 Pod 加總。注意過濾條件用的是 event,structlog 把訊息放在這個欄位,不是常見的 msg。
切到 Graph 分頁,它變成一條線:
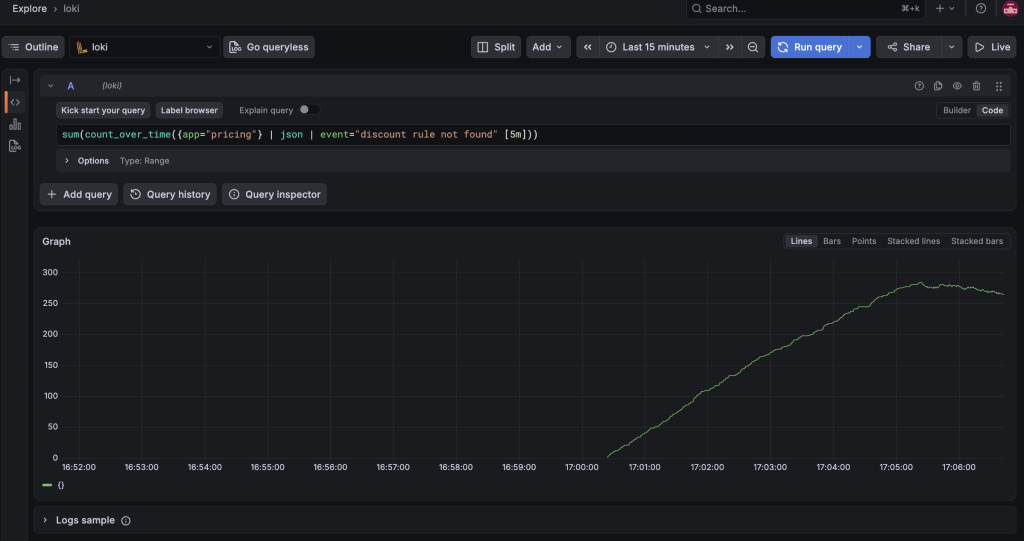
先講那段爬坡,因為它會誤導人。17:00 是我打開故障的時間,線從那裡開始往上爬,17:05 之後才變平——看起來像故障在五分鐘內逐漸惡化,其實不是。count_over_time(... [5m]) 數的是「過去五分鐘有幾筆」,故障剛打開的時候,那五分鐘的視窗裡大部分還是打開前的零,要等視窗整個被填滿數字才是真的。爬坡的長度就等於中括號裡的數字。
17:05 之後的那段才是重點:它是平的。 每五分鐘大約 270 筆,沒有尖峰、沒有起伏。這不是某個時段的事故,是每一筆請求都有固定比例會踩到。
用 kubectl logs | grep 看不出這件事。grep 給你一個總數,它不會告訴你這個總數是一次爆發還是持續滲漏。
它每五分鐘發生幾次不重要,重要的是佔了多少。拿它跟訂單數比:
sum(count_over_time({app="pricing"} | json | event="discount rule not found" [5m]))
  /
sum(count_over_time({app="gateway"} | json | event="checkout priced" [5m]))
分母是 gateway 每筆成功訂單印的那行。
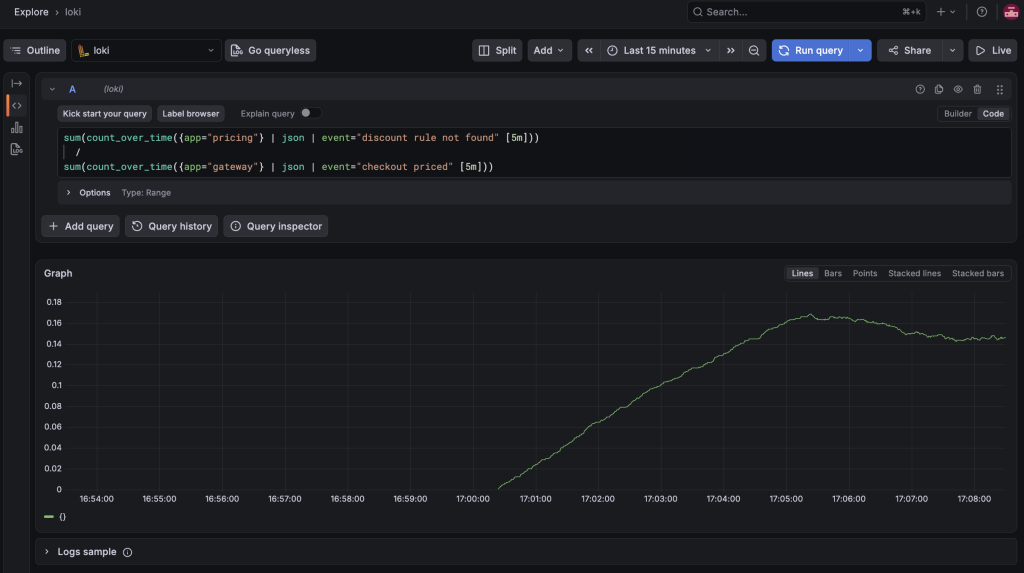
一樣有那段五分鐘的爬坡,之後在 0.15 到 0.17 之間晃。大約每 6 筆訂單就有 1 筆金額是錯的。 一個錯誤率 0 的系統。
這個數字對得上程式碼:50 個商品裡壞了 2 個,也就是 4%;購物車平均 4.2 件,4.2 乘 4% 就是 16.8%。實際值會在這附近上下,因為購物車大小是隨機的,五分鐘的視窗裡大概只有一千七百筆訂單。「4.2 件」也可以直接從 log 算出來:
sum by (item_count) (count_over_time({app="gateway"} | json | event="checkout priced" [1h]))
我這邊一小時 20,290 筆訂單,1 到 5 件各佔 16% 左右,6 到 12 件各佔 3%,平均 4.23 件——loadgen 那個「八成小車、兩成大車」的設計直接畫在圖上。
有一件事這裡算不出來:到底是哪些訂單受影響。 pricing 的那行 WARN 跟 gateway 的那行 checkout 之間沒有任何共同的欄位,我知道兩邊各發生了幾次,但對不起來。這個缺口後面接追蹤系統的時候會補上。
現在這句話從「有使用者說折扣沒算到」變成「4% 的商品缺折扣規則,導致約六分之一的訂單金額算錯,持續發生」。這是一句可以拿去開會的話。
最後問「是全部商品還是特定商品」:
sum by (category) (count_over_time({app="pricing"} | json | event="discount rule not found" [5m]))
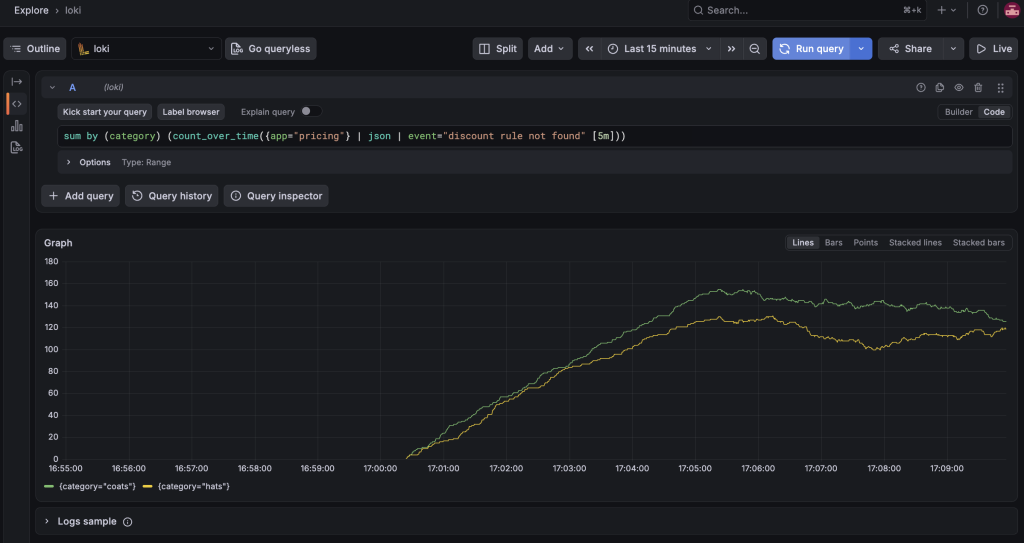
只有兩條線,coats 和 hats,五分鐘各一百二三十筆,其他三個分類一筆都沒有。不是隨機,是特定的規則沒建。拿著這個去找建規則的人,比拿著「有人說折扣沒算到」好談很多。
category 不是 Loki 的標籤,它是 log 內容裡的一個 JSON 欄位,因為 | json 把它解析出來了才能拿來分組。如果 log 還是 Day 14 開頭那句英文句子,這一步做不到。
上面用了兩種模式:
| 回傳 | 用在 | |
|---|---|---|
| Log query | 一行行的 log | 看細節、找線索 |
| Metric query | 數字曲線 | 算頻率、比例、趨勢 |
差別只在有沒有包 count_over_time 這類函式。同一份 log,可以當文件讀,也可以當指標算。
Day 13 埋的那個 counter 算的是同一件事:
sum(rate(discount_missing_total[5m]))
那今天為什麼還要用 LogQL 算一次?兩個都對,但用途不同:
| Metric(Day 13 的 counter) | Log(今天的 LogQL) | |
|---|---|---|
| 查詢成本 | 極低 | 高,每次都要掃原始資料 |
| 保存 | 可以留幾個月 | 通常幾天到幾週 |
| 細節 | 只有你事先想到的標籤 | 全部都在 |
| 適合 | 儀表板、告警 | 臨時調查 |
一句話:已知的問題用 metric,未知的問題用 log。
而且有先後。Day 13 那個 counter 是我知道答案之後才埋的;真實情況是先用 log 查出問題,確認它重要,才值得埋一個 metric 去長期盯著。一開始就想好要埋哪些 counter 做不到,那需要你預知會出什麼事。
第一個故障的完整結論:
count_over_time 算頻率、跟訂單數相除算比例、by (category) 找範圍Day 7 那句「只有文字,不能聚合」,正式劃掉。
count_over_time 讓 log 變成可畫圖的數字| json 之後 log 裡的任何欄位都能拿來分組,結構化在這裡兌現明天開始 Traces。第二個故障在等著——那個 metrics 只看得到「慢」、log 只看得到「每筆都成功」的 N+1。


 iThome鐵人賽
 看影片追技術