
昨天講完為什麼 log 要寫成結構化的,今天把它們收起來。
要裝兩個東西:Loki(存 log 的資料庫)和 Grafana Alloy(去讀 log 再送進 Loki 的搬運工)。然後做一件從 Day 3 就想做的事——把 log 和指標放在同一個畫面上對照。
先講結論:官方 chart 照文件抄一遍是裝不起來的,我就卡了四次。
kubectl set env deploy/pricing BUG_SILENT_DISCOUNT=false LEAK_KB_PER_REQUEST=0
kubectl set env deploy/catalog BUG_N_PLUS_ONE=false
今天只要確認 Loki 收得到正常的 log 就好,故障留到之後查。
裝之前先講它為什麼跟別人不一樣,因為這個設計會直接影響你怎麼用它。
業界最經典的 log 方案是 ELK(Elasticsearch + Logstash + Kibana),它的做法是把 log 裡的每個字都建索引,所以搜任何關鍵字都很快,代價是索引常常比原始資料還大,也很吃記憶體。
Loki 反過來:只對標籤建索引,log 內容本身不建。 查詢的流程是先用標籤把範圍縮小,再把那些原始資料抓出來暴力掃一遍。所以它存的時候很便宜,查的時候標籤縮得夠小就快,縮不夠就慢。
這帶出一條使用守則:標籤要少、要低基數。
聽起來很耳熟,因為這跟 Day 13 的 cardinality 是同一個問題。把 trace_id 當 Loki 的標籤,跟把使用者 ID 當 Prometheus 的標籤,會炸得一樣慘。
那 trace_id 要怎麼查?放在 log 內容裡查——用標籤縮到某個服務、某段時間,再從內容裡撈。Loki 就是為這種用法設計的。
先加 repo:
helm repo add grafana https://grafana.github.io/helm-charts
helm repo update
然後照文件裝,結果連 helm template 都過不了:
Error: execution error at (loki/templates/validate.yaml:19:4):
Cannot run scalable targets (backend, read, write) or distributed
targets without an object storage backend.
第一個坑:deploymentMode=SingleBinary 不會關掉其他模式的元件。 這個 chart 同時支援單機、可擴展、分散式三種佈署,你選了單機,它還是會產生 read / write / backend 三組工作負載,而那三組要求有物件儲存(S3 之類)。要另外把它們的副本數設成 0。
加上去之後換一個錯誤:
You must provide a schema_config for Loki ...
For quick testing (with no persistence) add `--set loki.useTestSchema=true`
第二個坑:Loki 不給預設的 schema。 schema 決定索引和資料塊怎麼排版,官方的立場是每個叢集都該自己決定、不該有預設值。本機測試就照它說的用 useTestSchema。
改完終於能裝了,但裝完會有一個 Pod 一直 Pending:
loki-chunks-cache-0 0/2 Pending 0 5m
第三個坑:預設的快取要 9.6 GB 記憶體。 我用 kubectl describe 看事件,寫的是 Insufficient memory。去看 chart 的預設值,chunks-cache 的 requests 和 limits 都是 9830Mi,而我三個節點各只有 7.6 GiB 可配置——它不可能排得進任何一個節點。
這個數字對正式環境是合理的,對筆電上的 kind 不是。本機直接關掉。
這三個補上之後就裝起來了,四個 Pod 全部 Running。但安裝完的 NOTES 裡有一段我差點跳過:
Loki is configured with auth enabled (multi-tenancy) and expects tenant headers (
X-Scope-OrgID) to be set for all API calls. ... Loki will reject reads and writes with a 404 status codeno org id
第四個坑:chart 預設開啟多租戶。 預設值裡 auth_enabled: true,代表每個 API 呼叫都要帶 X-Scope-OrgID 標頭說明自己是哪個租戶,沒帶就回 404。
這一個比前三個難查。前三個是裝不起來,錯誤訊息直接寫在臉上;這個是裝得起來、Pod 全部 Running、看起來完全正常,等你接上收集器才會發現東西進不去,而且錯誤碼是 404——看起來像網址打錯,不像權限問題。
本機單人叢集不需要多租戶,關掉就好。完整指令:
helm install loki grafana/loki -n monitoring --version 7.3.0 \
  --set deploymentMode=SingleBinary \
  --set loki.auth_enabled=false \
  --set loki.commonConfig.replication_factor=1 \
  --set loki.storage.type=filesystem \
  --set loki.useTestSchema=true \
  --set read.replicas=0 --set write.replicas=0 --set backend.replicas=0 \
  --set chunksCache.enabled=false --set resultsCache.enabled=false
我把版本號 --version 7.3.0 寫死了,因為這個 chart 的參數名稱改過很多次。網路上的教學十篇有八篇的指令現在跑不了,就是因為沒有寫版本。
Loki 傳統的收集器叫 Promtail,網路上絕大多數教學都在教它,但它已經停止開發,官方改推 Alloy。helm repo 裡 promtail 的 chart 還在,版本停在很久以前。
而 Alloy 的坑是另一種。下面這行不要照抄。
# ✗ 這樣裝起來什麼都不會收
helm install alloy grafana/alloy -n monitoring --version 1.12.1
這樣裝 Pod 會是 Running,看起來一切正常。我去看 chart 的預設值才發現,alloy.configMap.content 預設是空字串——它只是把 Alloy 這個程式跑起來,設定檔得自己給。
這跟 Day 8 那個 ServiceMonitor 沒套用是同一種狀況:元件是活的,但它不知道自己該做什麼,而且不會抱怨。
設定檔我放在 repo 的 helm/alloy-values.yaml,裝的時候一定要用 -f 帶進去:
# ✓ 正確的版本
helm install alloy grafana/alloy -n monitoring --version 1.12.1 \
  -f helm/alloy-values.yaml
如果你已經照上面那行裝過了,helm 會說 cannot reuse a name that is still in use,先 helm uninstall alloy -n monitoring 再重來。
kubectl get pods -n monitoring | grep -E "loki|alloy"
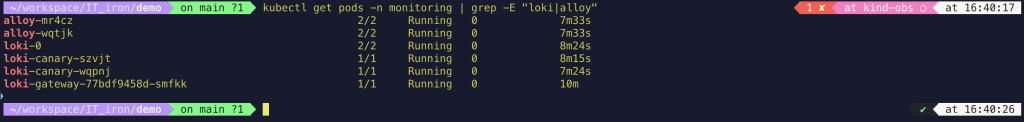
我的叢集有三個節點,但 Alloy 只起了兩個 Pod。原因是 DaemonSet 預設不會排到控制平面節點上(那個節點有 taint,也就是一個「除非你明講否則別排進來」的標記),所以控制平面自己的 log 我現在收不到。示範環境沒差,正式環境要記得加上對應的 toleration。
我沒告訴 Alloy 任何服務的位置,它怎麼知道要收誰的 log?一開始我也困惑,後來發現它根本不去問我的服務。流程是這樣:
/var/log/pods/
DaemonSet 是一種部署方式,保證每個節點剛好跑一份,適合這種跟節點綁在一起的工作。Day 8 裝的 node-exporter 也是 DaemonSet。
設定檔就是在描述這五步。第一段是「去問 Kubernetes 有哪些 Pod」:
discovery.kubernetes "pods" {
  role = "pod"
}
第二段把 Kubernetes 的中繼資料轉成標籤,最後一條規則算出 log 檔的實際路徑:
rule {
  source_labels = ["__meta_kubernetes_namespace"]
  target_label  = "namespace"
}
...
rule {
  source_labels = ["__meta_kubernetes_pod_uid", "__meta_kubernetes_pod_container_name"]
  separator     = "/"
  replacement   = "/var/log/pods/*$1/*.log"
  target_label  = "__path__"
}
剩下三段是讀檔、處理、送出。其中 stage.cri {} 那行是必要的——容器 runtime 寫進檔案的時候會在每一行前面加上自己的時間戳和串流名稱,這個處理器負責把它剝掉,只留下我印的那行 JSON。
所以我拿到的標籤是 namespace、pod、container、app 這幾個,全部來自 Kubernetes 自己的中繼資料,數量少、基數低,剛好符合 Loki 的設計。
不過裝完去查實際有哪些標籤,比我設定的多:
app, container, filename, namespace, pod, service_name, stream
filename 和 stream 是讀檔那一段自動帶上的,service_name 則是 Loki 3 自己補的。加完設定最好回頭查一次 /loki/api/v1/labels,確認沒有多出什麼高基數的東西。
先把 Grafana 打開(另開一個終端機,這行會一直佔著):
kubectl port-forward -n monitoring svc/kps-grafana 3000:80
到 http://localhost:3000,左邊選單 Connections → Data sources → Add data source,找到 Loki 之後要先按 Install,裝完才會出現設定頁,網址填:
http://loki-gateway.monitoring.svc.cluster.local
這串是 Kubernetes 內部的完整服務名稱,格式是 <服務名>.<命名空間>.svc.cluster.local。注意後面沒有接埠號,因為這個 gateway 開在 80。
存檔之後到 Explore 頁面,資料源選 Loki,查詢輸入:
{app="pricing"}
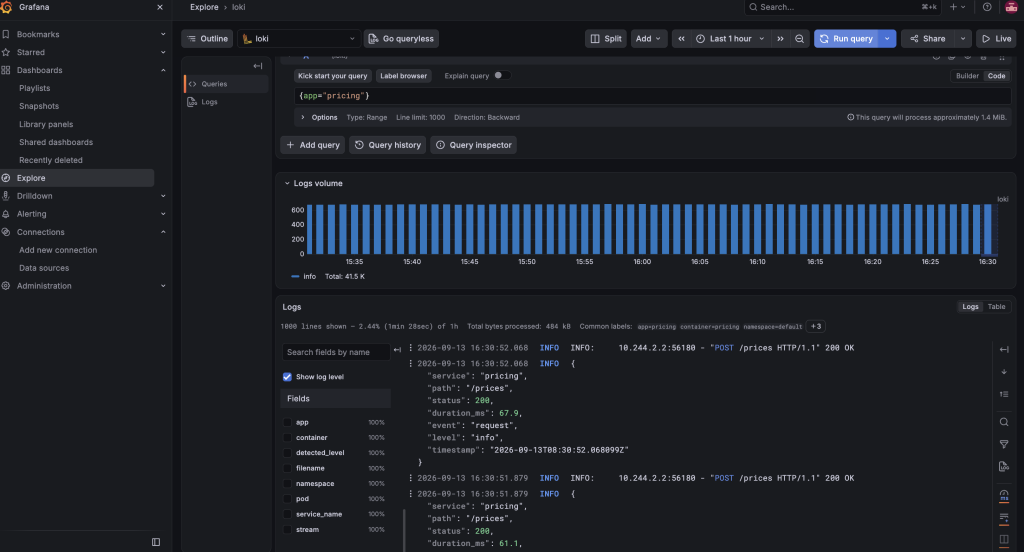
十五天以來第一次,log 不是用 kubectl logs 一行一行捲,而是可以選時間範圍、可以過濾,而且重啟前的還在。Day 7 那句「只有現在,沒有歷史」,這次是 log 那一半被劃掉了。
上面的 Logs volume 是每分鐘的行數,一小時總共 41.5K 行,乘以 24 就是一天快一百萬行。左邊 Fields 那欄列的就是標籤,filename、service_name 那幾個不是我設定的,上一節講過了。下面的 log 本體則是 JSON 跟 INFO: 兩種交錯,Grafana 會自動把 JSON 排版展開,所以看起來比 kubectl logs 舒服很多。
昨天發現我的 log 有一半是 uvicorn 印的純文字,當時我說留著當今天的教材,現在來看它。
先加一個 json 解析器:
{app="pricing"} | json
| json 是把每一行當 JSON 拆開,拆出來的欄位就可以拿來過濾。我原本猜 uvicorn 那些 INFO: 開頭的行會被丟掉,實際去數才發現不是:
| 查詢 | 行數 |
|---|---|
{app="pricing"} |
3,306 |
{app="pricing"} | json |
3,306 |
{app="pricing"} | json | __error__="" |
1,642 |
{app="pricing"} | json | __error__!="" |
1,662 |
{app="pricing"} | json | level="info" |
1,642 |
加了 | json 之後一行都沒少。 解析失敗的那些不會被丟掉,而是被貼上一個叫 __error__ 的標籤留在結果裡,內容是 JSONParserErr。這個設計其實比丟掉好,因為東西還在,你有機會發現。
真正會讓它們消失的是用解析出來的欄位過濾,看最後一列:加上 level="info" 之後剩 1,642 行,跟解析成功的數量一模一樣。那 1,662 行沒有 level 這個欄位,自然不符合條件——沒有錯誤訊息,只有結果變少。
想確認自己有沒有這種破洞,就把解析失敗的撈出來看:
{app="pricing"} | json | __error__!=""
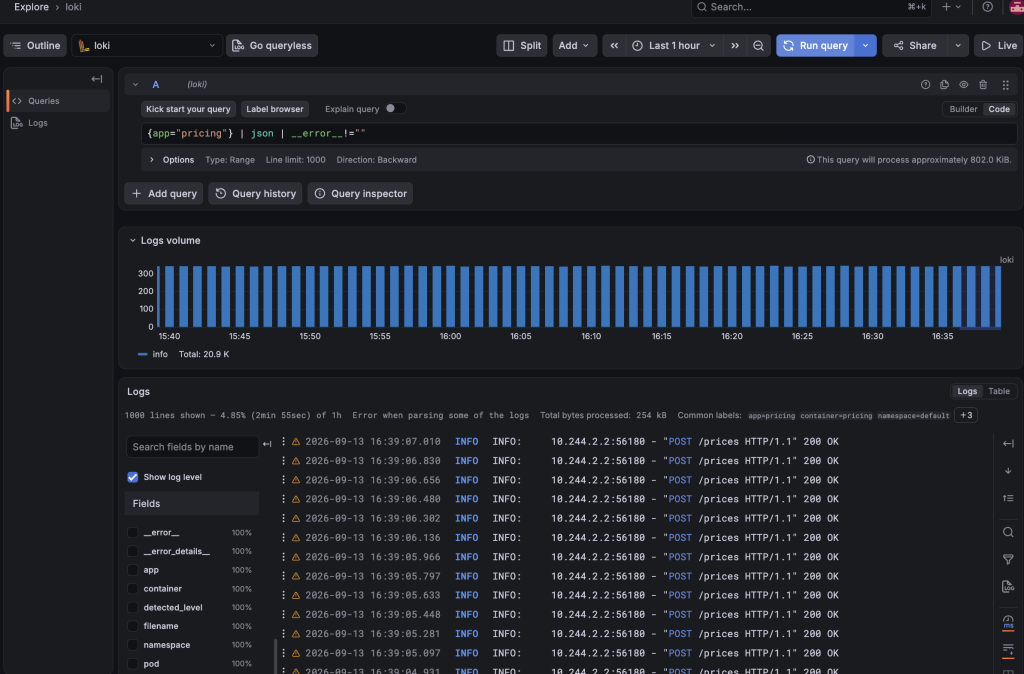
全部都是 uvicorn 的行,每一行前面多了一個警告圖示,左邊欄位清單裡也多了 __error__ 和 __error_details__。一小時 20.9K 行,剛好是總量的一半。
所以昨天那句「要有紀律」的實際後果是這個:那半邊的 log 進得了 Loki,也查得到原文,但參與不了任何按欄位的查詢。
真正要用的時候,過濾條件會是「只看 warning 以上」:
{app="pricing"} | json | level=~"warning|error"
今天故障全關,這行查出來是空的,那是正常的,明天開了故障就會有。但我第一次寫的是 level=~"warn|error",那樣就算開了故障也是空的——LogQL 的 =~ 是整個字串比對,不是包含,而 structlog 印的是 warning 不是 warn,永遠對不上。一樣沒有錯誤訊息,只有 No logs found。
單獨看 log 沒什麼稀奇,Kibana 也做得到。Grafana 的價值在同一個畫面。
Explore 頁面右上角有個 Split 按鈕,按下去畫面會分成左右兩半,各自可以選不同的資料源。左邊選 Prometheus,貼 Day 11 那條 pricing 的 P95 延遲:
histogram_quantile(0.95, sum(rate(http_request_duration_seconds_bucket{job="pricing"}[5m])) by (le))
右邊選 Loki,放 {app="pricing"}。兩邊的時間範圍是連動的——在左邊的圖上框選一段異常時間,右邊的 log 自動跳到同一段。
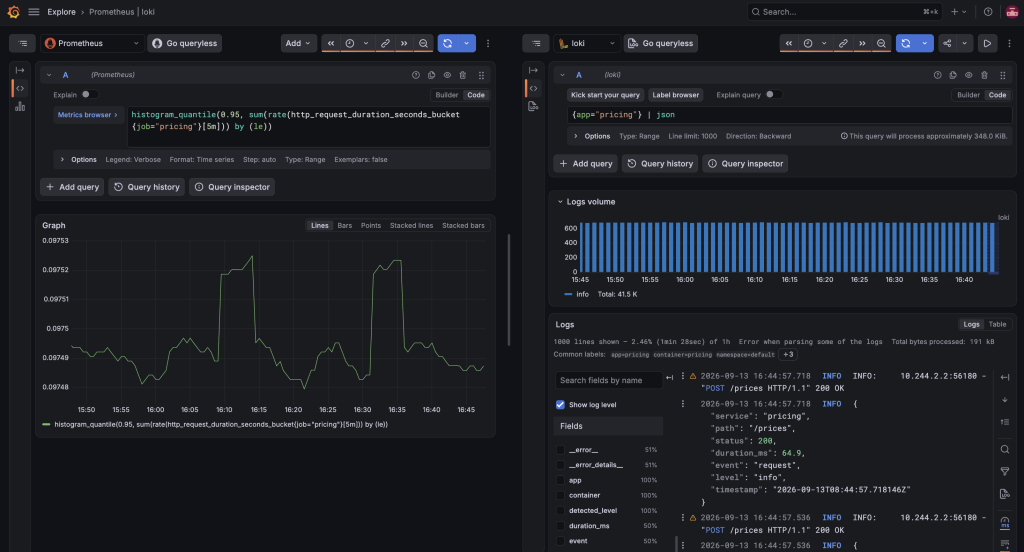
左邊那條線看起來上下很劇烈,但看 Y 軸:0.09748 到 0.09753,整個範圍只有 50 微秒,是 Day 11 講過的自動縮放在放大雜訊,今天故障全關本來就該是平的。右邊 Fields 欄裡 __error__ 那行寫著 51%,duration_ms 和 event 寫著 50%——上一節數出來的一半一半,Grafana 直接幫你算好了。
這個動作看起來很小。但以前我要做的是:看到尖峰、記下時間、切到另一個系統、手動輸入時間、開始找。現在是框一下。Day 3 講三大支柱的時候說過「能不能跳過去」,這就是跳過去。
另一種做法是在同一個 Dashboard 裡,上面放指標圖、下面放 Logs 面板。排版建議上圖下 log,因為視線由上往下——先看到異常,再往下看細節。
兩個實務問題順便講。
保存多久。 本機用預設就好,但要知道 Loki 有保存期限的設定,到期會刪,正式環境這是要認真決定的參數。順帶一提 chart 預設會給 Loki 一個 10 GiB 的 PVC,所以 Pod 重啟資料還在,這點跟 Day 7 的 kubectl logs 不一樣。
log 太多怎麼辦。 上面量到 pricing 一小時 41.5K 行,一天就是一百萬行,而這只是三個服務裡的一個。現在規模還好,但要記得:log 的成本跟流量成正比,metrics 不會。 流量翻十倍,log 的量就翻十倍,而 http_requests_total 還是那幾條序列。「每筆請求印一行」在示範環境沒問題,正式環境就要考慮取樣。
--version,這個 chart 的參數改過太多次| json 不會丟掉非 JSON 的行,是貼上 __error__ 標籤;真正讓它們消失的是後面按欄位過濾那一步明天是 Logs 區塊的最後一天,也是這個系列第一次破案:用 LogQL 把 Day 6 埋的第一個故障挖出來。


 iThome鐵人賽
 看影片追技術