
Math.max(0, ...) 被我算成同一個錯法的證據,實際是兩件事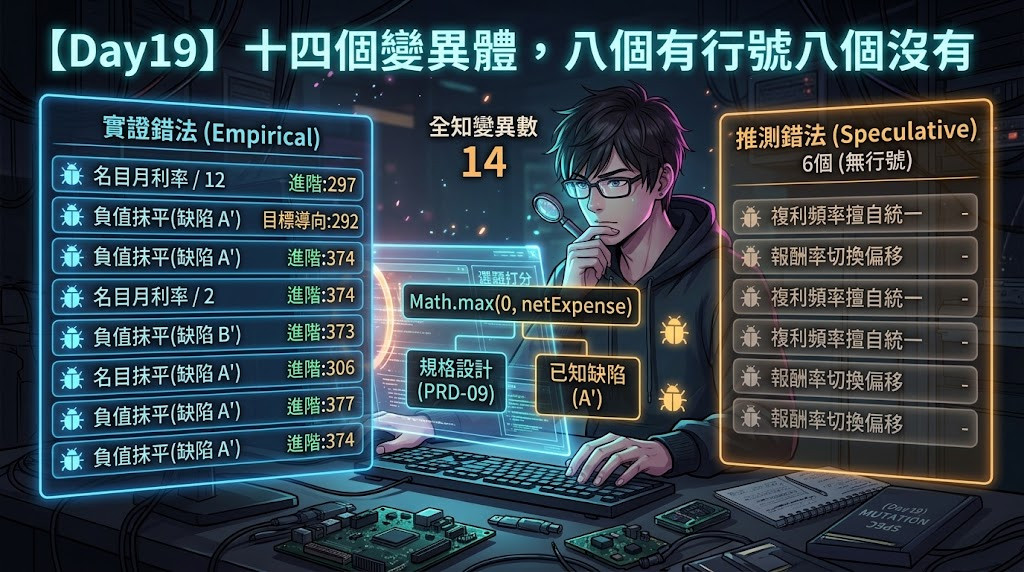
昨天那臺引擎過了校準,可以上工了。但它要注入什麼?
這是第四塊拼圖,也是唯一一塊決定分母的。變異分數是「殺掉的 ÷ 有效變異體總數」,分母就是這份目錄:目錄裡沒有的錯法,分數永遠不會告訴你。一份只放了三個荒謬變異體的目錄,可以讓任何測試套件拿到 100 分。
所以今天不寫程式,寫清單。而清單最重要的欄位不是「改哪一行」,是「憑什麼相信這種錯法會發生」。
十四個變異體分兩層,判準很簡單:能不能指出它在真實程式碼裡的位置。
去年那批用 AI 協作寫出來的退休試算工具不只一支。手上有四個檔案可以互相對照:進階退休規劃試算、目標導向退休金回推試算器、整合月複利退休回推計算機,以及 Day 15 當過對照組的退休金缺口計算機。同一個錯法在四個檔案裡重複出現,就不是手滑,是習慣。
兩個跨檔案的實證:
| 錯法 | 出現位置 | 合計 |
|---|---|---|
年報酬率 / 12 直接當月利率 |
進階 297;目標導向 292、316、374;整合月複利 217、262、287 | 3 檔 7 處 |
Math.max(0, ...) 把負值抹平 |
進階 320、363、374;目標導向 274;對照組 438 | 3 檔 5 處 |
七處與五處,每一處都是獨立寫出來的。這種重複才是設計變異體的正當理由:不是「我覺得這裡可能會錯」,而是「這裡已經錯了七次」。
Math.max,其實是兩件事第二列的五處,我原本整組掛在缺陷 A'(負餘額被夾 0 遮蔽赤字)名下。逐行打開才發現分錯了:
// 進階 320、363|目標導向 274
const netExpenseForYear = Math.max(0, inflatedAnnualExpense - inflatedAnnualIncome);

// 進階 374|對照組 438
assetData.push(Math.max(0, remainingFund));
values: chartData.values.map(v => Math.max(0, v))
上面三處是淨支出截斷:收入大於支出的年份,淨支出歸零、盈餘不滾存。那是 Day 9 閘門一裁決過、PRD-09 刻意保留的行為:它是規格,不是缺陷。
下面兩處才是缺陷 A':真實餘額已經是負的,圖表把它畫成 0。
同一個寫法 Math.max(0, x),一個是規範內的設計決定,一個是遮蔽事實。把五處算成同一個錯法的證據,會讓 M02 這個變異體看起來有五處背書,實際只有兩處。grep 數得出次數,數不出語意,這是建目錄時最容易偷的懶。
修正後拆成兩個變異體,證據各自歸位:M02 拿圖表那兩處,M05 拿淨支出那三處。
基底是 shadow/calc_fixed.py(PRD v1.2 的實作),不是有缺陷的影子模型。
| ID | 改什麼 | 模擬哪一種錯法 | 證據 |
|---|---|---|---|
M01 |
折現指數 idx → idx + 1 |
期初年金變期末,低估目標金額(缺陷 A) | 實證・第一幕實測 |
M02 |
餘額軌跡加回 max(0.0, ...) |
圖表遮蔽晚年赤字(缺陷 A') | 實證・2 檔 2 處 |
M03 |
名目月利率 → 有效月利率 | 比規格更「正確」的偏離:測試若殺不死,代表沒綁住 PRD-01 的數值定義 | 實證・3 檔 7 處 |
M04 |
本金退回年複利 | 擅自統一複利頻率,推翻 PRD-01 的雙頻率裁決 | 推測 |
M05 |
移除淨支出截斷 | 允許盈餘滾存,推翻 PRD-09 裁決 | 實證・2 檔 3 處 |
M06 |
提領期上界改為含大筆支出年齡 | 身故後的幽靈扣款(缺陷 C) | 實證・第一幕實測 |
M07 |
大筆支出配對 == → >= |
修缺陷 C 時的二次事故:連年重複扣款 | 推測 |
M08 |
移除 retirement_age < life_expectancy 校驗 |
壽命倒掛放行(缺陷 B) | 實證・自然實驗 |
M09 |
移除金額負值校驗 | 非法輸入靜默通過(缺陷 D) | 實證・第一幕實測 |
M10 |
通膨基準年 t - A_c → t - A_c - 1 |
索引差一 | 推測 |
M11 |
提領首年誤用退休前報酬率 | 報酬率切換點偏移 | 推測 |
M12 |
起領年齡 >= → > |
邊界嚴格化,首年年金漏計 | 推測 |
M13 |
大筆支出不計通膨 | 幣值混淆:今日幣值當成未來金額 | 推測 |
M14 |
退休後收入不隨通膨調升 | 實質購買力被高估 | 實證・退化型 |
實證八個,推測六個。
M03 值得停一下。它把 r / 12 改成 (1 + r)^(1/12) - 1,後者在金融上更嚴謹,是某些同類工具的實際做法。這個變異體不是在模擬「寫錯」,是在模擬「寫得比規格更好」。如果測試殺不死它,代表那些斷言綁的是「大概對的數量級」,不是 PRD-01 那條白紙黑字的定義。
M08 的證據是一次自然實驗:同一套 AI 協作流程產出的四個檔案裡,對照組寫了 expectedLifespan <= retirementAge 的防呆,受測物整份 isNaN 與 alert 各出現 0 次。同一個模型、同一個人、差別只在那一行有沒有寫。
M14 是反方向的:受測物第 355 行 otherIncome * 12 * Math.pow(1 + inflationRate, yearsFromNow) 把通膨算對了。這個變異體是把做對的改壞,驗的是測試守不守得住已經正確的行為。
十四個變異體寫完,先跑兩道機械檢查再交給引擎:
片段唯一性:14 / 14 通過
變異後語法:14 / 14 可編譯
第一道是昨天那條規矩:目標片段必須在原始碼裡剛好出現一次。零次代表定義過期(程式碼重構過而目錄沒跟上),兩次代表會默默改錯地方。
第二道是把每個變異後的副本丟給 ast.parse。這一步不是為了好看:昨天校準的必錯組證明了語法錯誤的變異體在壞掉的引擎上會回報「測試沒抓到它」。事前篩掉,比事後從 ERROR 堆裡挑出來乾淨。
兩道都過,不代表變異體設計得好,只代表它們跑得起來。設計得好不好,要等分數出來、再逐個驗屍才知道。
寫這份目錄最花時間的不是想錯法,是查行號。
Math.max(0, x) 那五處,grep 三秒就數出來,但要知道它們分別在做什麼,得把四個檔案的那幾行一行一行打開讀。讀完發現三比二:三處是規格,兩處是缺陷。
如果我沒讀,M02 這個變異體會帶著「跨 3 檔 5 處」的背書進目錄。它看起來會非常有說服力:五處獨立出現的同一個寫法,誰還會懷疑?而一個被高估的證據,比一個誠實的推測危險得多:後者我會保持警覺,前者我會直接相信。
這份目錄不能拿來做什麼
十四個不是窮舉,是我想得到的十四個。實證那八個證明「這種錯法發生過」,不證明「這是最常發生的八種」。
推測那六個沒有任何案例背書。它們存在的理由是精算邏輯上說得通,而那是我的判斷,不是資料。
分子與分母都出自同一個人:變異體是我設計的,測試也是我或 AI 寫的。同一個盲區會同時出現在兩邊:目錄裡沒有的錯法,測試大概也沒有守。這個結構性限制無法靠增加變異體數量解決。
只帶走一件事
變異分數的分母是一份人寫的清單。
它量得出「你設計的錯法有幾種被守住」,量不出「你沒想到的錯法有幾種」。
明天把這十四個注進去,看那套測試守得住幾個。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day19


 iThome鐵人賽
 看影片追技術