
昨天建立了變異測試的觀念與公式,今天要造那臺引擎。沒有校準過的引擎,跑出來的分數不能信。這是第三塊拼圖。
不用 mutmut 或 cosmic-ray,理由不是它們不好,是本系列要的變異體每一個都得說出自己模擬哪一種真實的金融錯法,那是人設計的目錄,不是工具窮舉出來的。
自建一臺專用的輕量引擎,單檔百行以內。但自建的 harness 如果判定邏輯寫錯一行,整套變異測試就是偽證。
harness 架構有兩件事不能退讓。
有些做法在 calc_fixed.py 裡塞 if os.getenv("ACTIVE_MUTANT") == "M01": ...,我不建議這樣。那是把變異體當分支埋進已驗收的資產。做法是 mutant 以 (original, mutated) 文字對描述,harness 每次建暫存目錄,複製過去替換,用完即刪。原始檔零污染。
程式碼置換有兩個容易踩到的陷阱:
一是要複製整個專案目錄,不能只複製單一檔案。
因為 tests/test_checklist.py 的開頭寫著 sys.path.insert(0, str(ROOT / "shadow")),這會把本機真正的 shadow/ 目錄強制排在載入路徑的最前面。如果只把變異後的單一檔案丟進暫存目錄,靠 PYTHONPATH 載入,優先權搶不過這行寫死的路徑,測試會載入到未變異的原始檔案,結果就是每一個 mutant 都回報 SURVIVED,分數恆為 0%,而且完全不會報錯。因此,harness 必須將整個專案結構複製一份到暫存目錄中執行,讓 ROOT 自然指向這個副本。
二是替換的程式碼片段必須唯一。
因為 replace(..., 1) 只會替換第一個符合的字串,如果目標片段在檔案裡出現兩次,就可能會默默改錯地方。因此,只要片段出現的次數不等於 1,harness 就中止。
為避免無窮迴圈卡死測試,變異體會在獨立子行程中執行並設定逾時。但拿到結果後,判定邏輯卻是最容易翻車的地方:
# ✗ 致命錯誤
if proc.returncode != 0:
    return Verdict.KILLED
pytest 的回傳碼有精確的語意:
0 = 測試全數通過 → SURVIVED
1 = 有斷言失敗 → KILLED
2 到 5 = 語法錯誤或中斷 → ERROR,不計入分數
如果寫成「非 0 即殺」,因語法錯誤而掛掉的 mutant(回傳碼 2)就會被灌水成擊殺。但這其實是直譯器的功勞,跟我們的測試套件無關。
教科書中的變異分數公式假設變異體永遠編譯得過,所以分母只有 (總數 − 等價)。但在實務上,我們必須把這些「根本沒考成」的無效考卷從分母扣除:
變異分數 = 殺掉的 ÷ (總數 − 等價 − ERROR) × 100%
其中,equivalent(等價變異體)由人工標記,而 ERROR 則由回傳碼客觀決定。
def run_tests(root_copy, rel_tests, timeout_sec=30.0) -> Verdict:
    """在副本裡執行,讓測試檔自己的 ROOT 解析到副本的 shadow/。"""
    cmd = [sys.executable, "-m", "pytest", rel_tests,
           "-q", "-p", "no:cacheprovider"]
    try:
        proc = subprocess.run(cmd, cwd=root_copy, timeout=timeout_sec,
                              capture_output=True, text=True)
    except subprocess.TimeoutExpired:
        return Verdict.TIMEOUT
    # 回傳碼有精確語意,不能用「非 0 即殺」
    return {0: Verdict.SURVIVED,
            1: Verdict.KILLED}.get(proc.returncode, Verdict.ERROR)
cwd=root_copy 的意義就是上一節整棵樹鏡射的理由,最後那行 dict.get 則是「非 0 即殺」的解藥:沒有列在字典裡的回傳碼一律 ERROR,不計入分數。
其餘的置換、鏡射、計分都在 tools/harness.py。
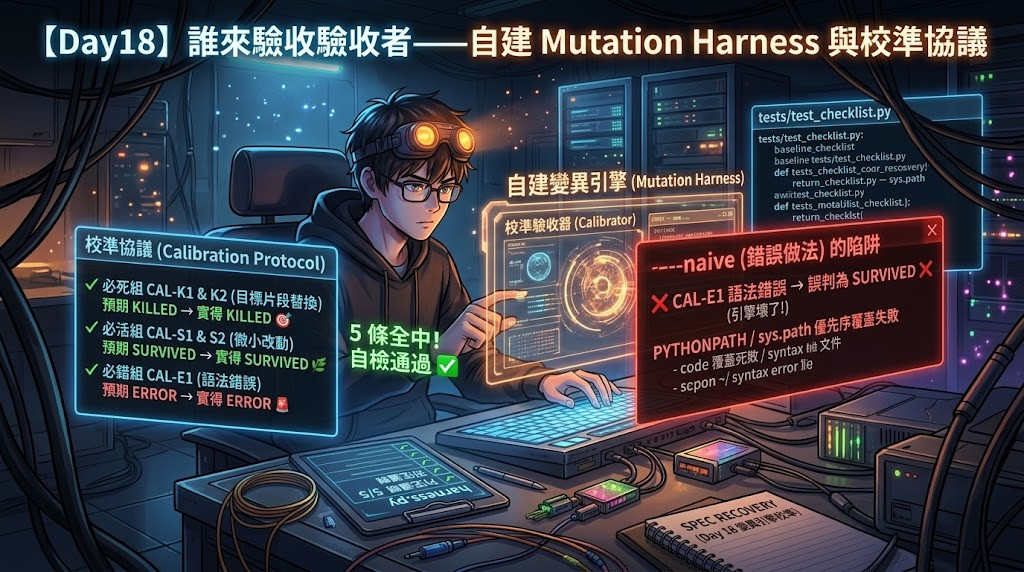
在讓 harness 處理真正的程式碼之前,我們必須先用一份「已知答案的考卷」進行校準。這份考卷與及格標準在執行前就已寫死,不容妥協。
| 變異分組 | 變異方式 | 預期結果 | 結果不符,代表什麼? |
|---|---|---|---|
| 必死組 | 數值乘 0、或設定為負數 | KILLED | 踩到 sys.path 陷阱,載入到未變異的原始檔案。 |
| 必活組 | 加上 + 0.0 或修改註解 |
SURVIVED | 測試環境有快取殘留,或是測試的斷言寫得太脆弱。 |
| 必錯組 | 刻意製造語法錯誤(SyntaxError) | ERROR | 踩到「非 0 即殺」陷阱,把語法錯誤灌水成擊殺。 |
這五條校準題目必須 100% 命中預期,harness 才算及格上線。如同 Day 12 提到的已知答案測試(KAT)原則,這份考卷必須人工撰寫,不能交給 AI,以確保驗證工具本身的可靠性(完整程式碼見 calibration_mutants.py)。
跑出來的結果如下:
13 passed in 0.02s
基準線:未變異時 tests/test_checklist.py 全綠
  ✓ 必死組 CAL-K1 預期 killed   實得 killed
  ✓ 必死組 CAL-K2 預期 killed   實得 killed
  ✓ 必活組 CAL-S1 預期 survived 實得 survived
  ✓ 必活組 CAL-S2 預期 survived 實得 survived
  ✓ 必錯組 CAL-E1 預期 error    實得 error
五條全部命中預期,harness 列裝。
請注意第一行的 13 passed,這不是裝飾品。在執行變異測試前,必須先確認「未變異的原始碼能順利通過所有測試(基準線全綠)」。如果不做這項檢查,萬一環境根本沒裝 pytest,所有測試都會直接回傳 ERROR,反而會讓「必錯組」假性命中預期。這條檢查是 Day 14 那支變異工具的 _assert_baseline() 換個地方再寫一次:它不產生任何分析結果,存在的唯一理由是讓工具在什麼都沒做的時候閉嘴。
為了驗證這套校準協議的價值,harness.py 保留了一個 --naive 開關。只要加上這個參數,引擎就會退回上一節的錯誤做法:只置換單一檔案、測試檔留在原專案,並單純依賴 PYTHONPATH 載入。
用同一份考卷再跑一次:
  ✗ 必死組 CAL-K1 預期 killed   實得 survived
  ✗ 必死組 CAL-K2 預期 killed   實得 survived
  ✓ 必活組 CAL-S1 預期 survived 實得 survived
  ✓ 必活組 CAL-S2 預期 survived 實得 survived
  ✗ 必錯組 CAL-E1 預期 error    實得 survived
校準未通過(3 條不符),harness 不列裝。
會發現有三題不符預期,而且錯得非常一致:結果全都變成了 SURVIVED。
其中最荒謬的是最後一行的 CAL-E1。這是一個少了一個右括號、根本連編譯都過不了的變異體,但在這個錯誤的架構下,它居然「存活」了。為什麼?因為變異的副本根本沒有被載入,pytest 跑的完全是未變異的原始檔案,所以測試全數通過(回傳碼 0)。這個驗證引擎等於是在幫一個從未發生過的實驗背書。
如果這時候直接去跑正式的變異測試,拿到的會是 0 分,而那個 0 分很容易被讀成「AI 寫的測試爛透了」。危險不在分數難看,在歸因:把工具的故障記在受測物頭上。
回頭看必活組,它在兩輪都是 SURVIVED,在失敗做法下也「命中預期」。光靠會通過的測項,驗不出引擎有沒有在做事,必死組才是那個會叫的,三組缺一不可。
引入變異測試來評估 AI,就像是請了一位極度嚴苛的考官。但在此之前我們必須先問:考官本身的標準準確嗎?
AI 不會為自己辯護。如果你的驗證引擎發生靜默故障(例如踩到 sys.path 陷阱,變異分數恆為 0),AI 不會告訴你「是工具壞了」,它只會不斷道歉,然後把原本寫對的測試改得面目全非。
這就是為什麼「校準協議」如此重要。我們不能在量尺歪掉的時候,把責任全推給受測的 AI。在開始指責 AI 寫的測試很爛之前,先跑一次這五題校準變異體,確認你的檢驗工具本身是值得信任的。
「五條全中」不能代表什麼?
--naive 故障是我刻意設計的,而非野外採集的真實樣本。它只為了證明故障可以是靜默的,不代表別人的專案用「單檔置換」就一定會踩坑。SyntaxError。關於回傳碼 3、4、5(內部錯誤、用法錯誤、沒收集到測試)這三條例外路徑,目前都還沒有對應的校準變異體走過。只帶走一件事
一臺沒被校準過的引擎,會把自己的故障寫成受測物的成績,而必死組是唯一會在它空轉時舉手的那一組。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day18


 iThome鐵人賽
 看影片追技術