
上一篇在探索 HAM10000 時,我們發現了一個很明顯的問題:7 種病灶類別的圖片數量並不平均,其中有些類別擁有數千張圖片,有些類別卻只有幾百張。這也代表模型在學習時,「看到」不同類別的機會並不相同。
既然我們已經知道這個問題存在,今天就不再只是觀察資料,而是進一步來看看:Class Imbalance 到底會怎麼影響模型?又有哪些方法可以處理?
上一篇已經畫出了各類別的分布圖,最多的 nv 有 6,705 張,而最少的 df 只有 115 張,兩者相差大約 58 倍,所以問題已經不只是「每類數量不太一樣」,而是模型實際看到 nv 的機會遠高於 df,它自然有更多機會學習 nv 的特徵,而少數類別能提供模型學習的範例就少得多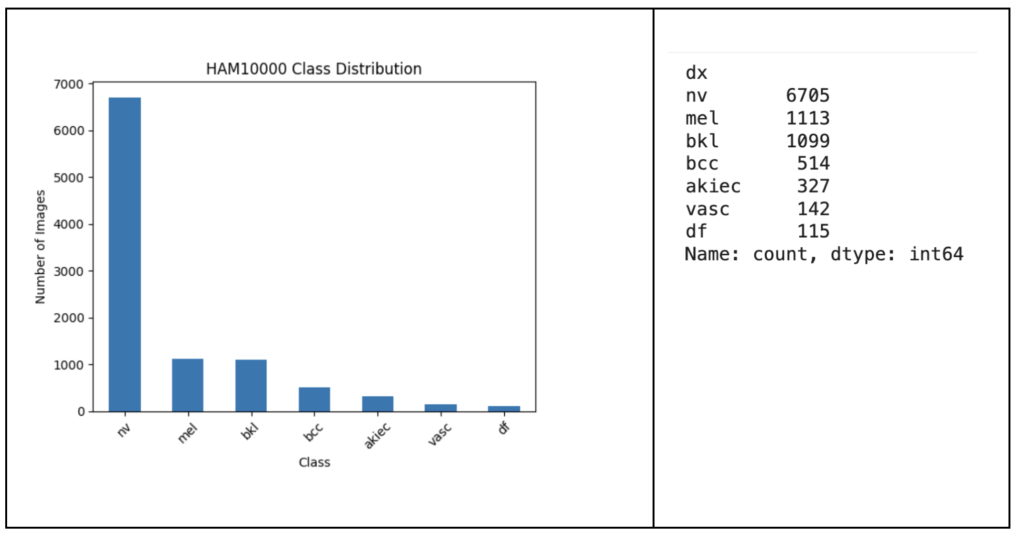
既然 nv 太多,一個很直覺的想法就是:「那我把 nv 刪到跟其他類別差不多不就好了?」,這種方法稱為 Undersampling(欠採樣)
例如原本nv有6705張、df有115張,我們可以從 nv 中只挑一部分圖片進行訓練,好處是各類別之間的差距可以縮小,但缺點也很明顯,我們明明有 6,705 張 nv,卻主動把大量真實資料丟掉了
這些被刪掉的圖片可能包含不同角度、顏色或外觀特徵,因此在資料本來就不算非常充足的情況下,不一定希望直接捨棄大量資料
另一個方向剛好相反,既然少數類別太少,那就增加它們在訓練時出現的機會,這稱為 Oversampling(過採樣)
複製相同類別的圖片,這樣模型在訓練時就能更常看到 df,但單純一直複製相同圖片也會造成問題,因為重複複製10次同一張圖片並不代表我們真的取得了 10 張不同的新圖片,模型反覆看到完全相同的資料,反而可能更容易記住這些圖片,而不是學到可以泛化的特徵
除了直接複製圖片之外,我們還可以對原始圖片進行一些合理的變化,例如:旋轉、翻轉、平移、縮放
這就是之後會介紹的 Data Augmentation(資料增強),它並不是憑空創造新的病人或新的病灶,但可以增加訓練時影像呈現方式的變化,Data Augmentation 在影像模型中非常常見,之後我們會再實際動手做
除了前面描述的兩種方式外,還有另外一種思路是讓圖片數量保持不變,但模型猜錯少數類別時,讓它付出更大的代價,這就是 Class Weight(類別權重) 的概念
假設nv資料很多、df資料很少,我們可以在訓練時給 df 較高的權重,如此一來,模型如果把少數類別判斷錯誤,計算 Loss 時會受到較大的影響
我們可以簡單理解成:
這樣不需要直接刪除 nv,也不需要大量複製 df,而是從模型訓練時的「錯誤成本」進行調整
目前我們介紹了三個方向: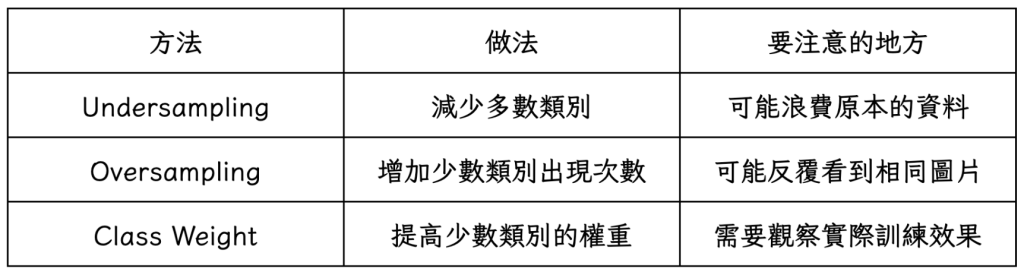
另外還有前面提到的 Data Augmentation,可以增加圖片在訓練時的變化,但這裡沒有一個「所有 Dataset 都一定最好」的方法,我們之後真正建立 HAM10000 模型時,可以透過實驗比較不同做法,而不是現在直接認定某一種方法最好
上一篇我們發現了 Class Imbalance,今天則進一步了解可以從哪些方向處理這個問題,不過在把圖片交給模型之前,我們還需要決定一件非常重要的事情「哪些圖片給模型學?哪些圖片不能讓模型提前看到?」,而且 HAM10000 中,同一個病灶還可能有不只一張照片,如果資料切分錯誤,就可能發生模型「考試前已經看過類似考題」的情況


 iThome鐵人賽
 看影片追技術