
昨天的 Stack 把最後放進去的先拿出來,今天要介紹的 Queue 則是完全相反的那一種:最先放進去的最先拿出來。
先來看一個情境~假設辦公室裡有一台印表機,三個人幾乎在同時按下列印,而印表機一次只能印一份。這時候印出來的順序應該要照按下列印的先後,先按的先拿到,否則先按的人可能一直被後來的插隊,永遠等不到自己那一份。
把這件事寫成程式,最直覺的版本大概是這樣:
const jobs = [];

jobs.push('第一份文件');
jobs.push('第二份文件');
jobs.push('第三份文件');

while (jobs.length > 0) {
  sendToPrinter(jobs.shift()); // 把一份文件送去印表機
}
這段程式沒什麼問題,push 把新的工作接在後面,shift 從最前面拿走一份,先按列印的就先印出來,順序完全正確。既然如此,還有什麼好介紹的呢?今日主題似乎可以結束了(?
這裡可以探究的問題不在順序,而是成本。之前介紹 Array 四種操作時提過,shift 是 O(N),因為移除開頭之後,後面每一格都得往前補。列印工作只有 3 份的時候可能看不出差別,但如果這條隊伍隨時有上千份工作在等,每印一份就要把後面的工作全部往前挪一次。那有沒有一種存法,可以維持先來先印的順序,卻不必每取出一份就把後面的全部往前挪呢?這解法就稱為 Queue,今天就來看看~
先給 Queue 一句話的定義:
Queue(佇列)是一排有順序的資料,只能從一端加入、從另一端取出,所以最先放進去的那一個,會最先被拿出來。
Queue 最常見的比喻就是排隊。假設現在請那些要使用印表機的三個人站成一列,最先來的站在最前面,也最先拿到文件,後來的人只能接在隊伍尾巴。
不過這比喻和實際的 Queue 仍有差距,真實的隊伍裡有人可以插隊、也有人等太久就走掉,而 Queue 不允許這兩件事,資料只會從固定的一端進、從固定的另一端出。
最先放進去的最先被拿出來,這個順序稱為 FIFO(First In, First Out,先進先出)。隊伍最前面那個位置叫 front,最後面叫 back,加入永遠發生在 back,取出永遠發生在 front。看一下 Queue 可能有的操作:
| 操作 | 做的事 |
|---|---|
enqueue |
把一個新的接在 back,它成為新的隊尾 |
dequeue |
把 front 那個拿走並回傳它 |
peek |
看一下 front 是什麼,但不拿走 |
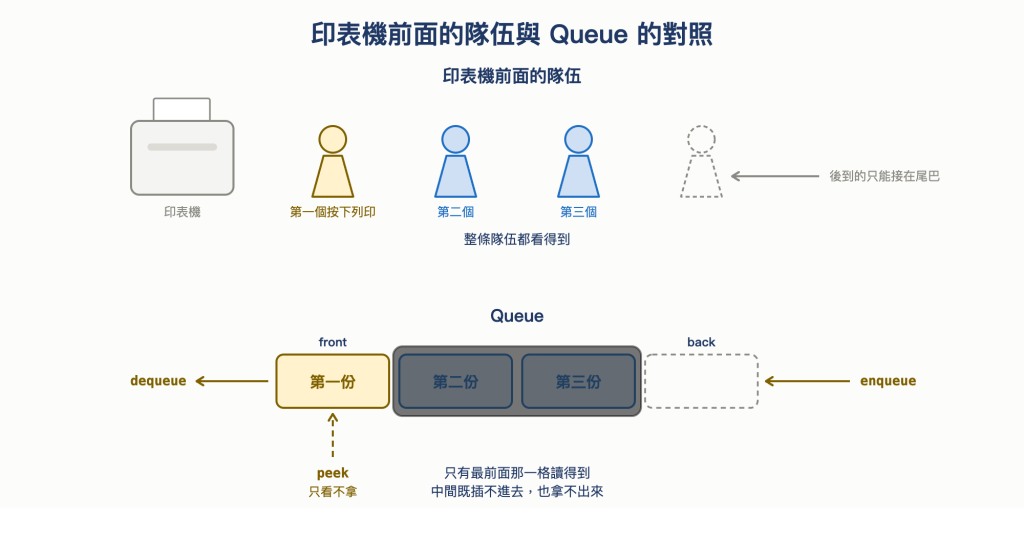
圖 1 印表機前面的隊伍與 Queue 的對照:三個操作都只碰兩端,中間那些工作只能等
比較 Stack 和 Queue,差別如下:
| Stack | Queue | |
|---|---|---|
| 順序 | LIFO,最後進的先出 | FIFO,最先進的先出 |
| 開口 | 一個,push 和 pop 都在 top |
兩個,enqueue 在 back、dequeue 在 front |
| 適合的問題 | 只在乎最近加入的那一個 | 必須照抵達的先後處理 |
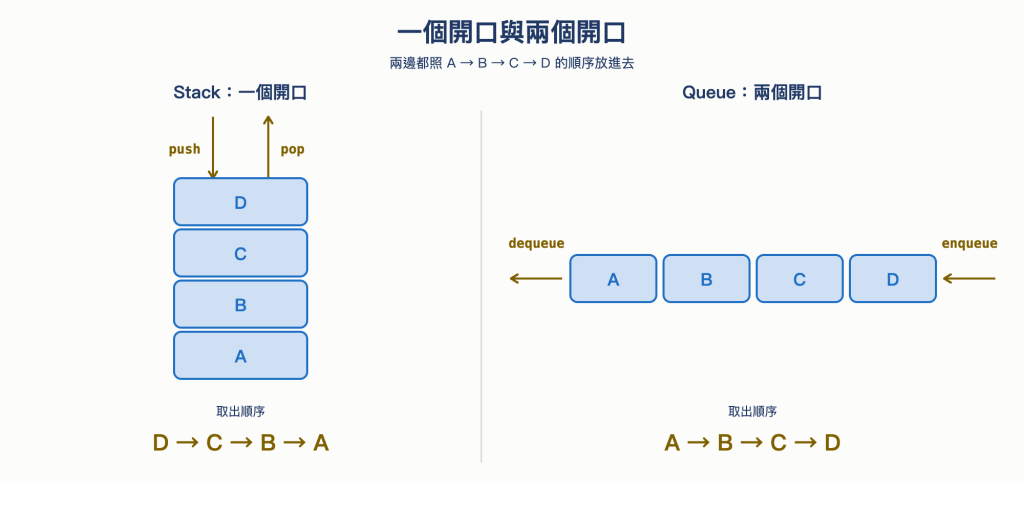
圖 2 一個開口與兩個開口:同一批資料放進去,取出的順序剛好相反
至於「某個值在不在裡面」這種 lookup,Queue 和 Stack 一樣沒有提供,真的要做的話,只能一個一個 dequeue 出來看,成本是 O(N)。Queue 在乎的只有隊伍的兩端,中間那些對它來說是還沒輪到的工作,不是可以隨機翻找的內容。
O(N)之前有整理過 Array 四種操作的成本,結論是動尾端的成本較低、動開頭的成本較高,因為 index 必須連續,開頭一動,後面每一格都得跟著換位置,而 shift 正好屬於後者。
昨天的 Stack 沒有這個困擾,因為它的兩個操作都在同一端,可以整組都挑成本較低的那一端來當 top。Queue 就沒有這個自由了,它必須一端進、另一端出,因此只要底層是 Array,就一定有一端會落在 O(N) 那邊。
那把隊伍的方向反過來不就好了嗎?用 unshift 從開頭加入、用 pop 從尾端取出,先進先出的順序一樣成立。這樣確實還是 FIFO,但 O(N) 那一端只是換了個位置,unshift 得把原本所有元素往後挪一格才空得出第 0 格,於是 enqueue 從 O(1) 變成了 O(N),整體並沒有比較好。換句話說,只要底層是 Array,進出兩端裡一定有一端得搬動全部的元素,能選的只有把成本高的留在放進去的時候,還是取出來的時候。
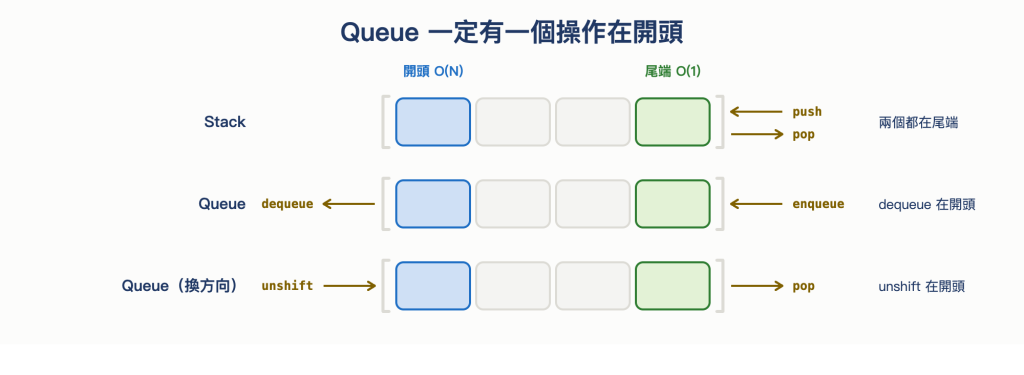
圖 3 Queue 一定有一個操作在開頭
補充:V8 的
shift不一定真的搬資料上面說的是 Array 這個結構的性質,而實際跑起來,V8 對
shift還留了另一條路。如果移除後還剩超過 100 個元素,而且那塊記憶體允許移動起點,V8 會改成把 backing store 的起點往後挪一格,資料一格都不動(原始碼在
elements.cc的RemoveElement)。不過那兩個前提都不是在 JavaScript 這一層能決定的,而且它是引擎的最佳化、不是
Array.prototype.shift的規範保證,換一個引擎就不一定有,因此後面仍然以O(N)來討論。
昨天介紹過抽象資料型別(ADT),它只規定資料能做哪些操作,不規定資料實際上怎麼存。Queue 也是 ADT,它要求的只有三件事:
前言那段處理列印工作的程式挑了 Array 來實作,而 Array 剛好不擅長從開頭移除,那屬於實作選擇上的成本,不是 FIFO 的成本。換句話說,「Queue 的 dequeue 是 O(1)」這句話單獨拿出來看是沒有意義的,需要接著問底下用什麼儲存或實作。
談到實作,接下來就來看看 Queue 的實作方式吧~
既然成本出在搬移東西,那有沒有辦法不要搬呢?
資料之所以要往前挪,是因為 Array 版本預設隊伍的第一個永遠放在第 0 格。如果不再堅持這件事呢?改成另外記一個數字表示現在隊伍第一個在哪,dequeue 就只要把那個數字往後加一:
class HeadIndexQueue {
  constructor() {
    this.items = {};
    this.head = 0;
    this.tail = 0;
  }

  enqueue(value) {
    this.items[this.tail] = value;
    this.tail++;

    return this;
  }

  dequeue() {
    if (this.isEmpty()) return undefined;

    const value = this.items[this.head];

    delete this.items[this.head];
    this.head++;

    return value;
  }

  peek() {
    return this.items[this.head];
  }

  isEmpty() {
    return this.head === this.tail;
  }
}
head 和 tail 是兩個號碼牌,head 記著下一個要被取出的位置,tail 記著下一個要放進去的位置,兩個相等就代表隊伍是空的。這裡的 items 用物件而不是陣列,理由是 head 只會往前走、不會回頭,取出過的位置會一路留在後面,如果用陣列再配上 delete,那些位置就會變成洞,而之前提過有洞的陣列,在 V8 會掉進比較慢的那一類。
用這版本的程式走一次前言那三份列印工作:
| 動作 | items |
head |
tail |
|---|---|---|---|
| 起點 | {} |
0 | 0 |
enqueue('第一份文件') |
{ 0: 第一份 } |
0 | 1 |
enqueue('第二份文件') |
{ 0: 第一份, 1: 第二份 } |
0 | 2 |
enqueue('第三份文件') |
{ 0: 第一份, 1: 第二份, 2: 第三份 } |
0 | 3 |
dequeue() 拿到第一份 |
{ 1: 第二份, 2: 第三份 } |
1 | 3 |
dequeue() 拿到第二份 |
{ 2: 第三份 } |
2 | 3 |
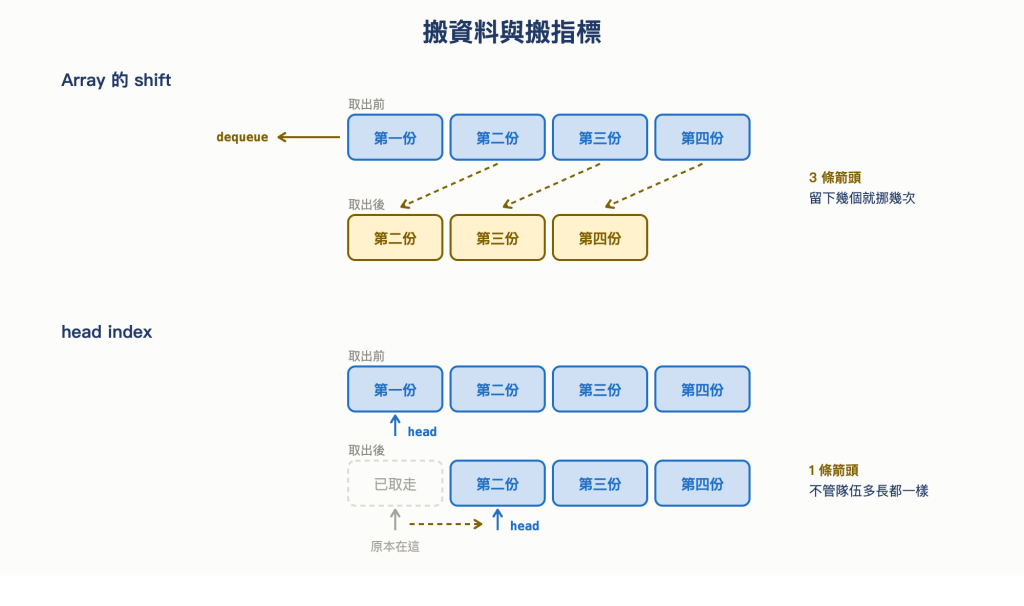
圖 4 搬資料與搬指標
三個操作都只是讀寫一個位置、再把號碼牌加一,因此 enqueue、dequeue、peek 全都是 O(1)。
不過這有個前提,head 和 tail 都只會往上加、不會回頭,這條 queue 進出很多次之後,那兩個數字會一直長大。資料本身有被 delete 清掉,記憶體不會跟著累積,但號碼牌會越來越大。如果需要的是一條長期存在、進出頻繁的 queue,通常會改用固定大小的環狀緩衝區(circular buffer),讓兩個號碼牌走到盡頭之後用取餘數的方式繞回開頭,重複使用前面那些空出來的位置。不過這樣一來容量就固定了,滿的時候得決定放不進去的工作要怎麼處理,有興趣的話可搜尋「circular buffer」關鍵字了解更多~
再換一種實作看看,Day 09 建立的那個 LinkedList 同時記著 head 和 tail 兩個入口,昨天也拿它當過 Stack 的底層,而它其實更適合拿來做 Queue。
先把這個 Queue 會用到的部分列出來:
class Node {
  constructor(value) {
    this.value = value;
    this.next = null;
  }
}

class LinkedList {
  constructor() {
    this.head = null;
    this.tail = null;
    this.length = 0;
  }

  append(value) {
    const newNode = new Node(value);

    if (this.tail === null) {
      this.head = newNode;
      this.tail = newNode;
    } else {
      this.tail.next = newNode;
      this.tail = newNode;
    }
    this.length++;

    return this;
  }

  remove(index) {
    if (index < 0 || index >= this.length) return null;

    if (index === 0) {
      const removed = this.head;

      this.head = removed.next;
      if (this.head === null) this.tail = null;
      this.length--;

      return removed.value;
    }

    // index 大於 0 的情況要先走訪到前一個 node,完整版本在 Day 10
  }
}
remove 這裡只留了 index === 0 那一段,因為 Queue 永遠只從 front 取出,也就是永遠只會呼叫 remove(0),走訪那一段不會被跑到。Queue 本身則是把兩個操作各自接到這條 list 的一端:
class LinkedListQueue {
  constructor() {
    this.list = new LinkedList();
  }

  enqueue(value) {
    this.list.append(value);

    return this;
  }

  dequeue() {
    return this.list.remove(0);
  }

  peek() {
    return this.list.head === null ? undefined : this.list.head.value;
  }

  isEmpty() {
    return this.list.length === 0;
  }
}
為什麼兩個操作都是 O(1)?enqueue 呼叫的 append 直接從 this.tail 接上新的 node,不需要從頭走一趟找隊尾;dequeue 呼叫的 remove(0) 只是把 this.head 換成下一個 node,中間那些 node 從頭到尾都沒有被碰到。
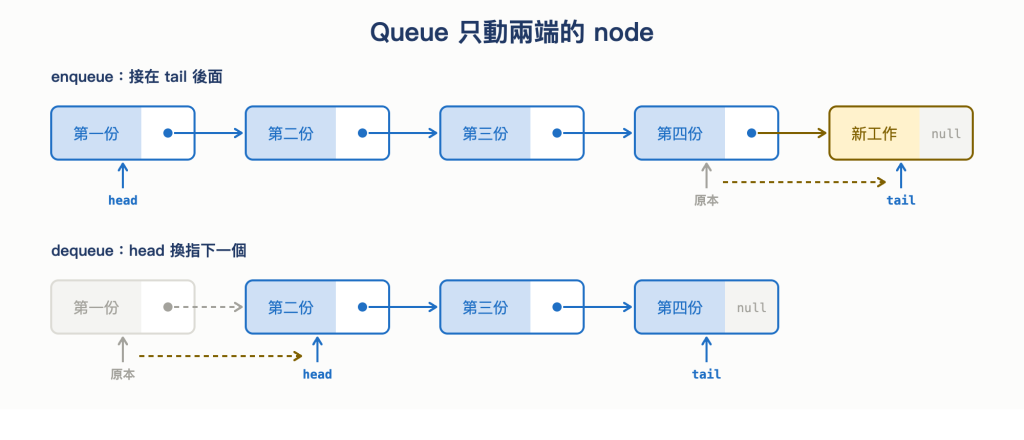
圖 5 Queue 只動兩端的 node:一邊接上去、一邊摘下來,中間完全不必走訪
這裡稍微比較一下,昨天提的 Stack 用的是同一個 LinkedList,但它把 push 和 pop 都放在 head,今天的 Queue 則是一個在 tail、一個在 head。兩邊都是 O(1),靠的是兩件事:
tail,所以 enqueue 要把新的 node 接在隊尾時,不必從 head 走一趟去找最後一個是誰。this.head 換成下一個 node。如果反過來要從 tail 刪,就得先找到 tail 的前一個 node,單向的 Linked List 做不到這件事。因為 Queue 剛好落在單向 Linked List 能力範圍的邊界上,有些做法會直接用 Doubly Linked List 來實作它,那當然也成立,只是就這三個操作來說還用不到 prev。
把三種做法擺在一起看,差別如下:
Array + shift |
head index | Linked List | |
|---|---|---|---|
enqueue |
O(1) |
O(1) |
O(1) |
dequeue |
O(N),後面全部往前挪 |
O(1),只把 head 加一 |
O(1),只換 head 指向誰 |
| 額外空間 | 沒有 | 兩個號碼牌,數字持續變大 | 每個 node 多一條 next |
| 適合什麼 | 資料量小,而且寫起來最短 | 進出次數在可預期的範圍內 | 長期存在、長度變動大 |
這三種對空的 queue 呼叫 dequeue,回傳的分別是 undefined、undefined 和 null。想讓呼叫端能自由抽換底層的話,這種邊界行為也要一起講好,理由昨天也已經談過。
回到最前面那台印表機的情境。前面兩種實作都只是把資料收好,但是印表機真正要做的事情是把文件一份一份印出來,而這件事可以寫成一個只認得 Queue 介面的類別:
class PrintManager {
  constructor(queue) {
    this.queue = queue;
  }

  submit(document) {
    this.queue.enqueue(document);

    return this;
  }

  run() {
    while (!this.queue.isEmpty()) {
      console.log(`正在列印:${this.queue.peek()}`);
      this.queue.dequeue();
    }
  }
}
run 裡先用 peek 看一眼現在該印哪一份,印完了才 dequeue 把它移出隊伍。這和直接用 dequeue 拿到值再去印有個差別,如果列印的過程中失敗了,那份文件還留在隊伍最前面,可以重試;先移除的話它就已經從隊伍上消失了,而這就是 peek 存在的意義,讀取和取出是兩件可以分開的事。
PrintManager 從頭到尾只用到 enqueue、dequeue、peek、isEmpty 四個方法,沒有碰到任何一種底層結構,所以前面那兩種實作誰放進去都可以運作:
const manager = new PrintManager(new LinkedListQueue());

manager.submit('第一份文件').submit('第二份文件').submit('第三份文件').run();

// 正在列印:第一份文件
// 正在列印:第二份文件
// 正在列印:第三份文件
把建構子裡那個 new LinkedListQueue() 換成 new HeadIndexQueue(),輸出一模一樣,變的只有跑起來的成本。這就是所謂的「規則和存法是兩件事」。
那如果 PrintManager 底下換成 Stack 會怎麼樣呢?把 enqueue 換成 push、dequeue 換成 pop,程式依然跑得起來,不會拋出任何錯誤,只是輸出變成這樣:
正在列印:第三份文件
正在列印:第二份文件
正在列印:第一份文件
順序整個反過來,最早按下列印的人最後才拿到自己那一份。而比順序顛倒更麻煩的是,辦公室裡的列印工作不會送完一批就結束,隨時都有人在按列印,只要新的工作進來得夠密集,那疊 Stack 的頂端就一直被換成最新送出的文件,最早那一份會被壓在最底下,可能一直輪不到它。這種持續被新來的工作插隊、導致某個工作無限期等待的情況,叫做飢餓(starvation)。
FIFO 天生不會發生這件事,因為新工作只能接在隊伍尾巴,前面的人不會因為後面來了誰而往後退。也就是說,選 Queue 不只是讓輸出順序好看,還可以讓每一份工作的等待時間有個上限,那個上限就是排在它前面還有幾份。
昨天有說 Stack 的限制比 Array 還多,只能從同一端進出,那如果手上只有 Stack,做得出 FIFO 的 Queue 嗎?
做得到,而且只需要兩個 Stack,關鍵在於一疊資料倒進另一疊的時候,順序會整個反過來,所以倒兩次就正回來了。下面的 Stack 就是昨天的那個實作,只要有 push、pop、peek、isEmpty 這四個方法就夠了(底下是 Array 版還是 Linked List 版,都不影響後續 Queue 實作):
class TwoStackQueue {
  constructor() {
    this.inStack = new Stack();
    this.outStack = new Stack();
  }

  enqueue(value) {
    this.inStack.push(value);

    return this;
  }

  dequeue() {
    this.transfer();

    return this.outStack.pop();
  }

  peek() {
    this.transfer();

    return this.outStack.peek();
  }

  isEmpty() {
    return this.inStack.isEmpty() && this.outStack.isEmpty();
  }

  transfer() {
    if (!this.outStack.isEmpty()) return;

    while (!this.inStack.isEmpty()) {
      this.outStack.push(this.inStack.pop());
    }
  }
}
稍微說明一下這段程式~inStack 只負責收資料,enqueue 一律把新工作推進去;outStack 只負責出,dequeue 和 peek 都只碰它;而 transfer 是兩疊之間唯一的通路,負責把 inStack 整疊倒進 outStack。
那為什麼倒過去之後,順序就對了呢?因為每經過一個 Stack 就反轉一次,工作照第一份、第二份、第三份的順序推進 inStack,再一個一個 pop 出來的時候,順序從 1, 2, 3 變成了 3, 2, 1,這是第一次反轉;這些又照 3, 2, 1 推進 outStack,等到從 outStack 取出的時候又變回 1, 2, 3,這是第二次反轉。兩次相抵,取出的順序就回到當初放進去的順序。
那 transfer 什麼時候會執行呢?transfer 開頭有寫 if (!this.outStack.isEmpty()) return;,因此只有 outStack 空了才倒,只要 outStack 還有沒被取完的工作,新進來的就得在 inStack 那等待。
把兩疊 Stack 想成屁股對著屁股擺在一起,inStack 的 top 朝左、outStack 的 top 朝右,從外面看就真的是一端進、另一端出,和 Queue 沒有差異。但中間那道界線不是一條隨時相通的管子,而是一道只在右邊空了才打開的閘門。如果每次 enqueue 都立刻把東西倒過去,取出順序會變成第三份、第二份、第一份,也就是完全的 LIFO。
實際走一次看看:
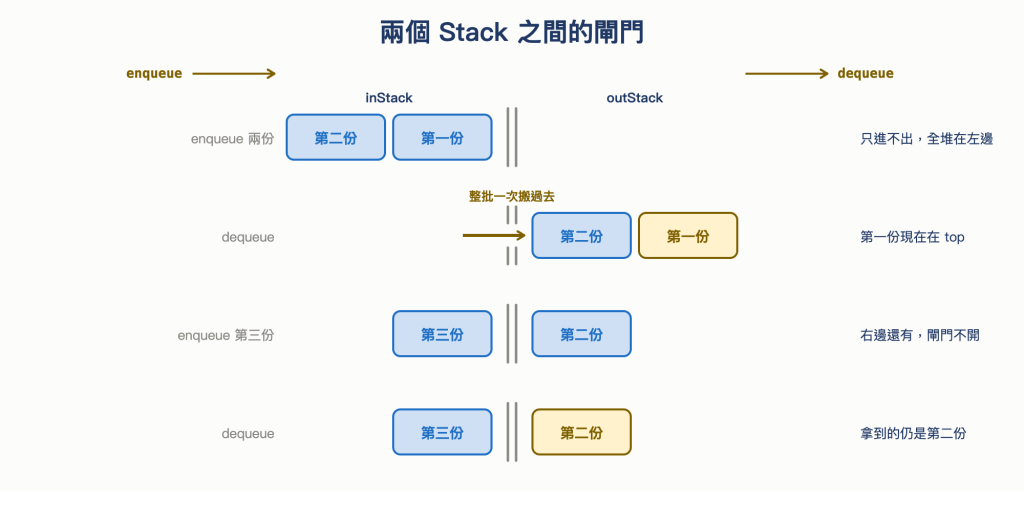
圖 6 兩個 Stack 之間的閘門
從第三排和第四排看得出來,第三份進到 inStack 的時候,outStack 裡的第二份仍然排在它前面被取走,新來的沒有插隊。整體來看,每個元素從進到出,最多只會被從 inStack 搬到 outStack 一次。
這個版本在實務上不一定比前面兩種好,Stack 不是憑空存在的,它底下一樣得靠 Array 或 Linked List 實作,因此用兩個 Stack 做 Queue,等於在同一批儲存結構上又多疊了一層,而多出來的那一層並沒有帶來什麼好處。這個版本要說明的是,FIFO 這組規則不需要「能從開頭拿資料」這種能力才做得出來,用兩個只能碰同一端的結構湊起來也可以。
補充:瀏覽器的 task queue 不是一條 FIFO
前端開發者應該很熟悉瀏覽器的 event loop 機制,在認識 event loop 機制時,常見的說法是 JavaScript 的工作會排進一條 queue,然後照先進先出處理。但實際上是如何儲存呢?藉此機會看看 HTML 規格怎麼說~
HTML 規格說一個 event loop 有一條或多條 task queue,而每一條 task queue 是一個 set:
An event loop has one or more task queues. A task queue is a set of tasks.
Task queues are sets, not queues, because the event loop processing model grabs the first runnable task from the chosen queue, instead of dequeuing the first task.
為什麼要定義成 set 而不是 queue 呢?
因為 event loop 每一輪要取工作的時候,拿的不是排在最前面那個 task,而是排在最前面、而且現在還能跑的那一個。規格把「現在還能跑」稱為 runnable,判斷依據是這個 task 所屬的文件還是不是 fully active,換句話說就是那個頁面還在正常運作、沒有被換掉(如果一個 task 根本不屬於任何頁面,那它一律算 runnable)。
fully active 的定義在規格的另一個章節,那裡用 iframe 舉了例子:頁面上有一個 iframe 載入了 B 頁面,後來這個 iframe 被換成另一個頁面,那原本的 B 就不再 fully active。回到前面提的 runnable 規則來看,B 先前排進去的 task 即使排在最前面也不會被執行,event loop 會直接跳過它、去拿後面那一個。
能跳過中間某一個再取出,這就不是 FIFO 了,所以規格沒有把它定義成 queue。另外規格也寫明 microtask queue 不是 task queue,兩者是不同的東西。
詳細 event loop 運作機制十分複雜,有興趣可再參考規格敘述(我自己也還沒完全搞懂><),這裡提出來只是想說明,名字裡有 queue 的,不代表它遵守的就是今天這組規則。
前面舉的例子是印表機在處理列印工作,那如果換成伺服器處理請求呢?狀況其實很類似,使用者送出的每一個 HTTP 請求都是一份新的工作,而伺服器同時能處理的數量有限,來不及處理的就得先排隊等著,一樣是先到的先被處理。不過伺服器面對的這條隊伍,實務上還多了幾個限制。
第一個是容量,今天自己實作的 queue 都可以無限長,只要記憶體還夠就能一直 enqueue;但真實系統裡的 queue 通常會設一個上限,滿了之後新來的請求就只能被丟掉。
第二個是等待的人會放棄,把隊伍加長、容量開大聽起來像是解法,實際上不一定有幫助,如果使用者只願意等 5 秒,隊伍太長的結果可能是輪到某個請求的時候,發出它的人早就關掉頁面了,等於整條隊伍都在處理沒有人要的工作。
這件事和前面 event loop 那個補充有點類似。HTML 規格把 task queue 定義成 set,就是為了留住「跳過那些已經沒有意義的 task」這個能力;而 HTTP 請求這條隊伍如果就照 FIFO 一路處理下去,並沒有這種餘地,已經沒人在等的請求還是會被拿出來做完。
也因為這樣,先進先出並不是唯一的取用策略。有些系統會刻意選 LIFO,先處理最新進來的請求,理由是舊的請求通常已經等到使用者放棄了,先做新的反而能服務到更多人。這些取捨在〈Queueing〉那篇裡有可以互動的動畫,很推薦一讀~
除了單機上的這條請求隊伍,跨服務之間傳遞工作的訊息佇列(Message Queue)也是類似的形狀,生產者把工作放進佇列、消費者從另一端取出來處理,只是這時候佇列存在的理由變成了解耦與緩衝,而代價是延遲增加,兩邊的資料也只能做到最終一致性(eventual consistency)。
所以同樣是一條隊伍,真實系統要決定的事情比今天的實作多得多。容量要開多大、滿了之後該丟掉誰,這些 Queue 這個 ADT 都沒有規定,得由用它的系統自己決定;另外,如果連「照抵達的順序處理」這個原則都放棄了,那用的其實已經不是 Queue 了。
小小總結一下今天對 Queue 的認識~
dequeue 都要把後面的資料整排往前挪,變成只動一個號碼牌或一條連結,O(N) 和 O(1) 的差別完全來自底下用什麼存。最後補充幾點~
dequeue,用 Array 的 shift 是 O(N),用 head index 或 Linked List 才是 O(1)。tail 就足以支撐 Queue,因為要刪掉的是 head 而不是 tail,還不需要使用 prev。昨天介紹過 call stack,也就是引擎用來記住目前停在哪些函式裡面、還沒回去的那一疊,而它收回來的順序是後進先出。下一篇要看的 Recursion 就是讓函式呼叫自己,每呼叫一次,call stack 就會再疊上一層~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。
src/objects/elements.cc(ShiftImpl 與 RemoveElement)
src/objects/js-array.h(kMaxCopyElements)


 iThome鐵人賽
 看影片追技術