
今天要介紹的是 Stack~
先看一段前幾篇一直在用的訂單資料,這次多記了每張訂單買了哪些東西:
const orders = { 'A-1003': { amount: 180, items: ['杯子', '盤子'] } };
括號從外到內疊了三層,如果是寫在程式編輯器裡,可能有時會忘記補上對應括號,此時編輯器(如 VS Code)會畫出紅線提醒我們,它背後的檢查機制是怎麼做的呢?來看看我們能不能自己寫一個括號檢查機制~
最直覺的做法是數數量,左括號有幾個、右括號就該有幾個,數字對不上就是錯的。這確實能抓到一些問題,例如 { a: [1 } 少了一個 ],數量一比就看出錯誤。但它也會漏掉一些狀況,)( 的左右括號各一個、數量完全相符,卻明顯是錯的;[(]) 也一樣,兩種括號各一對,數量全對,但那個 ] 想關的其實是 (。
數數量有什麼問題呢?
問題在於數量這個資訊裡沒有順序。括號對不對不只看有幾個,還要看誰包在誰裡面,而這件事光靠數字無法判斷。所以檢查器真正要記住的,是「目前有哪些左括號還沒被關掉」,而且要照它們出現的先後排好。
那從左到右一個字元、一個字元讀過去,讀到某一個右括號的時候,該拿哪一個左括號來跟它比對?答案是「還沒關掉的左括號裡,最後出現的那一個」。也就是說,這個檢查器要記住的是一疊還沒關掉的左括號,而且每次只會用到最後看到的那一個。這種「最近加入的最先處理」的順序,就是今天要介紹的 Stack(堆疊),先給一句話定義:
Stack(堆疊)是一疊有順序的資料,只能從同一端放入與取出,所以最後放進去的那一個,會最先被拿出來。
Stack 最常見的比喻是一疊盤子。洗好的盤子一個一個往上疊,要用的時候從最上面拿一個走;想拿最底下那個,得先把上面的都拿走。這疊盤子只有一個開口,取用和疊加都在那裡。不過這比喻和實際 stack 仍有些差異,真實的一疊盤子我們看得到全部有幾個、每個長什麼樣,而 Stack 只讓我們看到最上面那一個。
最後放進去的最先被拿出來,這個順序稱為 LIFO(Last In, First Out,後進先出)。最上面那個位置叫 top,最底下叫 bottom,而所有操作都只發生在 top:
| 操作 | 做的事 |
|---|---|
push |
放一個新的上去,它成為新的 top |
pop |
把 top 拿走並回傳它 |
peek |
看一下 top 是什麼,但不拿走 |
這裡沒有拿第 3 個這種操作,Array 那篇談的 random access 在 Stack 上不存在,想知道從上面數下來第 3 個是什麼,只能把上面 2 個先 pop 掉。
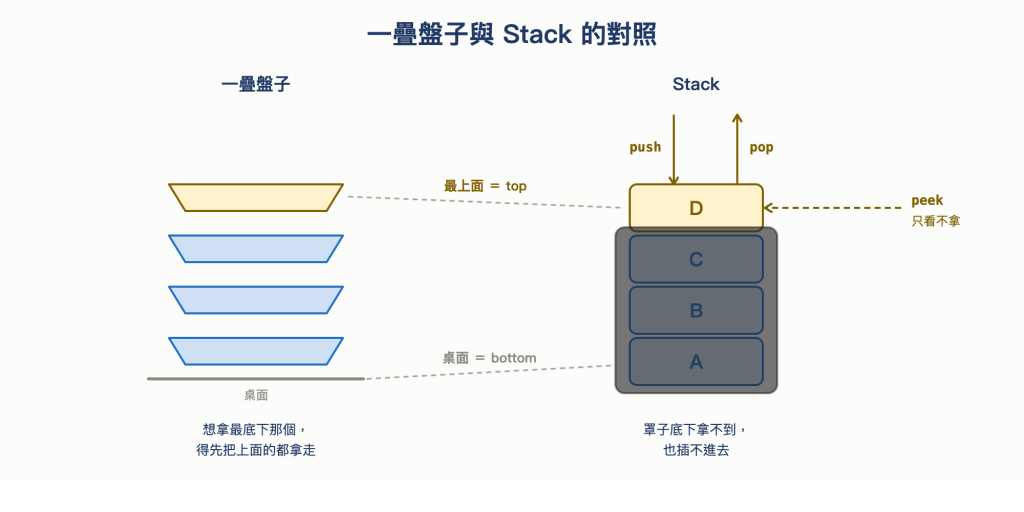
圖 1 一疊盤子與 Stack 的對照:三個操作都只碰 top,中間的元素既拿不到、也插不進去
因為只能處理最上層的那個,三個操作的時間複雜度都是 O(1):
| 操作 | 複雜度 | 為什麼 |
|---|---|---|
push |
O(1) |
只在 top 加一個,其他元素不受影響 |
pop |
O(1) |
只把 top 拿掉,其他元素不受影響 |
peek |
O(1) |
直接讀 top |
至於「某個值在不在裡面」這種 lookup,Stack 並沒有提供,真要做只能一個一個 pop 下來看,成本是 O(N)。
之前介紹 Array 時整理過四種操作,其中有個規律,動尾端的成本較低、動開頭的成本較高,原因是 index 必須連續,動了開頭後面全部要讓位。Stack 三個操作全是 O(1),則是因為它只允許動一端,而動那一端不需要任何人讓位。
把這些整理起來會發現,Stack 能做的事其實比 Array 少很多,中間碰不到,也不能用 index 直接取某一格,限制變多了,但前言提到的那個括號檢查器反而變得好寫。
看到這裡,可能會有個疑問:這三個操作 Array 全都做得到,arr.push()、arr.pop()、arr[arr.length - 1],那為什麼還要一個只能做這三件事的東西?
Array 確實都做得到。而 Stack 的做法則是限制了其他操作,這樣做有幾個好處:
限制帶來力量這件事讓我想到之前讀 Functional Programming 時,提到 map 和 for loop 的比較(ref)。for loop 的彈性很大,而彈性越大也代表越可能出錯。map 則限制了一些控制迴圈的彈性,但它也給了更多保證,在 map 裡,每個元素都會被處理,輸出的長度一定等於輸入的長度。
Stack 和 Array 之間也是類似概念,只是換到了資料結構上,能做的操作變少,能出錯的地方就跟著變少。
像 Stack 這種型別,定義操作資料時的規則,有個專門的名字叫做抽象資料型別,先給一句話定義:
抽象資料型別(Abstract Data Type,簡稱 ADT)只規定資料能做哪些操作,不規定資料實際上怎麼存。
以 Stack 來說,它要求的只有三件事:只能從 top 加入、只能從 top 移除、只能讀 top。至於底下實際用什麼裝這些資料,不在規定裡。
比較 Array 和 Stack,差別如下:
| Array | Stack | |
|---|---|---|
| 是什麼 | 多數語言內建的資料結構 | 建立在其他結構上的一組操作規則 |
| 讀取 | 任意 index | 只有 top |
| 加入 | 任意位置 | 只有 top |
| 移除 | 任意位置 | 只有 top |
| 語意 | 一批有順序的資料 | 最近加入的最先處理 |
JavaScript 開發者們可能聽過 Set,Set 也是 ADT,它要求的是元素不重複,而底下實作可以用 Array,也可以用 Hash Table,只要符合規則即可。換句話說,我們之前介紹的 Array 和 Linked List,回答的是「資料實際怎麼存」;而 Stack 和 Set 回答的是「能對資料做什麼操作」,是兩個不同層次的問題。
補充:Abstract Data Type 和 Algebraic Data Types
因為之前有讀了一些 Functional Programming 的東西,在 Functional Programming 的世界裡,ADT 通常指的是另一個東西:Algebraic Data Types(代數資料型別),兩者只是縮寫同名,概念上沒有關係。
Abstract Data Type 和 Algebraic Data Types 的方向有點相反。Abstract Data Type 把資料的儲存方式藏起來,只讓外面看到能做哪些操作,像今天的 Stack,用的人完全不知道底下的實作是 Array 還是 Linked List。Algebraic Data Types 則是把資料可能長成的每一種樣子全部列出來,例如
Option就只有「有值」和「沒值」兩種,也正因為列得完,型別檢查才有辦法要求我們每一種都處理到。資料結構與演算法這系列文提到的 ADT,指的會是 Abstract Data Type,和 FP 系列的 Algebraic Data Types 不同,因此特別提出兩者差異~
既然 Stack 可視為對資料操作的規定,並沒有規定底下實作用什麼存,那就代表我們可以用 Array 或 Linked List 實作,先來看 Array 版實作:
class Stack {
  constructor() {
    this.array = [];
  }

  push(value) {
    this.array.push(value);
    return this;
  }

  pop() {
    return this.array.pop();
  }

  peek() {
    return this.array[this.array.length - 1];
  }

  isEmpty() {
    return this.array.length === 0;
  }
}
除了三個主要操作,這裡多寫了一個 isEmpty,用來確認現在還有沒有元素,一樣只碰 top 那一端。
稍微看看 top 放在哪裡,這一版把陣列的尾端當成 top,之前介紹 Array 時提過,push 和 pop 更動的是尾端,兩個都是 O(1),時間複雜度較低;如果反過來把開頭當 top,就得用 unshift 和 shift,每次都要讓後面所有元素移位,三個 O(1) 會全部變成 O(N)。為了效率更好的操作,因此才將陣列的尾端視為 top。
接著來看看 Linked List 版的實作,這裡直接用前兩天寫的那個 LinkedList,不用重寫一次 node,先把這個 Stack 會用到的部分列出來:
class Node {
  constructor(value) {
    this.value = value;
    this.next = null;
  }
}

class LinkedList {
  constructor() {
    this.head = null;
    this.tail = null;
    this.length = 0;
  }

  prepend(value) {
    const newNode = new Node(value);

    newNode.next = this.head;
    this.head = newNode;
    if (this.tail === null) this.tail = newNode;
    this.length++;

    return this;
  }

  traverseToIndex(index) {
    let current = this.head;
    let count = 0;

    while (count < index) {
      current = current.next;
      count++;
    }

    return current;
  }

  remove(index) {
    if (index < 0 || index >= this.length) return null;

    if (index === 0) {
      const removed = this.head;

      this.head = removed.next;
      if (this.head === null) this.tail = null;
      this.length--;

      return removed.value;
    }

    const previous = this.traverseToIndex(index - 1);
    const removed = previous.next;

    previous.next = removed.next;
    if (removed === this.tail) this.tail = previous;
    this.length--;

    return removed.value;
  }
}
接著 Stack 再基於 LinkedList 實作:
class Stack {
  constructor() {
    this.list = new LinkedList();
  }

  push(value) {
    this.list.prepend(value);
    return this;
  }

  pop() {
    return this.list.remove(0);
  }

  peek() {
    return this.list.head === null ? undefined : this.list.head.value;
  }

  isEmpty() {
    return this.list.length === 0;
  }
}
LinkedList 的版本把 head 當成 top,理由和 Array 版本相同,前兩天提到,在 LinkedList 的操作成本中,插在開頭和刪開頭都是 O(1),而刪尾端要從 head 走一趟才拿得到前一個,是 O(N)。
把兩個版本的實作放在一起看,會發現兩種實作都把 top 放在自己操作成本低的那一端,Array 的 top 在尾端、Linked List 的 top 在開頭,但外面呼叫的人完全看不出這件事,因為兩邊暴露出來的方法都只有 push、pop、peek、isEmpty 這幾個方法,換掉底下實作,呼叫端也不需要更改程式。
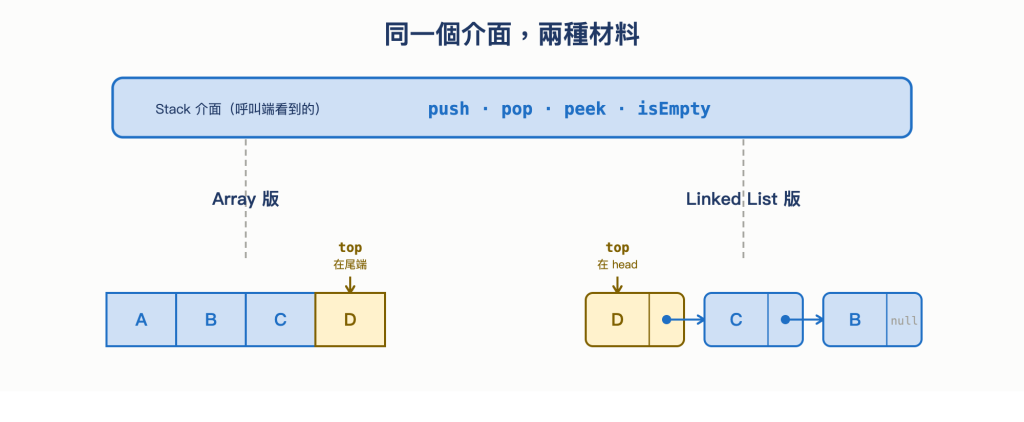
圖 2 同一個介面,兩種材料
既然 Stack 不限制實作方式,那要選哪種呢?取決於情境,簡單整理如下:
| Array 版 | Linked List 版 | |
|---|---|---|
| top 的位置 | 尾端 | head |
| 記憶體排列 | 連續,讀取可能得到記憶體 cache 好處 | 四散各處,每個 node 還要多存一條連結 |
| 長大的成本 | 空間滿了要另外要一塊更大的、再把舊資料搬過去 | 直接接上去,不用搬 |
不過「換掉底下實作,呼叫端不用改」這件事有個前提。如果對兩個版本的空 Stack 各呼叫一次 pop,會發生什麼事呢?Array 版回傳的是 undefined,因為那是 [].pop() 的回傳值;Linked List 版回傳的則是 null,因為 remove 在 index 超出範圍時就是回傳 null。因此,若呼叫端寫了 if (stack.pop() === null),底下換一個實作,判斷就會壞掉。
也就是說,一個 ADT 如果想自由抽換底層實作,光規定有哪些操作還不夠,邊界情況的行為也要一起規定,例如空的時候 pop 要回傳什麼、或者直接拋出錯誤。所以括號檢查裡會先用 isEmpty 確認還有東西才 pop,而不是去看 pop 回傳了什麼。
這種「同一個介面、底層可以換」的設計,在 C++ 也看得到,C++ 的 std::stack 就是這概念。它在文件裡被稱為 container adaptor,意思是它自己不存資料,只是套在別的容器外面,把那個容器的介面改成 Stack 的樣子,宣告長這樣:
template <class T, class Container = deque<T> > class stack;
這行宣告裡有兩個參數,T 是要裝什麼型別的資料,而 Container 就是底層要用什麼實作。至於 = deque<T> 那個等號,是 C++ 寫預設值的方式,意思是不特別指定的話就用 deque(一種兩端都能進出的容器)。文件也有說 vector 和前兩天提過的 std::list(也就是 linked list)都符合實作要求。
而「符合要求」的意思是,這個容器要有 empty、size、back、push_back、pop_back 這五個方法。其中真正會碰到位置的是後三個,而它們都落在同一端,沒有一個需要從中間存取。
回到前言那個檢查括號的問題,現在我們可以把檢查器寫出來了,大致流程為:
push 進 Stack,表示它還沒被關掉pop 一個最新看過的左括號出來,看看右括號是否能和最新的左括號配對把前言那段程式碼的非括號字元去掉,剩下的會是 {{[]}},逐字掃描的過程如下:
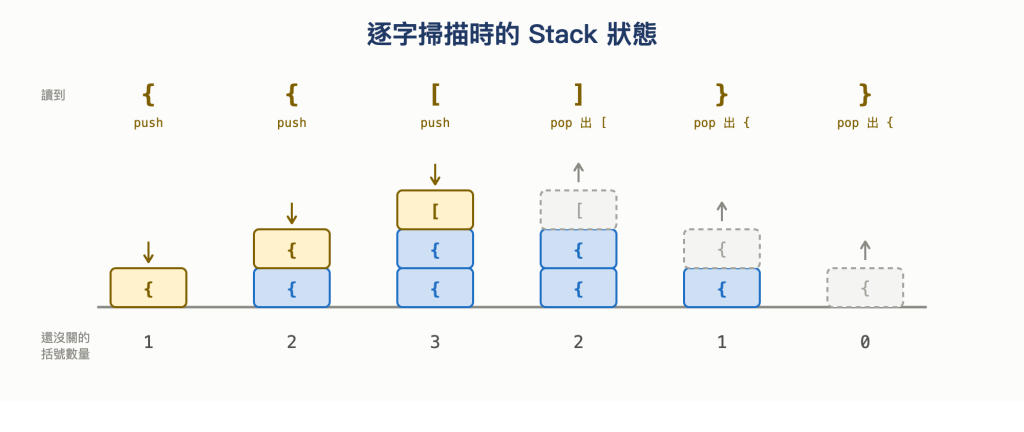
圖 3 逐字掃描時的 Stack 狀態:Stack 的高度就是「目前還有幾個括號沒關」
寫成程式如下:
function isValidBrackets(input) {
  const stack = new Stack();
  const pairs = { ')': '(', ']': '[', '}': '{' };

  for (const char of input) {
    if ('([{'.includes(char)) {
      stack.push(char);
      continue;
    }

    if (char in pairs) {
      if (stack.isEmpty()) return false;
      if (stack.pop() !== pairs[char]) return false;
    }
  }

  return stack.isEmpty();
}
括號會出錯的方式只有三種,整理如下:
| 錯法 | 例子 | 在哪裡被抓到 |
|---|---|---|
| 有左括號沒關 | { a: [1 } 少一個 ] |
最後那行,讀完了 Stack 還有東西 |
| 右括號沒有對應的左括號 | a: 1 } |
stack.isEmpty(),想 pop 卻沒東西可 pop |
| 關錯類型 | { a: [1 } 的 } 想關 [ |
stack.pop() !== pairs[char] |
另外,pairs 這物件是用右括號當 key、左括號當 value,因為程式讀到右括號時,要問的是「和我配對的左括號長什麼樣」,而不是反過來。
除了這三種錯法,還有一種錯可能是寫程式時沒注意導致出錯。前面提過直接用 Array 時,「拿最後一個」很容易寫成「拿第一個」,把這件事放到這段程式裡就是這樣:
function isValidBracketsWithShift(input) {
  const stack = [];
  const pairs = { ')': '(', ']': '[', '}': '{' };

  for (const char of input) {
    if ('([{'.includes(char)) {
      stack.push(char);
      continue;
    }

    if (char in pairs) {
      if (stack.shift() !== pairs[char]) return false;
    }
  }

  return stack.length === 0;
}
這段程式和之前版本,只有 pop 換成 shift 的差別,也就是改成從最舊的那個開始比對。這個版本在 {}、{}[]、()[]{} 這些輸入上全部都對,連 {) 這種錯的也能判斷,因為括號只有一層時,最舊的和最新的本來就是同一個。要等到 {[]} 或 {{[]}} 這種真的疊起來的輸入,它才會開始把對的判成錯的。
另外,Stack 在這裡的高度剛好就是「目前還有幾個括號沒關」,也就是巢狀的深度。這也是 Stack 適合處理巢狀結構的原因,巢狀本來就是一種「先開的後關」的形狀,和 LIFO 概念相同。
目前我們寫的 isValidBrackets 只是簡易版的判斷,真正的括號/語法檢查器還要多處理其他事,例如字串和註解裡面的括號不能算數,像 const s = '}' 這個 } 只是一個字元,不該去關掉任何東西,而真實的工具通常不自己重算哪些括號才算數,VS Code 的做法是沿用語法高亮已經標好的 token,官方文章寫著「只要照語法高亮的判斷去忽略註解和字串裡的括號,效果就夠好了」。不過這裡就先不考慮這些情境,以簡單說明概念為主~
括號檢查器這個問題只用了一個 Stack,接著來看看需要兩個 Stack 的應用情境:瀏覽器上一頁與下一頁的行為。
當我們在瀏覽器按上一頁時,要回到的是「最近去過、但還沒退回去的那一頁」,這是標準的 LIFO,用一個 Stack 儲存即可。但如果按了上一頁以後,又再按下一頁呢?剛剛離開的那一頁還要能再回去,但它已經不在原本那疊 Stack 裡了,得另外有個地方放它。
所以這問題需要兩個 Stack,一個記可以往回退的頁面,一個記剛剛退出來、可以再前進的頁面:
class History {
  constructor(page) {
    this.current = page;
    this.back = new Stack();
    this.forward = new Stack();
  }

  visit(page) {
    this.back.push(this.current);
    this.current = page;
    this.forward = new Stack();
  }

  goBack() {
    if (this.back.isEmpty()) return this.current;

    this.forward.push(this.current);
    this.current = this.back.pop();

    return this.current;
  }

  goForward() {
    if (this.forward.isEmpty()) return this.current;

    this.back.push(this.current);
    this.current = this.forward.pop();

    return this.current;
  }
}
goBack 和 goForward 做的是同一件事,只是兩個 Stack 的角色對調:把目前這頁 push 進其中一疊,再從另一疊 pop 一頁出來當作目前這頁。目前在哪一頁不放在任何一個 Stack 裡,而是單獨用 current 存著,因為它不屬於「可以退回去的」也不屬於「可以前進的」。
實際走一次看看。假設我們從首頁出發,接著看了列表頁和詳情頁:
| 動作 | back(左邊是 bottom) | current | forward |
|---|---|---|---|
| 起點 | (空) | 首頁 | (空) |
visit('列表') |
首頁 | 列表 | (空) |
visit('詳情') |
首頁 列表 | 詳情 | (空) |
goBack() |
首頁 | 列表 | 詳情 |
goBack() |
(空) | 首頁 | 詳情 列表 |
goForward() |
首頁 | 列表 | 詳情 |
visit('購物車') |
首頁 列表 | 購物車 | (空) |
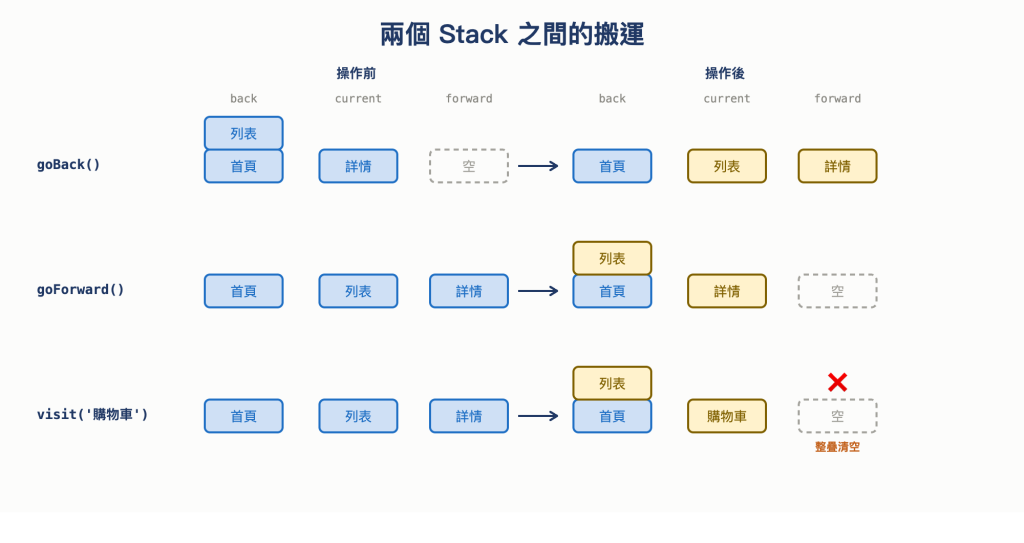
圖 4 兩個 Stack 之間的搬運
稍微提一下最後那一列,visit 除了把目前這頁推進 back,還把整個 forward 換成一個新的空 Stack,原因是前進紀錄記的是「剛剛從哪幾頁退回來」,一旦從這裡走了一條新的路線,原本那條路線就不存在了,自然也沒有東西可以前進。
這也是在瀏覽器按了上一頁、接著點一個新連結之後,前進鍵就變成灰色的原因。而這件事在 HTML 規格裡是明文規定的,有一個叫做 clear the forward session history 的步驟,要求導航到新頁面之前,先把目前位置後面的紀錄全部移除。而我們目前的實作中,this.forward = new Stack() 那一行就得到了相同結果。
不過要有一點要澄清的是,兩個 Stack 是描述這個上一頁、下一頁行為的模型,不等於瀏覽器實際的實作方式。HTML 規格裡的 session history 是「一個 list + 一個表示目前位置的數字」:
Session history entries, a list of session history entries, initially a new list.
A current session history step, a number, initially 0.
按上一頁時,那個 list 一個 entry 都沒有動,只有表示目前位置的數字往前退。而 clear the forward session history 做的事,就是把 step 大於目前位置的 entry 從 list 裡刪掉。相同行為,用兩個 Stack 和用一個 list 加索引都能表達出來,這也呼應了前面提的 ADT,操作規則和底下怎麼存是兩件事。
上一頁、下一頁和括號那題比起來有些不同,括號只用一個 Stack,重點在巢狀有多深;上下頁切換用兩個 Stack,重點在資料怎麼在兩疊之間搬運。但兩題共通的地方是,它們都只關心「最近的那一個」。
前面說巢狀本來就是「先開的後關」的形狀,而函式呼叫也是巢狀的,JavaScript 引擎為了記住哪些函式還沒執行完畢,就需要儲存一疊東西,這疊東西叫做 Call Stack,先給一句話定義:
Call Stack(呼叫堆疊)是引擎用來記住「目前停在哪些函式裡面、還沒回去」的那一疊,每呼叫一個函式就疊上一層,函式回傳就把那一層拿掉。
這個名字對前端開發者來說應該還算熟悉,錯誤訊息裡的 stack trace 就是把這一疊印出來,而 Maximum call stack size exceeded 這個錯誤訊息,則是這一疊資料放不下的意思。先用一段很短的程式看看它長什麼樣:
function inner(x) {
  return x + 1;
}

function outer(x) {
  return inner(x * 2);
}

const result = outer(5); // 11
執行的過程中,這一疊是這樣變化的:
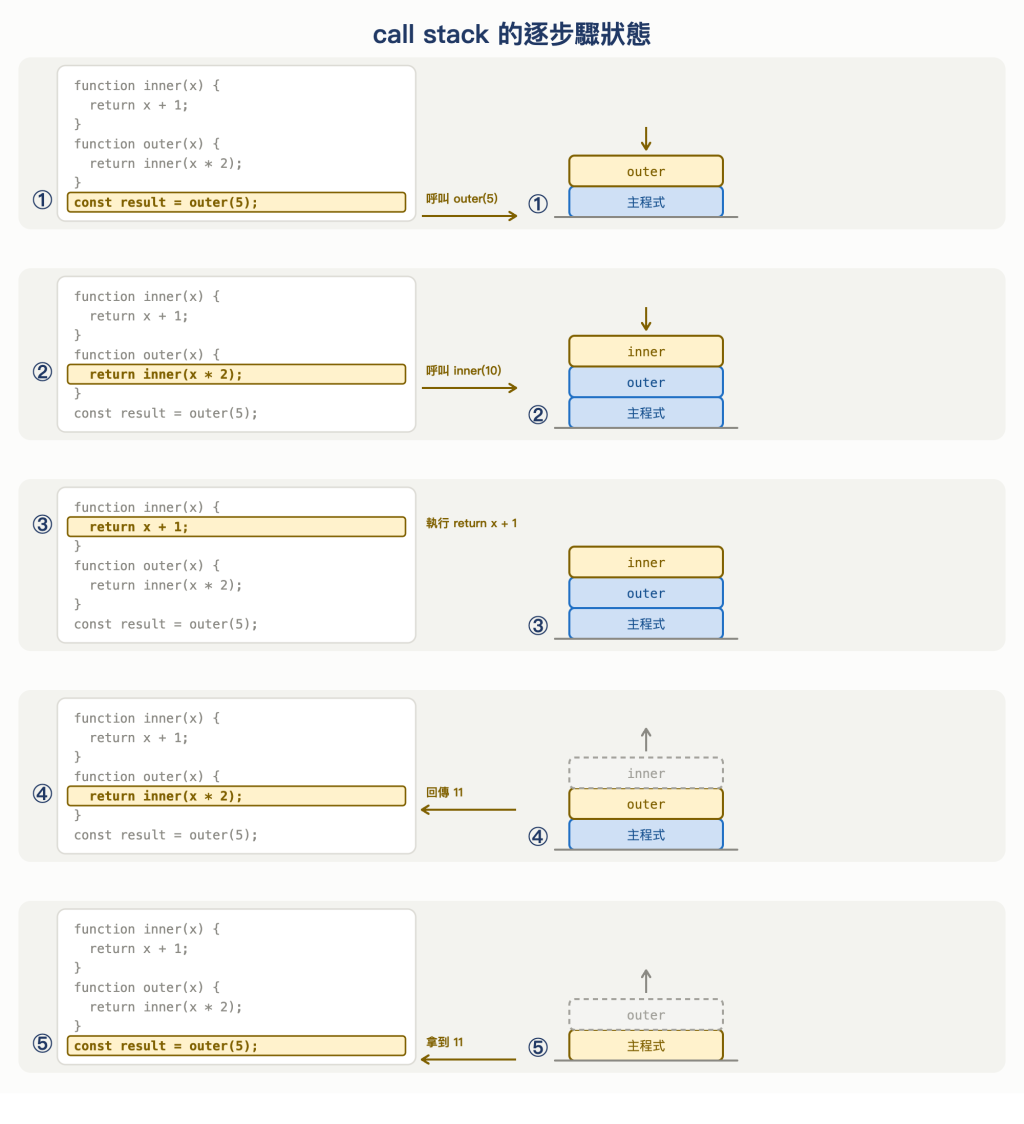
圖 5 call stack 的逐步驟狀態示意圖
inner 比 outer 晚被呼叫,卻比它早結束,和括號檢查的「先開的後關」是同樣概念。整段程式跑完之後這一疊會回到只剩主程式,跟括號檢查讀完後 Stack 要是空的一樣。
那 call stack 的每一層裡面到底放了什麼呢?MDN 的 JavaScript execution model 把每一層叫做 execution context(也就是一般說的 stack frame),裡面有「這個函式做完要回到哪裡」,也有那一層自己的變數、this、以及目前執行到哪。所以上面那段程式跑起來時,outer 那層記著 x 是 5、inner 那層記著 x 是 10,兩個 x 互不影響,因為它們住在不同層。
這一疊平常其實我們也看得到,有時我們會在 console 看到錯誤訊息,裡面那串 stack trace 印出來的就是出錯當下還沒回去的那些函式,從最上面(最近呼叫的那個)一路列到最下面。V8 的文件提到它預設只收最上面 10 層,理由是「這個數量通常夠用,又不會對效能造成明顯影響」,這也是為什麼很深的呼叫鏈印出來常常是被截掉的。
更明顯意識到 call stack 的存在,是在它爆掉的時候。如果一個函式在自己裡面又呼叫了自己、而且沒有停下來的條件,那每呼叫一次就會再疊一層上去,這疊就一直長高,高到超過引擎給它的空間時就會拋出 RangeError: Maximum call stack size exceeded,這就是所謂的 stack overflow。
那個「引擎給它的空間」其實是一塊記憶體,不是一個最多幾層的次數上限。V8 原始碼裡這個預設值在多數平台上是 984 KB,而旁邊的註解也有寫為什麼是這個數字:
// Slightly less than 1MB, since Windows' default stack size for
// the main execution thread is 1MB.
#define V8_DEFAULT_STACK_SIZE_KB 984
也就是這個上限是跟著作業系統給主執行緒的堆疊大小走的,不是 JavaScript 自己定義的。既然限制的是空間而不是次數,call stack 能疊多深就不只看呼叫了幾次,也和每一層存了多少東西有關。
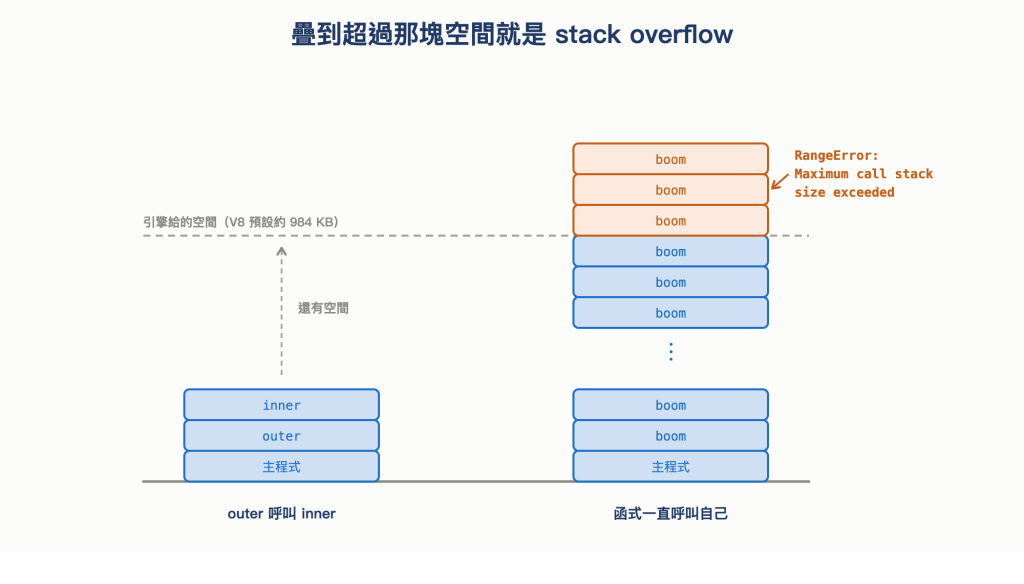
圖 6 疊到超過那塊空間就是 stack overflow
另外,上面這些講的是「引擎記錄執行狀態的方式和 Stack 是同一個形狀」,並不代表「引擎裡面有一個我們剛剛寫的那種 Stack class」。每一層實際存了哪些東西、記憶體怎麼配置,是另一個層次的問題,這裡只是要藉此說明,巢狀的呼叫關係,一定是後進先出地收回來。
小小總結一下今天對 Stack 的認識~
O(1) 的操作,以及一個沒辦法用錯的介面,別人讀到這段程式也能立刻知道資料是怎麼被處理的。最後補充幾點~
push、pop、peek 都是 O(1),靠的是只准動一端;要找某個特定的值仍然是 O(N),因為 Stack 沒有捷徑可以跳。Array 和 Linked List 談的是資料怎麼存,今天這個只規定操作的 Stack 則是另一個面向。而 LIFO 只是眾多順序中的一種,下一篇要看和它完全相反的那一種~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。
std::stack
src/common/globals.h(V8_DEFAULT_STACK_SIZE_KB)


 iThome鐵人賽
 看影片追技術