
昨天有用三種輸入去跑 Bubble Sort 和 Selection Sort,並整理出各自的執行次數,其中,在已排序那列可看到加了 early exit 的 Bubble Sort 只花 7 次比較就結束,Selection Sort 卻要執行 28 次比較。當時有說,判斷排序的執行效率不能只看演算法本身,還要看輸入長什麼樣。
完全排好的陣列是最好情況,但在實務上其實不容易遇到。比較常見的可能是,一份本來就排好的清單,因為新增了幾筆資料而稍微亂掉。舉例來說,有一份依評分由低到高排序的評論清單,原本是 68、74、81、85、90、93 這 6 筆,如果這時又進來兩則新評論,分數分別是 83 和 72,直接接在後面會長這樣:
const scores = [68, 74, 81, 85, 90, 93, 83, 72];
這份清單只有最後兩格是未排序的,前面都已排序好,既然大部分元素已經在對的地方,把整份資料重排一次似乎有點浪費,那有沒有一種排序方式能利用這特性,只處理真正需要動的那幾筆呢?今天要介紹的 Insertion Sort 正適合這種情況,它的做法和整理撲克牌很像,左邊那疊維持排好,每抽到一張新的,只要往前找到它該插進去的位置就好。
接下來就來看看 Insertion Sort~
先給 Insertion Sort 一句話定義:
Insertion Sort 每一輪從未排序區取出最前面的那個元素,往左邊的已排序區裡找到它該待的位置插進去,讓已排序區多一格。
和昨天的 Bubble Sort 和 Selection Sort 相比,Insertion Sort 的出發點不太一樣。Bubble Sort 和 Selection Sort 每一輪都在「找」,一個找相鄰的逆序對、一個找剩下元素裡的最小值;Insertion Sort 每一輪則是直接拿下一個元素,然後相信左邊已經是排好的,只需把它放回對的位置。因此迴圈會從 index 1 開始,因為插入需要左邊先有一段排好的區間,而第一輪之前只有 arr[0] 能當這段區間,一個元素不可能和誰順序顛倒,本來就能視為已排序。
Insertion Sort 的每一輪可以拆成三步:
每跑完一輪,已排序區就往右長一格、未排序區少一格,直到未排序區清空。
用 [68, 74, 81, 85, 90, 93, 83, 72] 來走一遍看看。前 5 輪的情況都相同,每一輪都在第一次比較就停下來:
74,左邊的 68 比它小,條件不成立,不需移動元素,跳到下一輪81,左邊的 74 比它小,停下並跳到下一輪85,左邊的 81 比它小,停下並跳到下一輪90,左邊的 85 比它小,停下並跳到下一輪93,左邊的 90 比它小,停下並跳到下一輪這 5 輪加起來只用了 5 次比較,陣列從頭到尾沒有變過。
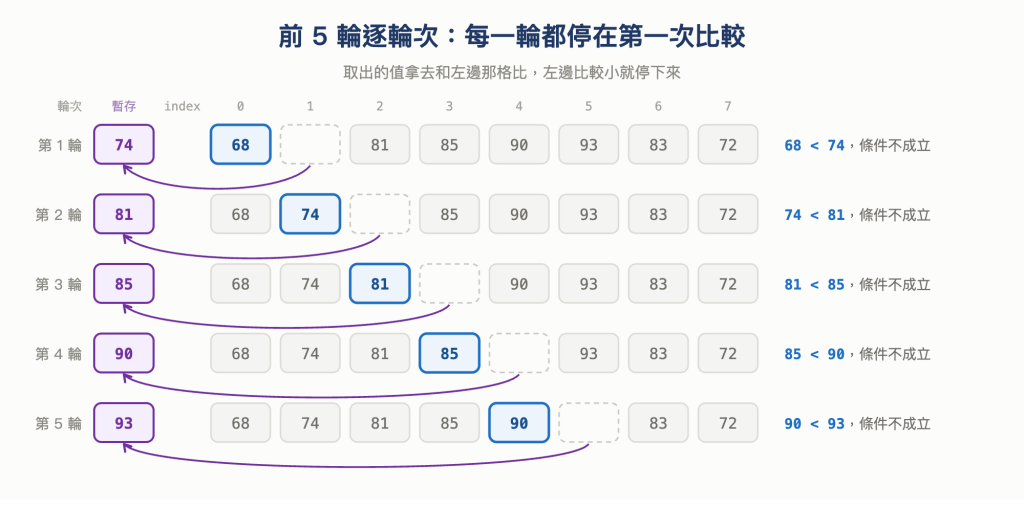
圖 1 前 5 輪每一輪都在第一次比較就停下來,陣列從頭到尾沒有變化
原因是這份清單的前 6 格本來就排好了,而 Insertion Sort 每一輪往左走的時候,只會挪動比暫存的值大的元素,一碰到不是這樣的就停,不會繼續往前。和 Selection Sort 不同的是,Selection Sort 為了確定最小值在哪,就算左邊已經排好也要把剩下的每一格都看過。
83 要往左走三格再來看看第 6 輪。取出 index 6 的 83 之後,那一格就成了空位,接著從空位左邊開始往回比:
93 比 83 大,把 93 往右挪一格,空位跟著往左移90 比 83 大,一樣往右挪一格85 比 83 大,再往右挪一格81 比 83 小,條件不成立,停下來83 放進目前的空位這一輪比了 4 次、挪了 3 格,陣列變成 [68, 74, 81, 83, 85, 90, 93, 72]。
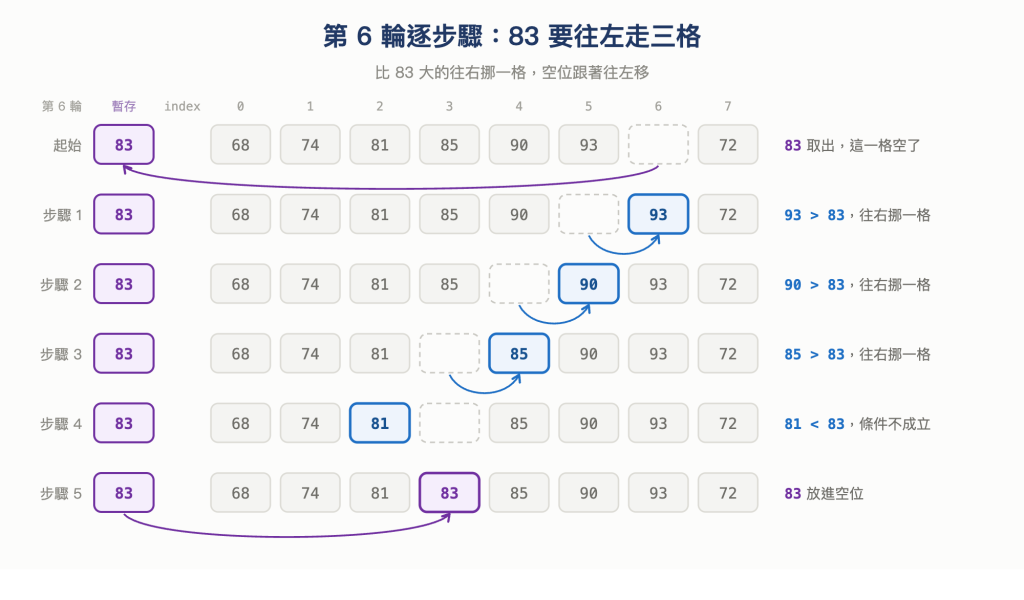
圖 2 取出 83 後,比它大的元素依序往右挪,空出它該待的位置
這裡有個和昨天不一樣的地方,整輪一次交換都沒有發生。比 83 大的元素只是被往右複製一格,而 83 本身從頭到尾都存在旁邊,等到位置空出來才放回去。
72 要走得更遠最後一輪取出 72。它是這份清單裡第二小的值,往左會一路到接近開頭處:
93 比 72 大,把 93 往右挪一格,空位跟著往左移90 比 72 大,一樣往右挪一格85 比 72 大,再往右挪一格83 比 72 大,再往右挪一格81 比 72 大,再往右挪一格74 比 72 大,再往右挪一格68 比 72 小,條件不成立,停下來72 放進目前的空位這一輪比了 7 次、挪了 6 格,結束之後陣列就是 [68, 72, 74, 81, 83, 85, 90, 93],排序完成。
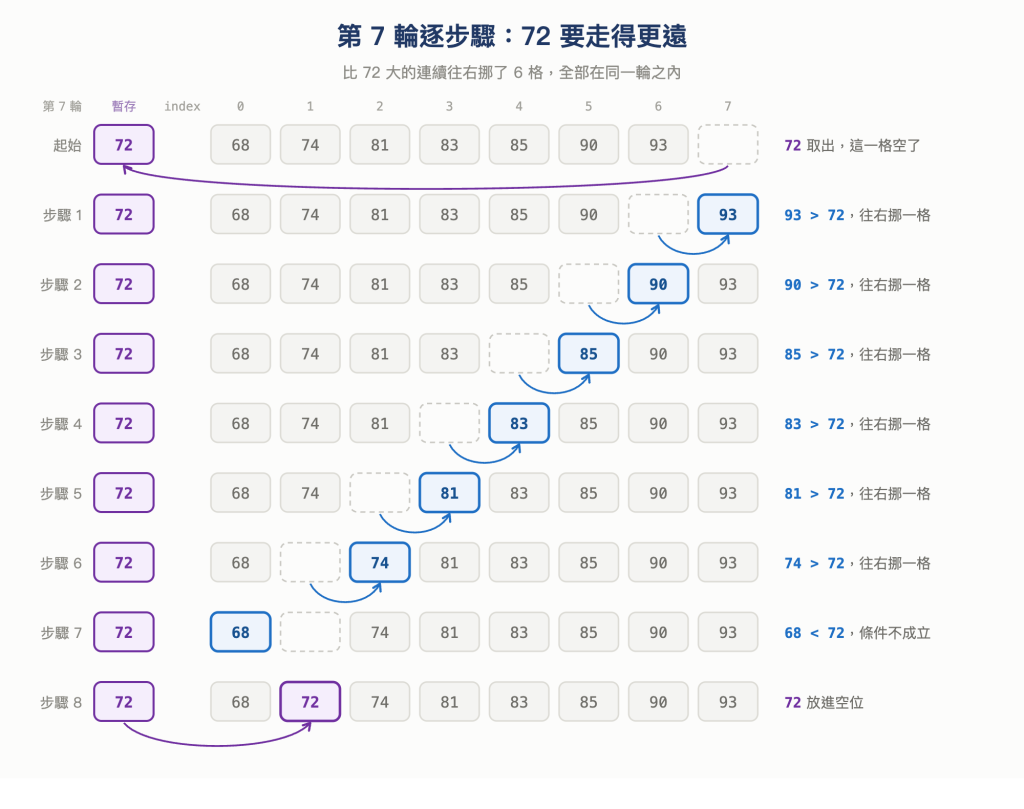
圖 3 72 一路往左走了 6 格,整段路是同一輪內走完的
這一輪也看得出 Insertion Sort 一輪能把一個元素往左送多遠。72 從最後一格移動到 index 1,中間跨了 6 格,整段過程在同一次 while 迴圈裡走完,不需分成好幾輪。
把 7 輪的執行過程整理成一張表:
| 輪次 | 取出的值 | 比較次數 | 往右挪的格數 | 這一輪結束後的陣列 |
|---|---|---|---|---|
| 1 | 74 |
1 | 0 | [68, 74, 81, 85, 90, 93, 83, 72] |
| 2 | 81 |
1 | 0 | [68, 74, 81, 85, 90, 93, 83, 72] |
| 3 | 85 |
1 | 0 | [68, 74, 81, 85, 90, 93, 83, 72] |
| 4 | 90 |
1 | 0 | [68, 74, 81, 85, 90, 93, 83, 72] |
| 5 | 93 |
1 | 0 | [68, 74, 81, 85, 90, 93, 83, 72] |
| 6 | 83 |
4 | 3 | [68, 74, 81, 83, 85, 90, 93, 72] |
| 7 | 72 |
7 | 6 | [68, 72, 74, 81, 83, 85, 90, 93] |
| 合計 | 16 | 9 |
整份清單 7 輪跑完,總共 16 次比較、9 次挪動,其中 11 次比較和全部 9 次挪動都集中在最後兩輪。
昨天用 Day 04 的 loop invariant 描述過 Bubble Sort 和 Selection Sort 的已排序區,Insertion Sort 也可以用同一種方式來看:
在第
i輪開始之前,arr[0 .. i - 1]裡的元素彼此已經排好序。
這句話和昨天那句 Selection Sort 的保證放在一起看,會發現少了一段。昨天那句說的是「元素都已經在最終位置上,而且都不大於右邊剩下的每一個元素」,這裡卻只保證裡面的元素彼此有序,沒有保證誰在最終位置。
為何不保證元素在最終位置呢?因為 Insertion Sort 真的做不到。第 6 輪開始前 arr[0 .. 5] 是 [68, 74, 81, 85, 90, 93],確實都排好了,但 85、90、93 在那一輪都被往右挪了一格,第 7 輪又各自再挪一次。也就是說,已排序區隨時可能因為後面插進來的元素而整批往右移動,要等迴圈結束、未排序區清空,裡面的元素才算真的定案。
更進一步用 Day 04 的三步法檢查一次:
Initialization:第 1 輪開始之前,已排序區只有 arr[0] 一格,一個元素自己當然是排好的。
Maintenance:每一輪把 arr[i] 往左送到第一個不比它大的元素後面,比它大的都被挪到它右邊去了,所以這一輪結束時 arr[0 .. i] 仍然彼此有序。
Termination:i 走完最後一格後,已排序區涵蓋整個陣列,那句保證翻譯過來就是「整個陣列彼此有序」。
把 Insertion Sort 寫成程式如下:
function insertionSort(array) {
  const arr = [...array];

  for (let i = 1; i < arr.length; i++) {
    const current = arr[i]; // 取出這一輪要處理的值,這一格就空出來了
    let j = i - 1; // 從空位左邊那格開始往左看

    while (j >= 0 && arr[j] > current) { // 還沒超過最左範圍,且左邊這格比 current 大
      arr[j + 1] = arr[j]; // 把左邊這格的值往右複製一格
      j--; // 空位跟著往左移一格
    }

    arr[j + 1] = current; // 把暫存的值放回空著的那一格
  }

  return arr;
}
最後那行為什麼是 j + 1 而不是 j 呢?因為 while 迴圈停下來的時候有兩種情況,一種是 arr[j] 不再比 current 大,j 就停在第一個不比它大的元素上,空位在它右邊;另一種是 j 已經退到 -1,代表 current 比已排序區裡每一個元素都小,空位在最前面。兩種情況下 j + 1 都剛好是那個該放進去的空位,不需分開處理。
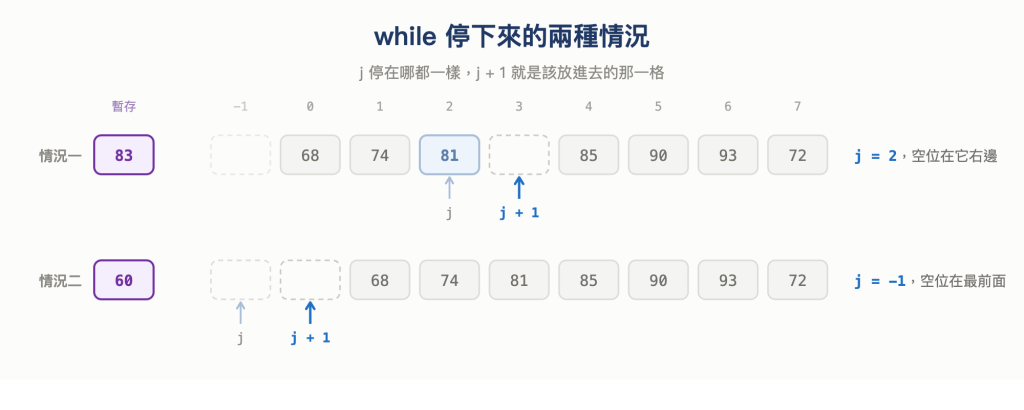
圖 4 不管 j 停在陣列裡還是退到陣列外的 -1,j + 1 都落在該放進去的那一格
另外,在 JavaScript 裡,還有另一種寫法。既然要做的事情是「把一個元素抽出來、插到另一個位置」,那用 splice 好像也可以...?
function insertionSort(array) {
  const arr = [...array];

  for (let i = 1; i < arr.length; i++) {
    const current = arr[i];
    let j = i - 1;

    while (j >= 0 && arr[j] > current) j--; // 只往左找位置,不搬動元素

    arr.splice(i, 1); // 把 current 原本那一格整個移除
    arr.splice(j + 1, 0, current); // 再把 current 插進 j + 1
  }

  return arr;
}
這版本跑起來的結果也沒問題,但那些搬動的成本並沒有消失,只是被搬到 splice 內部了。arr.splice(i, 1) 移除一個元素之後,它後面每一格都要往左補;arr.splice(j + 1, 0, current) 插入的時候,插入點後面每一格又要往右挪。Day 05 提過 unshift 是 O(N),理由也是這樣,只要動到中間或開頭,後面就得跟著換位置。
事實上這版本沒有比較省力,還把原本一次挪動就能完成的事拆成了移除和插入。而且成本被包進方法呼叫後就看不見了,讀這段程式的人很容易以為 splice 是個固定成本的動作。既然今天要數的就是這些挪動,那就用前面那個 while 迴圈的版本就好。
回頭看一下第 6 輪的流程,可以想一下,為什麼要先把 83 取出來暫存呢?如果直接讓 83 和左邊的 93 對調,再和 90 對調,一路換到定位為止,最後的結果不是一樣嗎?
結果確實一樣,但兩種做法的工作量不同,而這正是 Insertion Sort 和 Bubble Sort 真正的差別。
Insertion Sort 的暫存動作有其必要性,假設把 const current = arr[i] 拿掉,直接在迴圈裡寫 arr[j + 1] = arr[j],第一次執行的時候 j + 1 剛好就是 i,於是 arr[i] 立刻被左邊的值蓋掉,那個原本要往左找位置的元素就這樣消失了。所以 current 要先被複製出來,那一格才能被當成空位安心覆蓋,這也是為什麼前面描述每一輪的時候,一直說是「取出」而不是「讀取」。
昨天算交換成本時提過,一次交換等於 3 次搬移,因為得先把其中一格暫存起來,再依序寫回兩個位置。往右挪一格則只要 1 次搬移,把左邊那格的值複製到右邊就好,左邊那格的舊值不需保留,等一下自然會被蓋掉。也就是說,Insertion Sort 是把交換裡那個暫存的動作提到整輪的最外面做一次,中間每一步只剩單純覆蓋,而 Bubble Sort 因為沒有這個暫存,每對調一次都得重來一遍完整的三步。
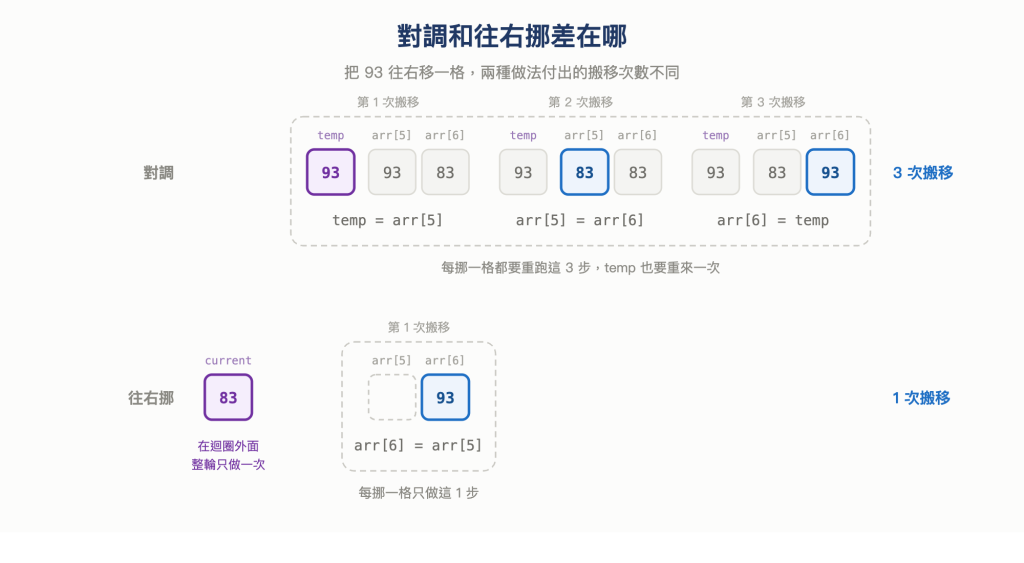
圖 5 移動同樣一格,對調要 3 次搬移,往右挪只要 1 次
而兩邊要移動的距離其實一模一樣,同一份輸入下,Insertion Sort 往右挪幾格,Bubble Sort 就交換幾次,差別只在每移動一格付出的搬移次數不同。
把 Best、Average 與 Worst Case 三種情況拆開來看看~
Best Case 是資料本來就排好的時候,這種輸入下,每一輪往左的第一次比較就會發現順序是對的,while 迴圈立刻結束,因此一輪只花 1 次比較、0 次挪動,8 個元素總共 7 次比較就跑完,時間複雜度是 O(N)。
另外,雖然一格都沒動,程式還是會執行 arr[j + 1] = current,而這時 while 迴圈一次都沒跑過,j 仍然是 i - 1,所以 j + 1 就是 i,等於把剛剛讀出來的值原封不動寫回它自己那格。這種寫回會發生 7 次,雖然不影響 O(N) 的結論,但也代表 Best Case 並不是完全不動資料。
Worst Case 則是完全反序的陣列,這時每一輪取出的元素都比左邊所有元素小,因此每一輪都得一路比到最左端,第 1 輪 1 次、第 2 輪 2 次,一路遞增到最後一輪的 7 次,加起來 28 次,而每一次比較都會伴隨一次挪動,挪動的格數也是 28。
把一輪裡會發生的事全部拆開來數,總共有四種:
| 步驟類型 | 8 個元素的次數 | 一般式 |
|---|---|---|
| 比較 | 28 | N(N-1)/2 |
| 往右挪 | 28 | N(N-1)/2 |
取出 current |
7 | N-1 |
| 放回空位 | 7 | N-1 |
| 合計 | 70 | N² + N - 2 |
後面兩項是每一輪固定做一次,7 輪就是 7 次,屬於低階項。因為 Big O 會忽略常數倍數、多項相加時只保留最高階項,N² + N - 2 套進去之後就只剩 N²,於是落在 O(N²)。
Average Case 介於兩者之間,平均而言每一輪大約走到已排序區的一半就會停下來,比較和挪動各約是 Worst Case 的一半,兩者加起來大約 N²/2 步,成長趨勢仍是 O(N²)。
不過這個「平均」是怎麼算出來的呢?它把 8 個元素能排出的 40,320 種順序都當成等可能,每一種都跑過一次再取平均。但實務上的資料很少長成隨機排列的樣子,照時間寫進去的紀錄本來就按時間排好、用 ORDER BY 從資料庫撈出來的清單也已經排過,前言那份評分清單更是排好之後才接上兩筆。這些輸入都比隨機排列還要有序,真正的成本會落在 Best Case 那一側,拿 Average Case 去估只會高估。也就是說,Average Case 是對輸入一無所知時才拿來參考的數字,一旦知道自己的資料大概長什麼樣,就該去看最接近的那一欄。
和昨天那兩個排序演算法對照一下:
| 演算法 | Best Case | Average Case | Worst Case |
|---|---|---|---|
| Selection Sort | N²/2 |
N²/2 |
N²/2 |
| Bubble Sort(加 early exit) | N |
3N²/4 |
N² |
| Insertion Sort | N |
N²/2 |
N² |
Selection Sort 三格都相同,因為它不管拿到什麼輸入都得全部掃描;Bubble Sort 和 Insertion Sort 則都從 N 到 N²,跨了兩個 Big O 類別。因此,目前只有 Selection Sort 的 Worst Case 在 N²/2,資料傾向反序時,反而是它成本較低。
Bubble Sort 的 Average Case 比 Insertion Sort 高一截,因為它的比較次數幾乎不會隨著資料變整齊而減少。不過光看這張表,Bubble Sort 和 Insertion Sort 的 Best 和 Worst 都一樣,在完全排好的輸入上也同樣只花 7 次比較,看起來差不多。既然如此,這兩個到底差在哪呢?
前言那份評分清單問的是,有沒有一種排序方式能利用「大部分元素已經在對的地方」這件事,只處理真正需要動的那幾筆。關鍵在資料的形狀,那份清單不是完全排好,只是幾乎排好,而這一格之差會讓結果完全不同:
| 輸入 | Insertion 比較 | Bubble 比較 | Selection 比較 |
|---|---|---|---|
[68, 72, 74, 81, 83, 85, 90, 93](完全排好) |
7 | 7 | 28 |
[68, 74, 81, 85, 90, 93, 83, 72](幾乎排好) |
16 | 28 | 28 |
[6, 5, 3, 1, 8, 7, 2, 4](Day 14 亂序) |
20 | 27 | 28 |
[8, 7, 6, 5, 4, 3, 2, 1](完全反序) |
28 | 28 | 28 |
第 2 列的 Bubble Sort 跑滿了 28 次,early exit 一次都沒觸發。為什麼只是多了兩筆資料,剛剛還只要 7 次比較的演算法就退回最差情況呢?
原因在 72 身上,它在陣列的最後一格,但它該去的位置是 index 1,中間隔了 6 格。Bubble Sort 每一輪由左往右掃,只交換相鄰的兩格,當它掃到 72 的時候會把 72 和左邊那格對調,可是掃描位置接著就往右走過去了,這一輪不會再回頭處理它。因此 72 一輪只能往左移動 1 格,要走完 6 格就得跑 6 輪,加上最後一輪確認沒有交換,7 輪全部跑完,early exit 沒省到任何力氣。
換句話說,Bubble Sort 的移動速度是不對稱的,往右邊送的元素可以在一輪之內連續交換好幾次、跑很遠,往左邊回來的元素一輪卻只能挪一格。而 Insertion Sort 沒有這限制,第 7 輪那次 while 迴圈一口氣就把 72 送到定位,因為它每一輪就是把一個元素往左送到定位為止。
那 Insertion Sort 的成本由什麼決定?昨天定義過「順序相反的配對」,從陣列裡任意挑兩個元素,只要排在前面的那個比後面的大就算一組,而且不必相鄰。當時數出 [6, 5, 3, 1, 8, 7, 2, 4] 有 16 組,Bubble Sort 就交換了 16 次。同樣的方法拿來數這份評分清單,74 和 81 右邊各有 1 個比它小的、85 和 90 和 93 各有 2 個、83 有 1 個,加起來是 9 組,而 Insertion Sort 就挪了 9 格。前面說過相同輸入下,Insertion Sort 往右挪幾格、Bubble Sort 就交換幾次,原因也在這,兩個數字量的其實是同一個東西。
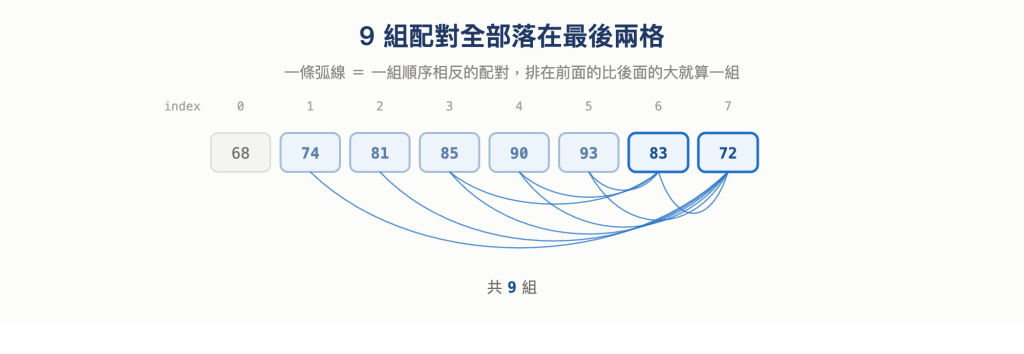
圖 6 [68, 74, 81, 85, 90, 93, 83, 72] 裡面順序相反的配對
這也是為什麼前面 Average Case 會落在 Worst Case 的一半。從陣列裡任意挑出兩個元素,它們的順序是反的機率大約就是一半,而長度 8 的陣列總共可以挑出 28 組配對,所以一個隨機順序的陣列平均會有大約 14 組順序相反的配對,剛好是完全反序那 28 組的一半。挪動的次數既然等於配對數,那平均要挪的格數自然也是 Worst Case 的一半。
像這種成本會隨著輸入本身的凌亂程度而改變的性質,稱為 adaptive。Insertion Sort 是 adaptive 的,資料越接近排好、順序相反的配對越少,它要做的工作就越少;Selection Sort 不是,它那三格都是 N²/2;Bubble Sort 則介於中間,加了 early exit 之後它認得出「完全排好」,卻認不出「幾乎排好」。
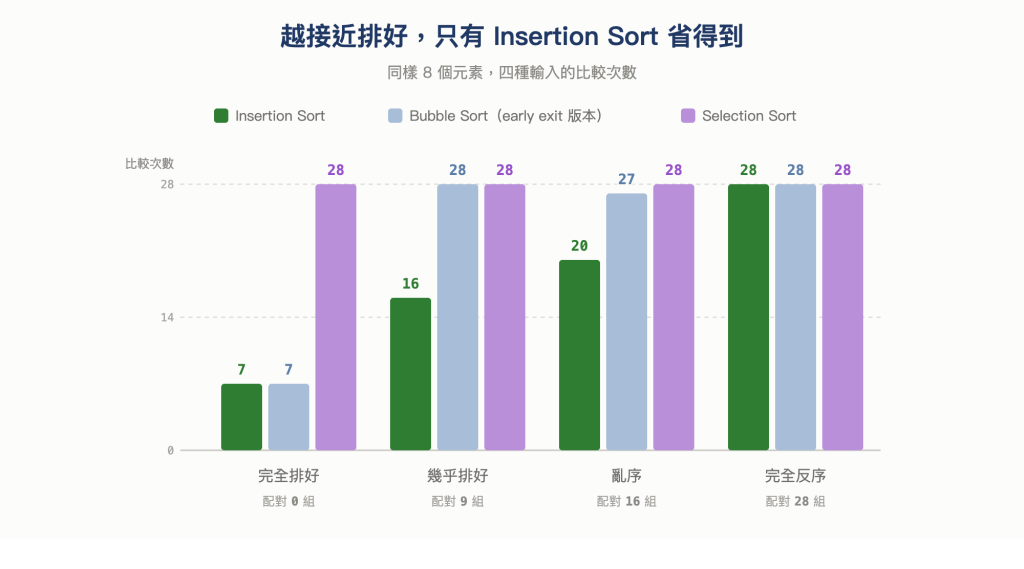
圖 7 輸入越接近排好,只有 Insertion Sort 的成本跟著往下掉
Insertion Sort 的空間複雜度比較單純,只需要 current 和 j 這兩個變數,不會隨著陣列變長而增加,Auxiliary Space 是 O(1),和昨天那兩個一樣屬於原地排序 (in-place sort)。程式裡的 [...array] 也只是為了不動到呼叫端傳進來的陣列,拿掉後就是原地排序。
因此它適合用在兩種情況:
O(N²) 和 O(N log N) 的差距還不大,而 Insertion Sort 的每一步成本都很低,程式也短。也因為這特性,不少實務上的排序在切到夠小的子陣列時會改用 Insertion Sort,切換的大小依實作而定。Insertion Sort 的內層迴圈本身就是一個「把單一元素插進已排序陣列」的操作,外層迴圈只是把它從 index 1 到最後一格重複執行而已。所以再回到前言那份清單,它的情境是「已經排好的資料又多了幾筆」,而如果新增的只有一筆,其實根本不必跑完整支排序。把新的分數接在陣列最後面,然後只執行 while 迴圈那一段,讓它往左找到位置插進去,一輪就結束了。這一輪的成本是 O(N),而且只有在新元素該往前放很多格的時候才會真的走到 O(N),如果它本來就比大部分元素大,幾次比較就停了。
不過資料量小並不等於 Insertion Sort 一定最快,真正決定成本的還是順序相反的配對有多少,以及實作和執行環境的細節。O(N²) 的成長速度不會因為資料少就消失,只是在資料少的時候還不明顯,一旦資料量往上走,它和之後要介紹的排序就不在同一個量級了。
小小總結一下今天對 Insertion Sort 的認識~
N²/2 步;Bubble Sort 加了 early exit 之後認得出完全排好的輸入,但認不出幾乎排好的;Insertion Sort 則是從 N 到 N² 連續變化,這個性質叫做 adaptive。實際使用時,還可以記住幾件事~
splice 寫出來的版本比較短,但挪動的成本只是被藏進方法呼叫裡,並沒有消失。要數操作次數時,把 while 迴圈寫出來比較明確可見。O(N²),比 Selection Sort 的 N²/2 還差,所以它的成本完全取決於輸入夠不夠整齊,整齊時省得多,反序時反而比 Selection Sort 高。到目前為止的三個排序,Worst Case 都是 O(N²),差別只在各自能不能利用輸入的形狀省力。下一篇要介紹的 Merge Sort 則不太一樣,它不管拿到什麼輸入都能保證 O(N log N),明天會來介紹~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術