
今天要介紹的是遞迴 (Recursion)~
昨天結尾提到,遞迴就是讓函式呼叫自己,每呼叫一次,call stack 就會再疊上一層。而這個東西其實更早以前就出現過,Day 03 談空間複雜度的時候用過這樣一段程式:
function sumTo(n) {
  if (n === 0) {
    return 0;
  }

  return n + sumTo(n - 1);
}
當時只說 sumTo(1000) 在算出結果前,必須先疊出 1000 層還沒完成的呼叫,所以額外空間是 O(N),至於那 1000 層實際上長什麼樣子、又是怎麼收回來的,就是今天要介紹的~
先看上面那段,把 sumTo 裡面的加法換成乘法,計算結果就變成階乘,所謂階乘就是把一個數字從自己一路乘到 1,例如 4! 就是 4 × 3 × 2 × 1,寫成程式碼的話,可以這樣寫:
function factorial(n) {
  if (n <= 1) return 1;
  return n * factorial(n - 1);
}
factorial 這個函式,在自己的函式定義裡又呼叫了一次自己。這種在函式內部呼叫自己的寫法,就是今天的主題「遞迴」。
先給一句話的定義:
遞迴 (Recursion) 就是用同一個函式,去處理一個規模更小、但形狀完全一樣的問題。
n 的階乘可以寫成「n 乘上 n-1 的階乘」,而 n-1 的階乘又可以寫成「n-1 乘上 n-2 的階乘」,同一句話套用在越來越小的輸入上,這就是遞迴。
這裡的「n-1 的階乘」有個專門的名字,叫做子問題 (subproblem),指的是把原問題套用到更小的輸入後、形狀完全沒有改變的那個問題。子問題和「另一個比較小的問題」不同,關鍵在形狀要一模一樣,因為只有形狀相同,才能交給同一個函式處理。也因此寫遞迴時,真正要找的東西是:這個問題的子問題是什麼。找到後,就可以寫出 solve(問題) = 這一層的計算 + solve(子問題) 這種骨架,階乘只是把「這一層的計算」填成乘上 n 而已。
為什麼要這樣繞一圈,而不直接寫個迴圈來解決呢?因為有一類問題事先不知道它有多深,舉例來說,巢狀資料夾下還有幾層子資料夾,要實際打開資料夾才知道。遞迴的好處是只要描述「這一步怎麼把問題變小、然後交給下一次呼叫」,至於底下到底有多深,它會自己一層層處理下去,不必先知道答案。
一個遞迴函式需同時具備三個部分:
示意圖如下:
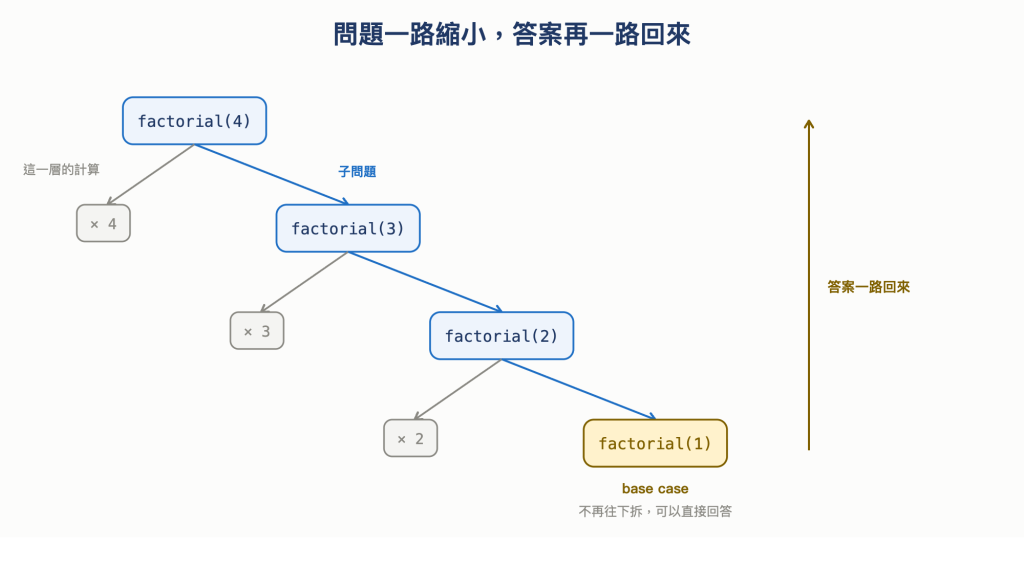
圖 1 問題一路縮小,答案再一路回來:每一層都拆成「這一層的計算」和一個更小的子問題
階乘其實同時做了兩件事:一邊往下把問題變小,一邊在回來的路上把結果乘起來。這兩件事一起看會比較難理解,所以我們先看簡單點的例子,倒數:
function countdown(n) {
  console.log(n);
  countdown(n - 1);
}
這段程式看起來很合理,印出目前的數字,然後把「數更小的」交給下一次呼叫,一路數下去。但它其實有個問題,它數到 0 之後不會停,而是繼續往 -1、-2 一路印下去,因為程式裡沒有任何一句告訴它什麼時候該停。原因在於它沒有 base case,補上 base case 之後才是完整版本:
function countdown(n) {
  if (n === 0) return; // base case:數到 0 就停
  console.log(n);
  countdown(n - 1); // recursive case:把「數更小的」交給下一層
}
countdown(3) 會印出 3、2、1 然後停下來,它的 base case 是「數到 0 就 return,不再往下」,recursive case 是「印出目前的數字,剩下的交給 countdown(n - 1)」。
那 countdown 需要等下一層帶什麼結果回來嗎?不用,它沒有回傳任何值,每一層做完自己的事、呼叫完下一層就結束了。所以它只有「往下」這個方向,沒有「往上收回來」的問題。比較容易讓人卡住的,通常是在回來的路上還需要把結果組合起來的那種遞迴,例如計算階乘。
再看一次前面那段 factorial:
function factorial(n) {
  if (n <= 1) return 1;
  return n * factorial(n - 1);
}
第一行是 base case,n 為 1 時就回傳 1;第二行是 recursive case,回傳 n 乘上 factorial(n - 1) 的結果。
關鍵在第二行的乘法沒辦法馬上算完,因為右邊的 factorial(n - 1) 這時還沒有值,得先讓那個更小的呼叫跑完才行。於是每一層 factorial 都只能先把「還有一個乘法沒完成」這件事放旁邊保存起來,再把控制權交給下一層,而這些被放旁邊的工作一份份疊起來,就是 Day 11 介紹過的 call stack。它們的堆放與收回嚴格照著後進先出,最後放上去的一定最先被拿回來處理。
接著來用 factorial(4) 走一遍流程看看~
factorial(4),此時要算 4 * factorial(3),但 factorial(3) 還沒有值,只好把「4 乘上某個東西」放旁邊、掛在 call stack 上等著factorial(3),此時要算 3 * factorial(2),一樣把「3 乘上某個東西」放旁邊等factorial(2),此時要算 2 * factorial(1),也放旁邊等factorial(1),此時碰到 base case,直接回傳 1,不再往下呼叫往下呼叫的過程中,這一疊是這樣變化的:
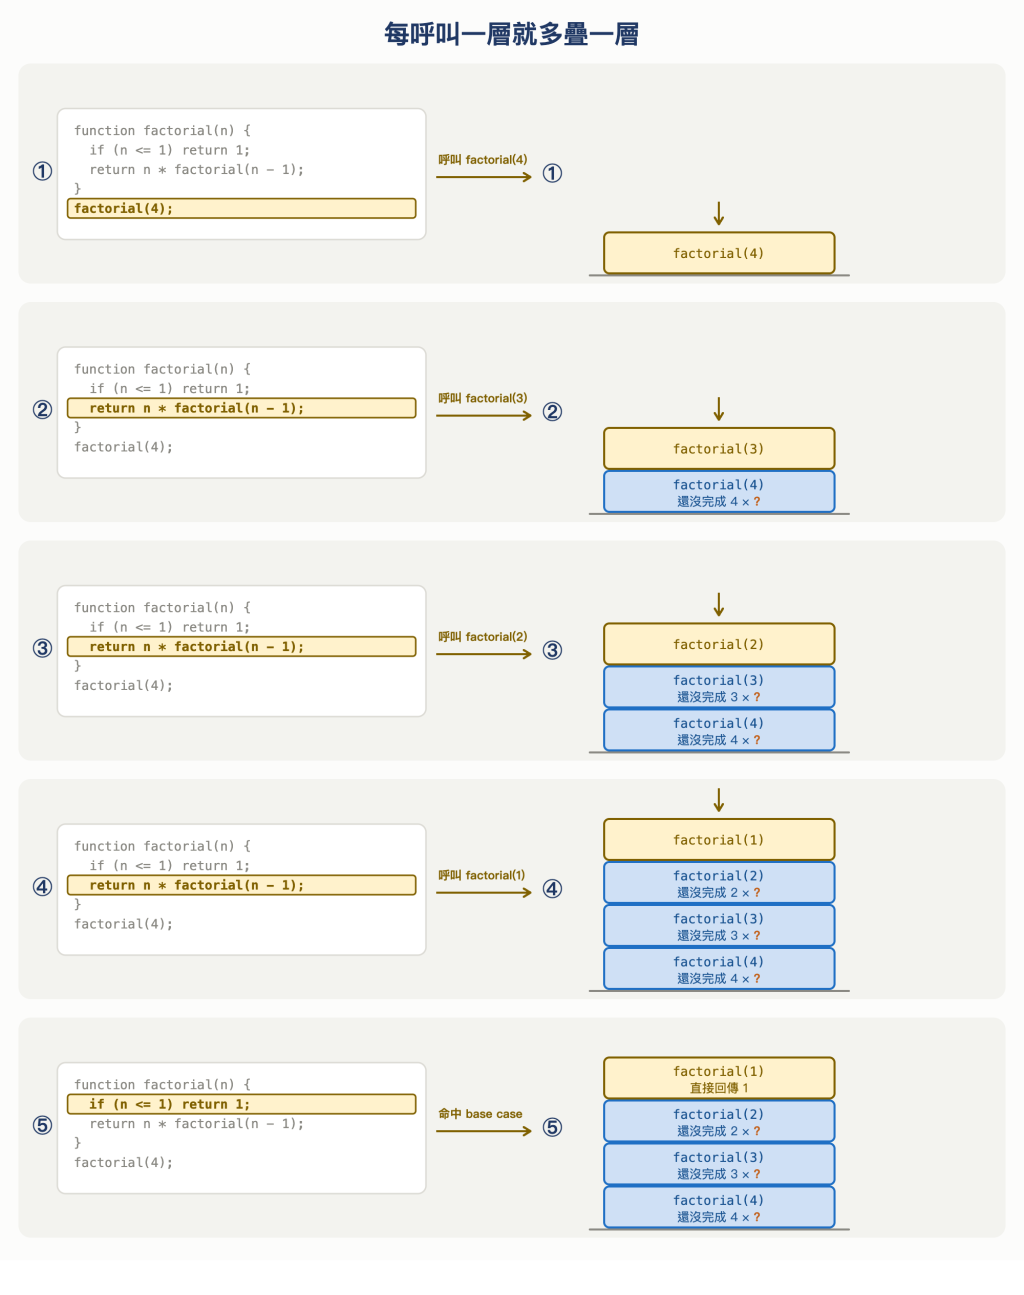
圖 2 每呼叫一層就多疊一層
觸底之後方向就反過來了:
factorial(1) 回傳 1
factorial(2) 接到 1,算出 2 * 1 = 2 回傳factorial(3) 接到 2,算出 3 * 2 = 6 回傳factorial(4) 接到 6,算出 4 * 6 = 24,這才是最初那個呼叫 factorial(4) 的答案這一疊收回來的過程如下:
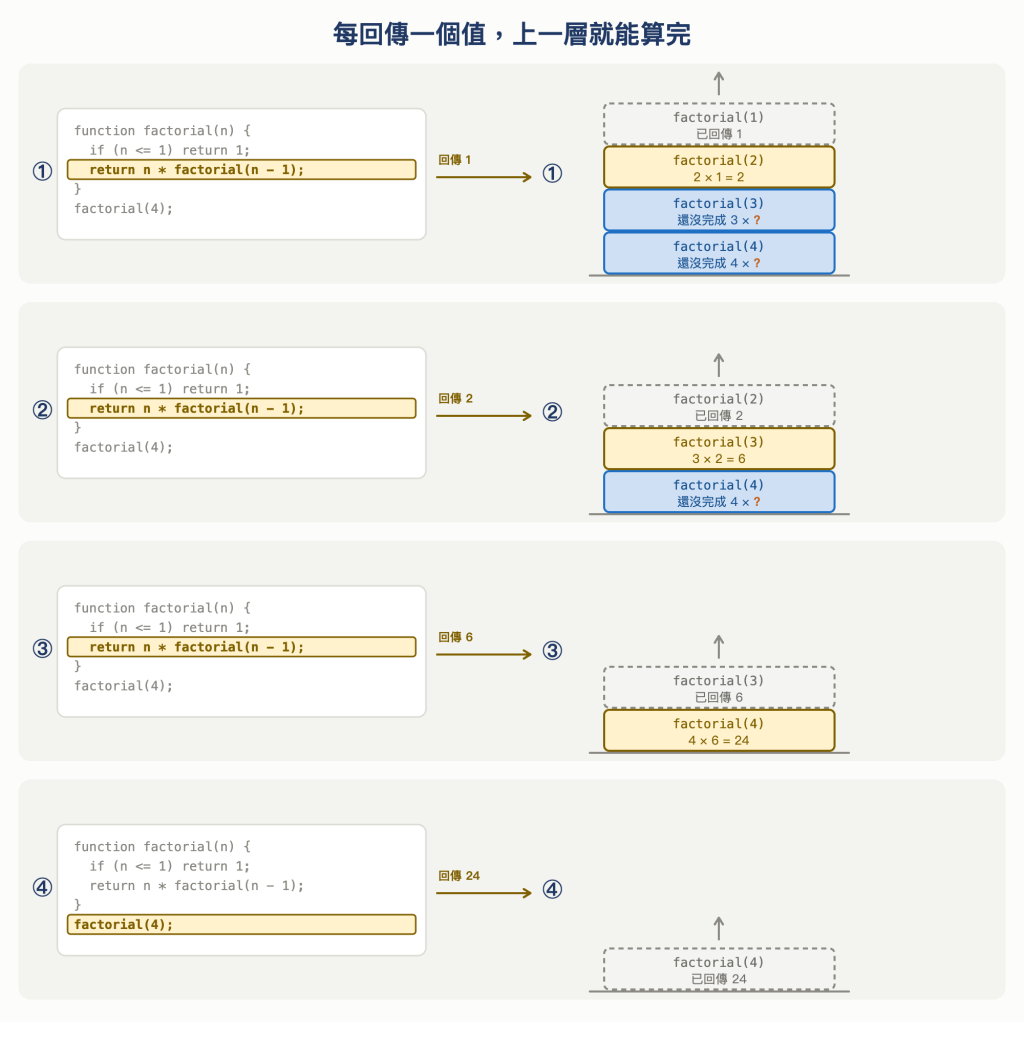
圖 3 每回傳一個值,上一層就能算完
這裡要注意的是,呼叫的順序和完成的順序是相反的,最先被呼叫的是 factorial(4),但它最後才算完;最後被呼叫的是 factorial(1),卻最先給出答案。往下走的是「把問題交給更小的自己」,往上走的是「把答案一層層填回尚未完成的計算」,這一來一回就是遞迴在做的事。
那函式呼叫自己,為什麼不會迷路呢?為什麼記得自己剛剛在算什麼?因為 call stack 上每一層 frame 都各自保管著自己那一份 n,以及「算完之後要把結果交給誰」。就算 factorial(4) 到 factorial(1) 這四個呼叫同時存在,它們用的也是四份彼此獨立的區域狀態,不會互相覆蓋。所謂遞迴「不會迷路」,其實是 call stack 幫每一層都留了一張各自的便條,程式只是照著這疊便條,先由上往下、再由下往上走過一遍而已。
補充:一層「便條」到底存了什麼
Day 11 介紹 call stack 時提過,這一疊的每一層叫做執行環境 (execution context),裡面放著那一層自己的變數、
this,以及「做完要回到哪裡」。遞迴也是如此,factorial(4)到factorial(1)雖然是同一個函式,卻對應四個各自獨立的執行環境,四份不同的n同時存在、彼此不干擾;函式一回傳,那一層就從 stack 上被移除。
前面那個沒有 base case 的 countdown,實際執行時會一路印出負數,而現在知道 call stack 之後就會發現,真正發生的事不只是無法停止的列印負數,仔細一想,每呼叫一次就往上疊一層,這疊只長高、沒有東西被收回來,最後就會是 Day 11 那個 RangeError: Maximum call stack size exceeded,也就是 stack overflow。換句話說,base case 是遞迴唯一的煞車,它讓程式得以停止。
另外一種寫錯遞迴的方式,是 base case 明明存在、卻永遠碰不到。假設條件寫成 if (n === 0),但每次都減 2、而 n 從奇數開始,那 n 會從 3 跳到 1 再跳到 -1,一路越過 0,一樣無法停止。base case 不只要存在,還要確保 recursive case 縮小問題的方式一定會抵達它。
前面逐步驟檢視 factorial(4) 的流程,是為了更理解詳細運作,但真正在讀或寫遞迴時,不一定每次都要在腦中追蹤整疊 call stack,這裡有一些小技巧~
先看怎麼讀一段遞迴程式~可分兩種方式來理解。
第一種是從 base case 往上推,先確定最小的那個情況給出什麼答案,再用它去推下一個情況,一路往上推到看得懂為止:
factorial(1) = 1
factorial(2) = 2 × factorial(1) = 2 × 1 = 2
factorial(3) = 3 × factorial(2) = 3 × 2 = 6
factorial(4) = 4 × factorial(3) = 4 × 6 = 24
這樣推的好處是每一層都只用到前一層已經算好的結果,不必把整串乘法重新展開一次,等於把一個會自我呼叫的函式,換算成一連串已知的數字,推個兩三層通常就足以確認這個遞迴的運作了。
第二種讀法的方向則相反,不需要自己跳進更小的那個呼叫裡,只要「相信」它會給出正確答案就好。以 factorial 為例,讀到 return n * factorial(n - 1) 這一行時,不必真的去想 factorial(n - 1) 內部怎麼跑,只要假設它已經正確算出了 (n-1)!,那這一行做的就是把它乘上 n,n * (n-1)! 的結果就是 n!。
真正要檢查的只有兩件事:
factorial(1) 回傳 1 是對的)n 是對的)這兩件事都成立,整個遞迴就是對的。
這兩件事可能有點眼熟,因為 Day 04 談正確性時見過類似的東西,那時候用的名字叫數學歸納法:先證明第一個情況成立,再證明「第 k 個成立就推得出第 k+1 個成立」。base case 對應第一步,把子問題的答案正確組合起來對應第二步,兩件事都成立,就有一條推論路徑可以從最小情況一路通到手上這個 n。而前面那種由下往上推的讀法,就是把這條路徑實際走個兩三層,不熟的時候先推、熟了之後就能直接信任。
如果要自己寫遞迴,該如何下手呢?可透過兩個問題來釐清流程:
釐清這兩個問題後,就能寫出遞迴。
以反轉字串為例。最小的情況是空字串,反轉之後還是空字串,這是 base case;至於一般情況,只要把「第一個字元以外的部分」反轉好,再把第一個字元接到尾端就完成了,這是 recursive case:
function reverse(str) {
  if (str === '') return '';
  return reverse(str.slice(1)) + str[0];
}
用剛剛那個「相信更小的呼叫」的讀法來檢查看看,假設 reverse(str.slice(1)) 已經正確把「第一個字元以外」的部分反轉好了,那把 str[0] 接到它後面,整個字串就反轉完成了,而空字串這個 base case 也對,所以這個函式是對的。
實際跑 reverse("abc") 看看,往下的過程是這樣:
reverse("abc") 要算 reverse("bc") + "a",但 reverse("bc") 還沒有值,只好把「等一下要接上 "a"」放旁邊等reverse("bc") 要算 reverse("c") + "b",把「等一下要接上 "b"」放旁邊等reverse("c") 要算 reverse("") + "c",把「等一下要接上 "c"」放旁邊等reverse("") 碰到 base case,直接回傳 "",不再往下呼叫觸底之後方向也反過來,把放旁邊的那些字元依序接回尾端:
reverse("") 回傳 ""
reverse("c") 接到 "",算出 "" + "c" = "c" 回傳reverse("bc") 接到 "c",算出 "c" + "b" = "cb" 回傳reverse("abc") 接到 "cb",算出 "cb" + "a" = "cba",這才是最初那個呼叫的答案和階乘比較,會發現兩個結構長得很像:
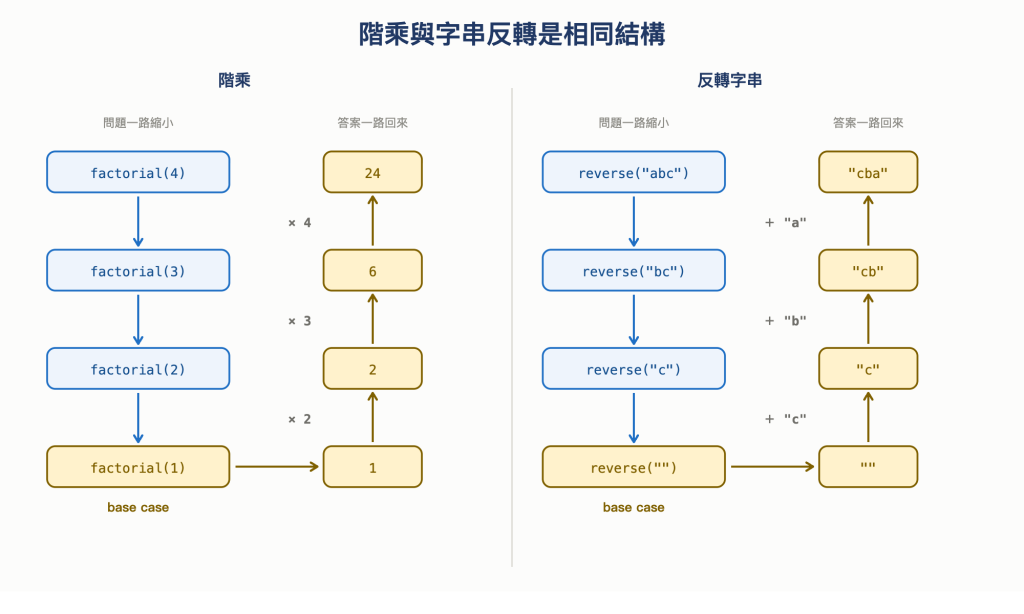
圖 4 階乘與字串反轉是相同結構
寫遞迴時還有一個常用技巧,叫做傳入額外參數 (passing extra parameters)。因為遞迴沒有迴圈那種共用變數,想在過程中累積結果,就要把目前累積到的東西當成一個參數往下傳,這個參數通常稱為累加器 (accumulator)。還是那個階乘函式,用這個技巧會寫成這樣:
function factorial(n, acc = 1) {
  if (n <= 1) return acc;
  return factorial(n - 1, n * acc);
}
這裡的 acc 一路把「到目前為止乘出來的積」帶著往下走。同樣算 factorial(4),過程如下:
factorial(4, 1),先算好 4 × 1 = 4,把它當成新的 acc 交給 factorial(3, 4)
factorial(3, 4),算好 3 × 4 = 12,交給 factorial(2, 12)
factorial(2, 12),算好 2 × 12 = 24,交給 factorial(1, 24)
factorial(1, 24) 碰到 base case,直接回傳 acc,也就是 24
示意圖如下:
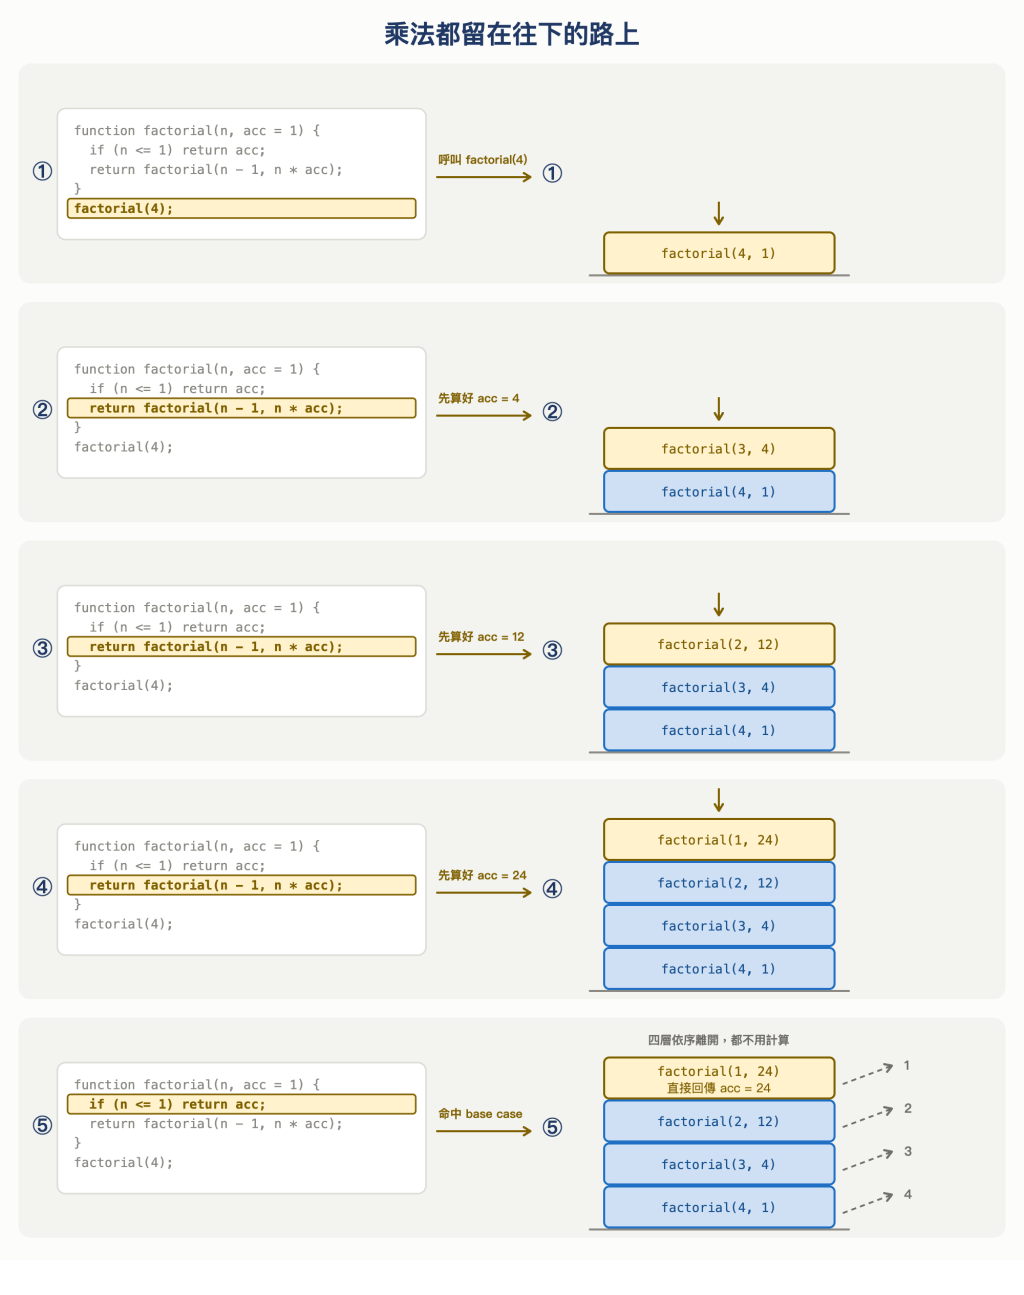
圖 5 乘法都留在往下的路上:沒有任何一層在等乘法
base case 可分為兩種寫法,前面的階乘寫成 if (n <= 1) return 1,這是把最小的輸入直接列出來。
另一種寫法是把條件往下移一格、寫成 if (n === 0) return 1,這時靠的是數學上 0! = 1 這個定義:有了這個值,factorial(1) 會算成 1 × factorial(0) 而自己得到 1,不必再單獨為 1 寫一條回傳值。
兩種寫法算出來的答案相同,差別在於前者是把已知的答案寫下來,後者是挑一個能讓遞迴公式自己成立的值。前者好懂,後者精簡,實際應用時可看情況撰寫。
遞迴和迴圈能做的事完全相同,換句話說,任何能用遞迴寫出來的東西,都能改用迴圈寫出來,反之亦然。
把前面的階乘改寫成迴圈,程式會長這樣:
function factorialIterative(n) {
  let result = 1;
  for (let i = 2; i <= n; i++) {
    result = result * i;
  }
  return result;
}
兩個版本算出來的答案完全相同。
為何遞迴和迴圈可以互換表達呢?理由就在 call stack 本身。遞迴能記住每一層還沒做完的事,靠的是引擎替它維護的那一疊 call stack。既然它是一個 Stack,那自己宣告一個、把同樣的東西放進去,自然也能做到同一件事。因此「遞迴做得到而迴圈做不到」的情況並不存在,差別只在那疊還沒完成的工作由誰管理。
寫法互換有各自的代價,而代價藏在狀態被儲存的地方,迴圈版把「目前累積到多少」放在 result 這個變數裡,一層迴圈就地更新它;遞迴版沒有這個共享的變數,它把每一步還沒算完的狀態,分散保存在 call stack 一層層的 frame 上。
補充:遞迴與 functional programming
在 functional programming 的世界裡,比起迴圈,其實更常看到遞迴的寫法,因為 functional programming 偏好拆解問題為子問題,然後再把小問題組合起來以解決更大的問題,如 fp-ts 作者在這篇所說,組合(Composition)是 functional programming 的核心,而遞迴的寫法有利於組合,因此在 functional programming 的世界,會更偏好遞迴寫法。
既然可以互換,那什麼時候該用遞迴、什麼時候該用迴圈?答案是,事先不知道問題有多深、迴圈要執行幾次時,通常可用遞迴。
舉例來說,巢狀資料夾走訪,實際走訪深度要走過才知道,用迴圈不好寫,用遞迴卻能直覺理解:
function printAllFiles(dir) {
  for (const entry of listEntries(dir)) {
    if (isDirectory(entry)) {
      printAllFiles(entry); // 是子資料夾就往下鑽,深幾層都不必事先知道
    } else {
      console.log(entry);
    }
  }
}
這裡的 listEntries 與 isDirectory 是假設有的工具函式,重點在遞迴那行:碰到子資料夾,就把它整個交給下一層的自己去處理,資料夾嵌了幾層,call stack 就自然疊幾層,程式碼完全不用管深度。
那如果一定要用迴圈呢?也可以,但需要自己準備一個 Stack,儲存還沒處理的資料夾,再用 while 迴圈一個個拿出來處理,而那正是 Day 11 介紹過的 Stack:
function printAllFiles(dir) {
  const stack = [dir]; // 自己開一個 stack,放還沒處理的資料夾
  while (stack.length > 0) {
    const current = stack.pop();
    for (const entry of listEntries(current)) {
      if (isDirectory(entry)) {
        stack.push(entry); // 子資料夾先記下來,等一下再處理
      } else {
        console.log(entry);
      }
    }
  }
}
這個版本也能走訪所有檔案,兩種版本示意圖如下:
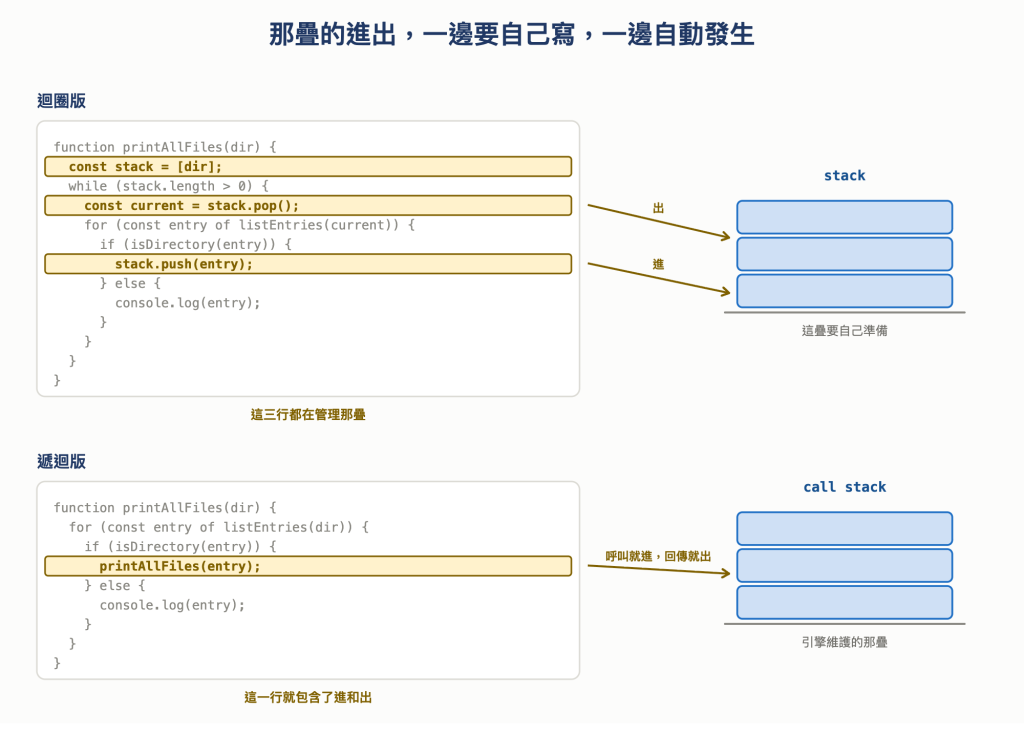
圖 6 那疊的進出,一邊要自己寫,一邊自動發生
換句話說,遞迴省下的其實是「要不要自己管理那疊 stack」。
前面的階乘改成迴圈時,不需要自己管理 stack,為什麼巢狀資料走訪就要自己管理 stack 呢?差別在於每一層還沒完成的工作,能不能被壓成一個值。階乘每一層在等的只是一個乘數,往下走的時候順手乘進 result 即可,走完就結束,不會留下還沒完成的東西;走訪資料夾每一層在等的卻是「這一層還沒看完的一整排項目」,壓不成一個值,只能整批存在變數裡。
把兩種寫法擺在一起看,差別如下:
| 面向 | 迴圈 | 遞迴 |
|---|---|---|
| 怎麼重複 | 靠迴圈自己的控制條件 | 函式用更小的輸入呼叫自己 |
| 什麼時候停 | 迴圈條件不成立 | 抵達 base case |
| 還沒完成的狀態放哪 | 自己宣告的變數 | 引擎維護的 call stack |
| 固定次數的重複 | 直接寫就好 | 做得到,但通常不會更清楚 |
| 深度未知的結構 | 得自己準備一個 Stack | 自然往下深入,不必先知道有幾層 |
| 主要風險 | 終止條件寫錯會變成無窮迴圈 | 少了 base case 會 stack overflow |
因此遞迴的好處在於,讓「深度未知」這件事不必寫進程式裡。代價則有兩個,一個是那疊 call stack 要佔空間、而且有上限;另一個則是對不熟遞迴的人來說,這種寫法也許需要花些時間理解。因此固定次數的重複通常用迴圈就好,不必因為遞迴寫起來比較短就改寫。
接著來看看時間與空間複雜度~
先看時間,遞迴版 factorial(n) 從 n 一路呼叫到 1,總共呼叫 n 次,每次只做一個乘法,所以是 O(N)。迴圈版跑 n 次迴圈,一樣是 O(N)。
不過遞迴的時間複雜度不一定這麼單純,有些寫法會重複計算同一批子問題,導致處理時間變長,這個問題會留到之後談動態規劃時再說明。
再來看空間,這裡兩個版本就不同了。迴圈版從頭到尾只用了 result 一個變數,不管 n 多大都是 O(1);遞迴版在觸底之前,call stack 上同時掛著 n 層還沒算完的 frame,每一層都佔一份空間,所以是 O(N)。
兩邊的額外空間各自存在哪裡:
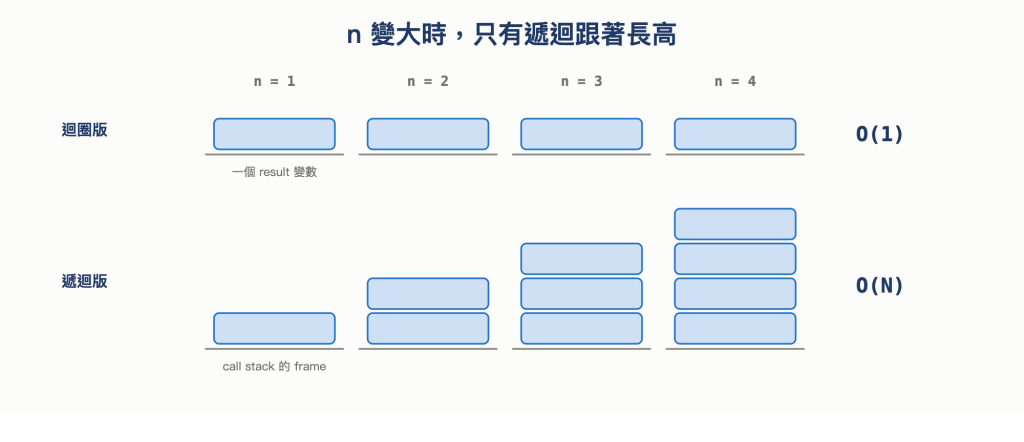
圖 7 n 變大時,只有遞迴跟著長高
剛剛算出遞迴版階乘的額外空間是 O(N),那這筆成本有沒有機會省掉呢?有機會,但得先把遞迴改成「尾呼叫」的形狀,才有機會由引擎進行尾呼叫最佳化 (Tail Call Optimization, TCO)。先來看看尾呼叫是什麼:
尾呼叫 (Tail Call) 是指一個函式的最後一個動作就是呼叫另一個函式,而且那個呼叫回來之後,這一層不需要再做任何計算。
判斷時可以先看 return 後面接什麼,return factorial(n - 1, n * acc) 是尾呼叫,因為回傳的就是那次呼叫的結果;return n * factorial(n - 1) 則不是,因為呼叫回來之後,這一層還有一個乘法沒做完。
前面用 acc 往下傳的階乘,每一層都在呼叫下一層之前先算好新的 acc,等它把 acc 交給下一層,這一層就沒有尚未完成的工作了。既然不需要再回來,引擎就可以在進入下一次呼叫前,先把目前的 stack frame 移除,或直接把它的空間交給下一次呼叫重複使用。
如果引擎有做這項最佳化,這個遞迴過程就不會一路累積 stack frame,額外空間便能從 O(N) 降成 O(1),也不會因為遞迴太深而撞上 call stack 的上限。時間複雜度則不會改變,因為該做的 n 次計算還是都要做,仍然是 O(N)。
不過這裡要注意的是,寫成尾呼叫,只是讓程式具備被最佳化的條件;真正會不會省掉 stack frame,還要看引擎有沒有實作。
在 ECMAScript 規格裡,這項保證稱為 proper tail calls (PTC),而且還有一個條件:只有嚴格模式 (strict mode) 中的呼叫,才可能被判定為規格所說的尾位置。ECMA-262 §15.10 Tail Position Calls 定義了哪些呼叫算在尾位置,也規定進入這種呼叫之前,要先釋放當前這一層佔用的資源。因此若要讓一般 script 裡的程式符合這項規格,還得開啟 'use strict'。
規格有寫,不代表執行引擎真的有實作。目前常見執行環境對這項機制的支援並不一致,可參考這篇的一些實測數據,另外關於 V8 沒有提供實作的歷史脈絡與詳細資訊可參考 WebKit 介紹 proper tail calls 的文章,以及 V8 說明 ES2015 實作狀況的文章。
所以分析程式時,不能只看程式碼是不是尾呼叫,還要考慮執行環境的實作狀況,有 proper tail calls 的引擎可以是 O(1);沒有的話,call stack 仍會隨遞迴深度增長,空間複雜度還是 O(N)。
小小總結一下今天對遞迴的認識~
實際使用時,還可以記住幾件事~
n 就是 O(N),而把狀態收在單一變數的迴圈版才是 O(1)。圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術