
大部分語言都有內建的排序方法,JavaScript 也不例外,呼叫 array.sort() 以後,就能把陣列排好,那為什麼還要了解排序演算法呢?
其中一個理由是資料量。幾十筆資料不管用什麼方式排序都很快,也看不出執行時間或空間的差別,但當一個系統要處理的是幾千萬筆商品、影片或使用者紀錄時,排序就從「順手做一下」變成一筆需要事先評估的成本,這時如果我們知道這排序演算法實際做了哪些工作,才有辦法判斷系統能否撐住,也才知道資料量再翻幾倍的時候會發生什麼事。
另一個理由是排序本身其實是一種前置處理,資料排好之後,後面的操作也會享受到好處,Day 06 的 Binary Search 就是個例子,它能在幾步之內從幾百萬筆裡找到目標,唯一的前提就是資料已排序過。因此,隨著要處理的資料越來越多,排序 (sorting) 與搜尋 (searching) 就成了兩件會反覆出現的基本工作,了解這些基本工作背後的原理,有助於我們進一步思考程式或系統的優化方向。
今天要介紹的是兩個入門的排序演算法:Bubble Sort 與 Selection Sort。它們的時間複雜度都是 O(N²),乍看之下很像同一個解法的兩種寫法,實際差異在哪呢?接下來就來看看~
從 Bubble Sort 開始,先用一句話定義 Bubble Sort:
Bubble Sort(氣泡排序):反覆比較相鄰的兩個元素,順序不對就交換,讓最大的元素逐輪浮到尾端。
它一次只看兩個相鄰的位置,每一步要做的判斷都只有「這兩個要不要換」,既不需要記住掃描過程中的任何資訊,也不需回頭看之前的結果。
Bubble Sort 的做法可以拆成三步:
像這樣從頭掃到尾走一趟,以下稱為一輪。每跑完一輪,還沒排好的那一段裡最大的元素就會落到那一段的尾端,下一輪的範圍再往左縮一格。
用 [6, 5, 3, 1, 8, 7, 2, 4] 這個陣列來走一遍看看。先從最左邊的那一對開始,也就是 index 0 和 index 1,比完之後把要比較的位置往右移一格、改看 index 1 和 index 2,就這樣一路往右走到底:
6 和 5,左邊比較大,所以兩者交換,陣列變成 [5, 6, 3, 1, 8, 7, 2, 4]。6 和 3,左邊比較大,再交換一次,得到 [5, 3, 6, 1, 8, 7, 2, 4]。6 和 1,一樣交換,得到 [5, 3, 1, 6, 8, 7, 2, 4]。可看出 6 一直跟著比較的位置往右走,因為它比沿路遇到的每一個元素都大。6 和 8,左邊比較小,所以兩者不動,陣列維持 [5, 3, 1, 6, 8, 7, 2, 4]。8 和 7,左邊比較大,交換,得到 [5, 3, 1, 6, 7, 8, 2, 4]。8 和 2,左邊比較大,交換,得到 [5, 3, 1, 6, 7, 2, 8, 4]。8 和 4,左邊比較大,交換,得到 [5, 3, 1, 6, 7, 2, 4, 8],比較的位置也到了陣列的尾端,這一輪結束。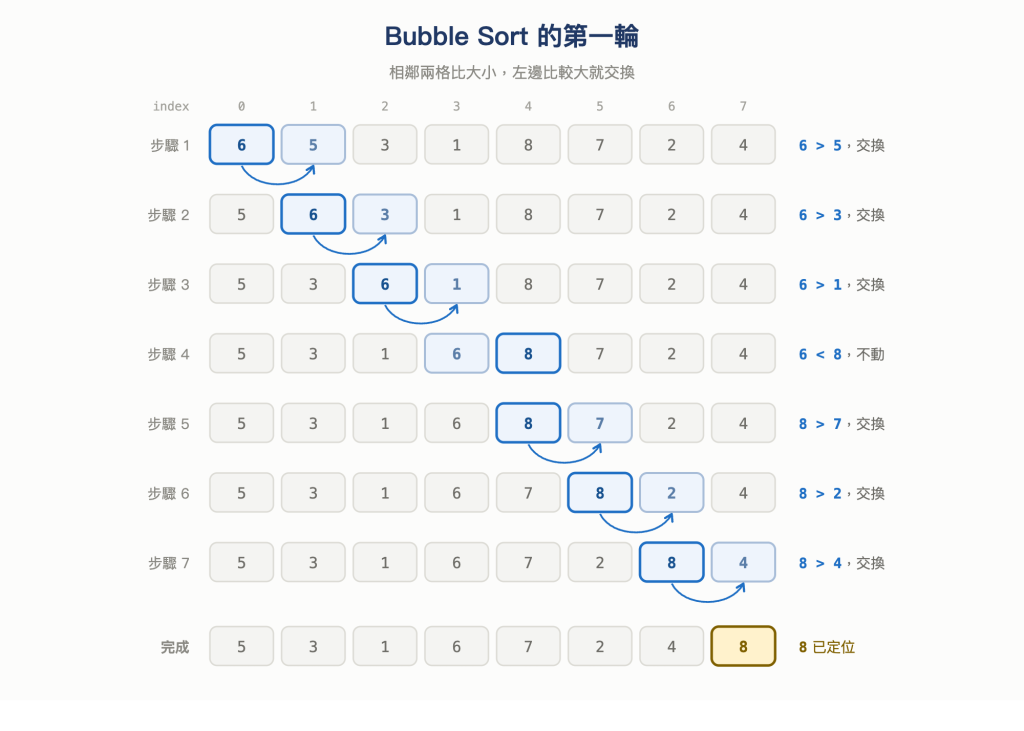
圖 1 Bubble Sort 的第一輪,7 次比較把 8 一路推到尾端
這一輪總共做了 7 次比較,換來一件確定的事:8 已經站在它最終的位置上。因為 8 是整個陣列裡最大的元素,只要比較的位置移到它身上,之後的每一次比較它都會贏、都會被往右推,所以它一定會一路被推到最右邊。同樣的道理對任何輸入都成立,也就是說每跑完一輪,還沒排好的那一段裡最大的元素就一定會落到那一段的尾端。
既然尾端那一格已確定在最終位置,下一輪就不需再理它,比較的範圍可以往左縮一格;而第 2 輪跑完之後,倒數第二格也會確定,比較的範圍就再少一格。整個過程如下:
| 輪次 | 這一輪結束後的陣列 | 尾端已經定位的元素 |
|---|---|---|
| 第 1 輪 | 5, 3, 1, 6, 7, 2, 4, 8 |
8 |
| 第 2 輪 | 3, 1, 5, 6, 2, 4, 7, 8 |
7, 8 |
| 第 3 輪 | 1, 3, 5, 2, 4, 6, 7, 8 |
6, 7, 8 |
| 第 4 輪 | 1, 3, 2, 4, 5, 6, 7, 8 |
5, 6, 7, 8 |
| 第 5 輪 | 1, 2, 3, 4, 5, 6, 7, 8 |
4, 5, 6, 7, 8 |
| 第 6 輪 | 1, 2, 3, 4, 5, 6, 7, 8 |
3, 4, 5, 6, 7, 8 |
| 第 7 輪 | 1, 2, 3, 4, 5, 6, 7, 8 |
2, 3, 4, 5, 6, 7, 8 |
最後一輪跑完後,只有 index 0 那一格沒被列進來,但它左邊已經沒有任何元素了,剩下的那一個就是最小的,不用比也一定在最終位置上,因此外層迴圈跑到倒數第二格就可以結束。
其實第 5 輪結束時,陣列就已經完全排好了,但第 6、7 輪還是會按照原本的安排跑完,這兩輪沒有改變任何東西,卻仍然把該比的每一對都比了一遍。
將上面那段流程寫成程式如下。
function bubbleSort(array) {
  const arr = [...array];

  for (let end = arr.length - 1; end > 0; end--) {
    for (let i = 0; i < end; i++) {
      if (arr[i] > arr[i + 1]) {
        [arr[i], arr[i + 1]] = [arr[i + 1], arr[i]];
      }
    }
  }

  return arr;
}
外層的 end 就是那個逐輪往左縮的邊界,它每跑完一輪就減一,內層迴圈就跟著少比一次;而 arr[i] > arr[i + 1] 則是主要的判斷邏輯,條件成立就交換,不成立就往右繼續。整段程式沒有額外的變數需要維護。
再來看看 Selection Sort,一樣先給一句話定義:
Selection Sort(選擇排序):每一輪從尚未排序的範圍裡找出最小的元素,把它放到已排序區的尾端。
Day 04 為了說明 loop invariant,曾分析過一段「找出最便宜那筆訂單」的程式,裡面用 minpos 變數記住目前看過的最小值在哪一格。而 Selection Sort 的內層迴圈做的就是同一件事,差別只在於它找到之後不是把結果回傳,而是把那個元素換到前面,然後對剩下的範圍再做相同的事。
Selection Sort 的每一輪也可以拆成三步,掃描的過程中需要一個地方記住「目前看過最小的那一格在哪裡」,這裡把它叫做 minIndex:
minIndex 指著它minIndex 指著的還小的元素,就把 minIndex 改成那一格minIndex 指著的元素和這一輪範圍的第一格交換每跑完一輪,還沒排好的那一段裡最小的元素就會落到那一段的最前面,下一輪的範圍再往右縮一格。
用同一個陣列 [6, 5, 3, 1, 8, 7, 2, 4] 來試跑流程。第 1 輪先假設 index 0 的 6 是最小的,也就是 minIndex 從 0 開始,然後從 index 1 往右掃:
5,比 minIndex 目前指著的 6 小,minIndex 就改成 1。3,比 5 更小,minIndex 改成 2。1,又更小了,minIndex 改成 3。8,比 1 大,minIndex 不動。7,一樣比 1 大,minIndex 不動。2,還是比 1 大,minIndex 不動。4,仍然比 1 大,minIndex 不動,掃描到此結束。掃完之後才知道這一輪的最小值是 index 3 的 1,這時才把它和 index 0 的 6 交換,得到 [1, 5, 3, 6, 8, 7, 2, 4]。這裡要注意的是,這一輪和 Bubble Sort 一樣,看過了整個未排序區、做了 7 次比較,但從頭到尾只發生一次交換,且交換是等到掃描全部結束之後才發生的,掃描期間陣列完全沒有被動過。
第 2 輪的做法一樣,只是起點往右移一格。這次先假設 index 1 的 5 是最小的,也就是 minIndex 從 1 開始,然後從 index 2 往右掃:
3,比 minIndex 目前指著的 5 小,minIndex 改成 2。6,比 3 大,minIndex 不動。8,一樣比 3 大,minIndex 不動。7,還是比 3 大,minIndex 不動。2,比 3 小,minIndex 改成 6。4,比 2 大,minIndex 不動,掃描到此結束。掃完之後把 index 6 的 2 和 index 1 的 5 交換,得到 [1, 2, 3, 6, 8, 7, 5, 4]。這一輪掃了 6 次比較,因為 index 0 已經定位、不必再看。
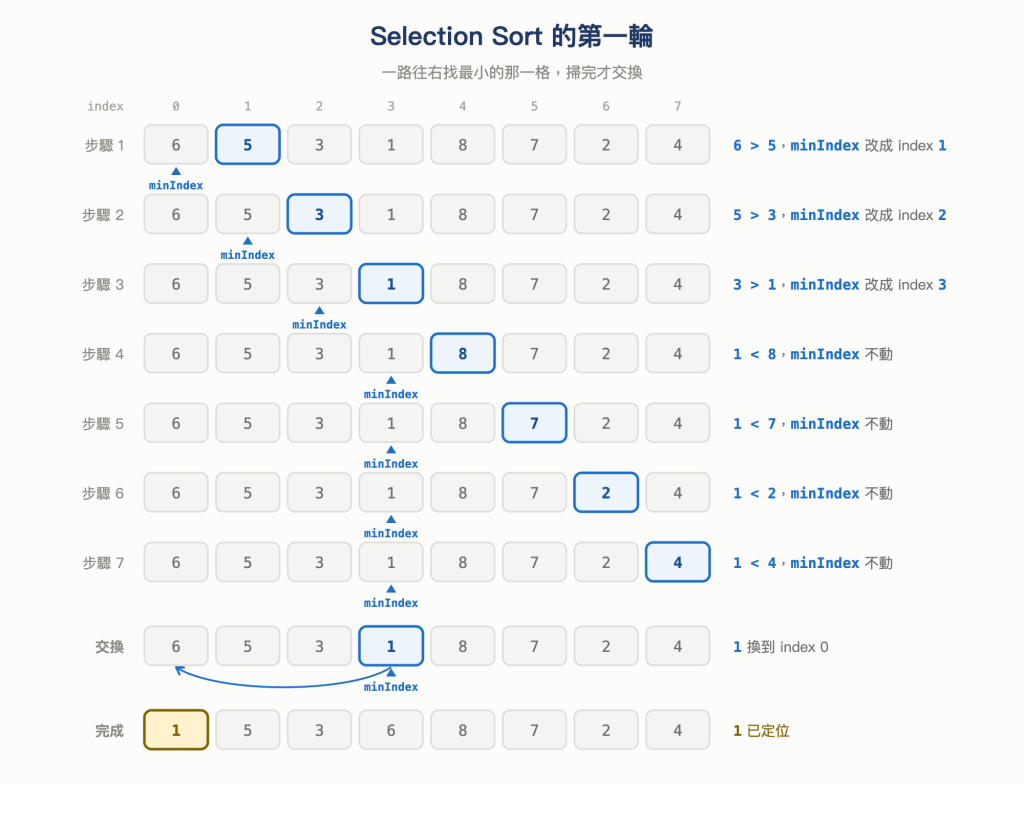
圖 2 Selection Sort 的第一輪,掃完 7 次比較才發生一次交換
第 3 輪的起點是 index 2,掃描範圍是 3, 6, 8, 7, 5, 4 這幾格。先假設 index 2 的 3 是最小的,接著往右掃過 6、8、7、5、4,沒有任何一個比 3 小,所以 minIndex 從頭到尾都停在 2 沒有動過。
這一輪掃了 5 次比較,卻不需要任何交換,陣列維持 [1, 2, 3, 6, 8, 7, 5, 4] 原樣。也就是說,Selection Sort 每一輪的交換次數是「最多 1 次」而不是「剛好 1 次」,因為當最小值本來就在它該在的位置上時,就能省下交換。
將上面那段流程寫成程式如下:
function selectionSort(array) {
  const arr = [...array];

  for (let i = 0; i < arr.length - 1; i++) {
    let minIndex = i;

    for (let j = i + 1; j < arr.length; j++) {
      if (arr[j] < arr[minIndex]) {
        minIndex = j;
      }
    }

    if (minIndex !== i) {
      [arr[i], arr[minIndex]] = [arr[minIndex], arr[i]];
    }
  }

  return arr;
}
Bubble Sort 和 Selection Sort 都是兩層迴圈,乍看很像,但內層在做的事情其實不同,兩者相異處如下:
minIndex 這個索引,整輪掃描期間陣列本身沒有被動過。Bubble Sort 和 Selection Sort 的外層迴圈都有一個逐輪縮短的範圍,可以用 Day 04 的 loop invariant 來看看為何這範圍可以逐步縮短。先看 Bubble Sort:
在每一輪開始之前,
arr[end + 1 .. n - 1]裡的元素都已經在最終位置上,而且它們都不小於左邊剩下的每一個元素。
再看 Selection Sort:
在每一輪開始之前,
arr[0 .. i - 1]裡的元素都已經在最終位置上,而且它們都不大於右邊剩下的每一個元素。
兩句話的結構幾乎一樣,都是在說「陣列有一段已經定案了,剩下的那段還沒」,也就是前面一直在講的已排序區。兩個排序演算法只差在已排序區從哪一端開始延伸:Bubble Sort 從尾端往左,Selection Sort 從前端往右。
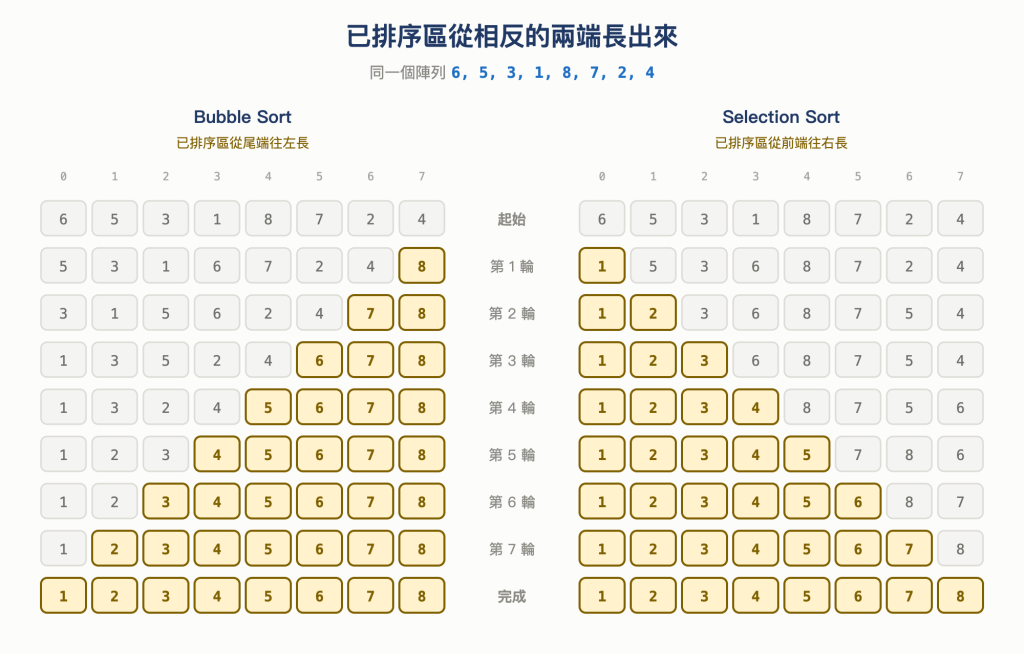
圖 3 已排序區逐輪變大,但兩者的方向相反
更進一步用 Day 04 的三步法檢查一下這兩個排序演算法~
Initialization:第一輪開始之前,兩邊的已排序區都還是空的,而一段空的範圍不需要滿足任何條件就成立,因此兩個演算法的保證在起點成立。
Maintenance:Bubble Sort 每一輪會把未排序區裡的最大值送到那一段的尾端,Selection Sort 則會把未排序區裡的最小值送到那一段的前端,兩者都讓已排序區往外多一格。而剛被放進去的那個元素,在 Bubble Sort 是剩下元素裡最大的、在 Selection Sort 是最小的,所以那一格就是它的最終位置,之後不再需要移動。也就是說,只要這一輪開始前保證成立,跑完之後也還是成立,也就銜接上了下一輪的要求。
Termination:迴圈停下來時,已排序區涵蓋了整個陣列、未排序區變成空的,這時把那句保證翻譯過來,正是「每一個元素都在最終位置上」,也就是我們要的結果。
兩段排序程式都看完以後,接下來看看它們各自要花多少成本~
排序過程在做的事情可分兩種,一種是比較兩個元素的大小,另一種是把元素搬到別的位置上,而這兩種工作的成本不同,可以分開來分析看看,也能藉此看出兩段程式的差異。
Bubble Sort 的第 1 輪比了 7 次,第 2 輪因為範圍縮了一格,只比 6 次,接著是 5 次、4 次,一路遞減到最後一輪的 1 次。
那 Selection Sort 呢?第 1 輪從 index 1 掃到 index 7,也是 7 次,第 2 輪從 index 2 開始掃,6 次,也是一路遞減到 1 次。
兩邊都是 7 + 6 + 5 + 4 + 3 + 2 + 1,加起來剛好 28 次。寫成一般式就是:
(N-1) + (N-2) + … + 1 = N(N-1)/2
成長最快的是 N²/2,因為 Big O 會忽略固定倍數、只保留主導項,因此兩者都落在 O(N²)。另外,這個次數和資料本身的分布情況無關,不管給的是隨機順序、完全反序,還是本來就排好的陣列,兩支程式都會確實的比較 28 次。
可能有人會想說,兩層迴圈不是就等於 O(N²) 嗎?結論上來看沒錯,但這個推論中間跳過了一步,真要照這個說法算,8 個元素的兩層迴圈應該是 8 × 8 也就是 64 次,可是實際數出來只有 28 次,原因是內層迴圈的範圍每一輪都在縮短,第 1 輪 7 次、第 2 輪 6 次,一輪比一輪少。
那為什麼結論還是對的呢?因為 N²/2 和 N² 只差一個固定倍數,而前面說過 Big O 會忽略它。
前面 Bubble Sort 那張逐步驟的表格上可看出,明明第 5 輪就已經排好了,第 6、7 輪卻還在跑,而當一輪跑完後,一次交換都沒發生,就代表每一對相鄰元素的順序都是對的,那就等於整個陣列已排序完成。
把這個觀察寫成一個 flag,迴圈就能提早結束:
function bubbleSort(array) {
  const arr = [...array];

  for (let end = arr.length - 1; end > 0; end--) {
    let swapped = false;

    for (let i = 0; i < end; i++) {
      if (arr[i] > arr[i + 1]) {
        [arr[i], arr[i + 1]] = [arr[i + 1], arr[i]];
        swapped = true;
      }
    }

    if (!swapped) break;
  }

  return arr;
}
拿剛剛那段陣列 [6, 5, 3, 1, 8, 7, 2, 4] 來跑,比較次數從 28 降到 27,只省下 1 次,看起來效果不大,而這裡正好看得到提前停下來的代價,陣列在第 5 輪就排好了,程式卻不知道,還得用第 6 輪的比較把範圍走過一遍,確認沒有任何交換之後才停。換句話說,這個 flag 是拿一趟白走的確認,換掉後面那些同樣白走的輪次。
這個 flag 的實際好處可能要換一種輸入才看得出來,如果傳進去的是本來就排好的 [1, 2, 3, 4, 5, 6, 7, 8],第 1 輪走完 7 次比較、沒有發生任何交換,迴圈就結束了。Day 02 提過,這系列預設以 Worst Case 分析,而 [1, 2, 3, 4, 5, 6, 7, 8] 剛好是 Best Case,加上這個 flag 之後,Bubble Sort 的 Best Case 從 O(N²) 變成 O(N)。
Selection Sort 就沒有這種提早 return 的可能。它每一輪要找的是最小值,而在掃完剩下的每一格之前,沒有任何辦法能確定最小的就是目前記住的那一個,就算陣列本來就排好也一樣得掃到最後,因此不管輸入長什麼樣,28 次的比較都無可避免。
再來看看交換的次數,同一個輸入案例,Bubble Sort 交換了 16 次,Selection Sort 只交換 6 次。
為何會有這差距呢?因為 Bubble Sort 是靠交換來推進的,一個元素要往右移幾格,就得交換幾次,所以它的交換次數和「每個元素離最終位置有多遠」直接相關;Selection Sort 則是在掃描時只更新一個索引,整輪只在最後動手一次,交換次數的上限因此被鎖在 N - 1。
更進一步來計算 Bubble Sort 的交換次數,先定義什麼是「順序相反的配對」,從陣列裡任意挑兩個元素出來,只要排在前面的那個比後面的大,這一對就算一組「順序相反的配對」。這裡要注意的是,挑出來的兩個元素不必相鄰,只要前後關係是反的就算數,一個長度 8 的陣列最多會有 7 + 6 + 5 + 4 + 3 + 2 + 1 也就是 28 組。
拿前面那個輸入 [6, 5, 3, 1, 8, 7, 2, 4] 實際數一遍。先看第一個元素 6,它右邊比它小的有 5、3、1、2、4 共 5 個,6 這邊就有 5 組;換成第二個元素 5,右邊比它小的是 3、1、2、4,有 4 組;再換成 3,右邊只有 1 和 2 比它小,有 2 組。把 8 個元素都這樣數過一遍加起來,總共是 16 組。
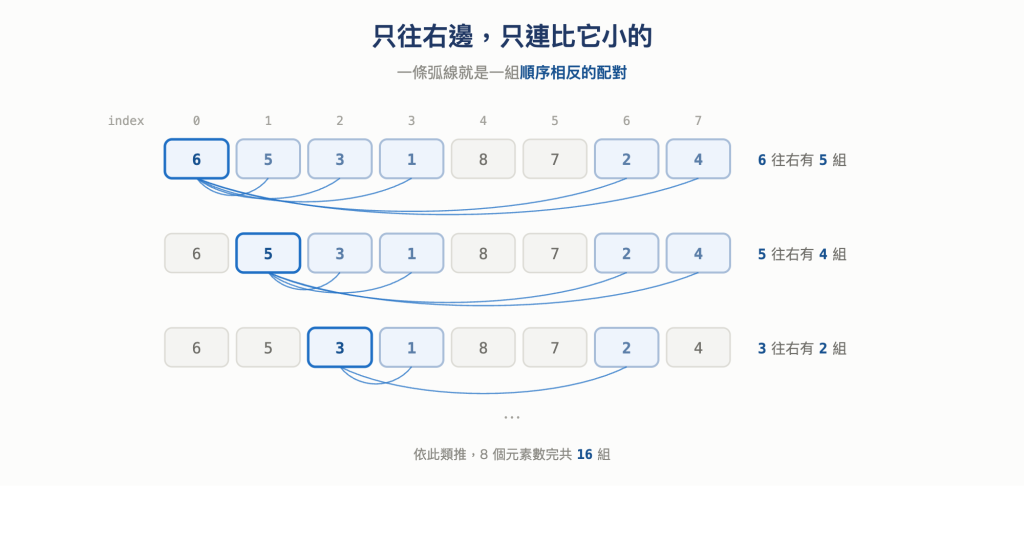
圖 4 數出這個陣列裡順序相反的配對
這個 16 和前面數出來的交換次數一模一樣,而這不是巧合。Bubble Sort 每一次交換都只對調相鄰的兩格,換完之後這對的順序就正確了、少掉一組順序相反的配對,而陣列裡其他任何一對的相對前後都沒被影響,所以一次交換只會消掉一組。既然一次只消一組,要換幾次自然就等於一開始有幾組。完全反序的 [8, 7, 6, 5, 4, 3, 2, 1] 任意兩個元素的順序都是反的,28 組順序相反的配對全部占滿,交換次數也正好是 28。
因此 Bubble Sort 的交換成本並不是由資料量單獨決定的,而是由資料亂到什麼程度,或說是「順序相反的配對」的數量決定的。
用三種不同的輸入跑同一組統計,差異會更明顯。Bubble Sort 這一欄用的是加了 flag 的版本,比較次數會隨輸入變動;沒有 flag 的話三列都會是 28 次:
| 輸入 | Bubble 比較 | Bubble 交換 | Selection 比較 | Selection 交換 |
|---|---|---|---|---|
[6, 5, 3, 1, 8, 7, 2, 4] |
27 | 16 | 28 | 6 |
已排序 [1 .. 8] |
7 | 0 | 28 | 0 |
完全反序 [8 .. 1] |
28 | 28 | 28 | 4 |
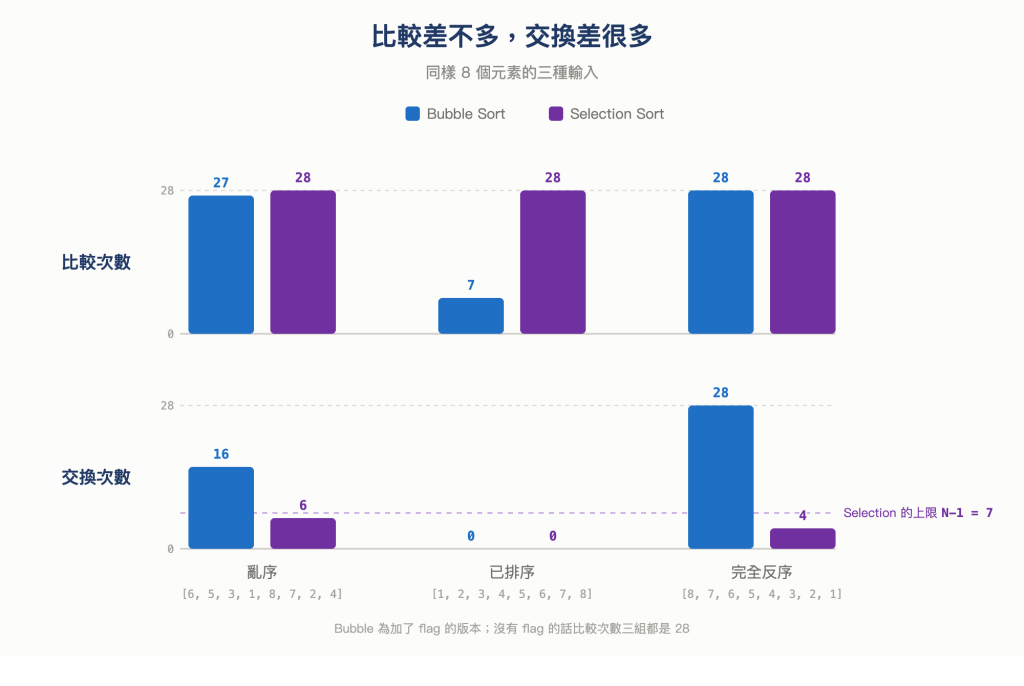
圖 5 相同輸入情況下,兩種排序演算的比較次數幾乎相同,交換次數的差異卻很大
從完全反序那一列就能看出差異,兩邊的比較次數一樣都是 28 次,但 Bubble Sort 交換了 28 次、Selection Sort 只交換 4 次,相差 7 倍。
不過成本較低的不一定總是 Selection Sort,已排序那一列就相反了,Bubble Sort 有 early exit 的情況下,7 次比較就能結束,Selection Sort 卻還是得跑滿 28 次。要問哪一個比較好,就得先知道資料長什麼樣。
而且比較和交換的成本並不相等,比較只是把兩個值讀出來看一眼,交換卻要把兩格的內容對調,得先暫存一格、再依序寫回這兩個位置,一次交換等於 3 次搬移。
那這些差距真的重要嗎?如果陣列裡放的只是幾個整數,多換幾次大概感覺不出來,但如果每一筆是一個很大的物件,或者資料放在寫入成本較高的儲存媒介上,交換次數的差距就會反映在實際的執行成本上。
接下來看空間複雜度,Day 03 提過,計算空間複雜度時要看的是 Auxiliary Space,而這兩段程式在這一項上都是 O(1)。
Bubble Sort 只需要交換時的那一格暫存,Selection Sort 只需要 minIndex 這個變數,兩者都不會隨著陣列變長而增長空間,它們都屬於原地排序 (in-place sort),排序過程直接在原本的陣列上進行,不必另外開一個等長的空間存放結果。
另外,前面那兩段程式都用 [...array] 先複製了一份資料,是為了不動到呼叫端傳進來的陣列,屬於使用上的選擇/偏好,和演算法本身需要多少額外空間是不同的事。拿掉那行、直接對 array 操作,它們就會是原地排序了。
總結來說,Bubble Sort 和 Selection Sort 的時間複雜度都是 O(N²)、額外空間都是 O(1)、也都是原地排序,這三項完全相同,要比較細部差別,就得回到前面那些比較和交換的次數。
最後補充,這兩個演算法通常不會是實務工作上的首選,O(N²) 的成長速度代表資料量翻倍、工作量大約會變成四倍,資料一多就很難處理,多數語言的內建排序也不會採用它們。
但這不代表它們完全沒用,Bubble Sort 加上 early exit 之後,面對資料量很小、且幾乎已排好的陣列,可以在一輪掃描之內就結束;Selection Sort 交換次數有上限的特性,在資料搬移特別昂貴的情境下也可能有其價值。它們真正的問題是適合使用的情境太少,而不是一無是處,只是那個範圍窄到我們平常很難碰上,所以實務上多半用不到。
比起實務應用,這兩個排序真正的價值在別的地方,和後續要介紹的排序演算法相比,它們的程式相對短,每一步在做什麼都看得見,很適合拿來學「怎麼分析一個演算法」。所以今天學到的其實不只是兩段排序,還有一套在兩個演算法同屬一個 Big O 類別時繼續往下比的方法:數比較次數、數交換次數,然後換幾種輸入再跑一次。這套做法接下來遇到更複雜的排序時都還用得上。
小小總結一下今天對 Bubble Sort 與 Selection Sort 的認識~
實際使用時,還可以記住幾件事~
N(N-1)/2,差異幾乎都在交換次數上。O(N) 的 Best Case,Selection Sort 沒有,因為找最小值一定得掃完剩下的每一格才算數。最後補充,因為之後幾篇都會介紹排序演算法,很推薦大家參考 Sorting Algorithms Animations,可以看到不同輸入分布在不同排序演算法下的執行速度。
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術