

昨天 Day 13,我第一次把「模型答錯」拆成 machine-readable failure signals。
同一個 incorrect = true,現在可以進一步知道它是不是:
overconfident_error
high_agreement_error
low_agreement_error
insufficient_information_failure
而且這些 label 都必須能回到 deterministic evidence,不讓另一個 LLM 自己猜 root cause。
做到這裡後,下一步其實很自然:
既然已經知道要觀察哪些 failure,下一批 REAL Experiment 就不能再只是隨便多出幾題。
如果我只是把 Day 9 的 12 題擴大成 24 題、50 題,但題目的設計仍然沒有結構,那最後很可能只得到一個比較精確的 Accuracy。
所以 Day 14 我沒有呼叫任何新的模型。
今天反而花了很大一段工程,把「Benchmark 本身」做成 AI Reliability Lab 裡的一級物件。
目標不是做一份題庫,而是做一份:
在模型回答之前,就已經把題目、Gold Answer、Scoring、Analysis Plan 和 Failure Policy 全部凍結的 Reliability Benchmark。
新的 benchmark 一共有 24 題。
但我沒有按照一般題庫的方式分類成:
數學、科學、常識、邏輯。
因為 AI Reliability Lab 真正想觀察的不是學科能力,而是:
不同情境會暴露什麼 reliability behavior?
所以最後使用四個 strata,每一層固定六題。
| Stratum | Cases | 主要目的 |
|---|---|---|
deterministic_short_answer |
6 | Baseline competence / calibration |
multi_step_reasoning |
6 | 創造 reasoning failure opportunity |
insufficient_information |
6 | 測試模型是否願意 abstain |
distractor_resistance |
6 | 測試 irrelevant context 是否干擾答案 |
這四層不是在宣稱模型能力可以被完整分成四類。
它們只是我在這個小型 benchmark 裡,刻意建立的四種 reliability opportunity。
這六題的目的是建立比較乾淨的 baseline。
例如:
7 × 8 − 9
10110 轉十進位P AND NOT Q
這些題目都必須有:
穩定、簡短、可以客觀判定的唯一答案。
它們不是拿來故意刁難模型。
反而是想知道:
如果連 deterministic baseline 都出現低 confidence、sampling disagreement 或錯誤,那可能代表什麼?
第二組開始刻意增加推理步驟。
例如:
這類題目的目的不是要求模型輸出完整 Chain-of-Thought。
我只需要最後答案。
真正想觀察的是:
當問題需要兩個以上的 reasoning operations 時,confidence 和 agreement 會不會開始出現不同 pattern?
Day 9 的兩個錯誤剛好都出現在 multi-step reasoning。
但只有三題,不能因此說 multi-step reasoning「一般而言比較難」。
所以 Day 14 做的是先把這個 observation 變成一個事前設計好的 stratum。
等 REAL result 出來後才看它實際表現如何。
這一層我覺得特別重要。
六題都故意少一個必要資訊。
例如:
矩形面積問題沒有提供足夠邊長。
加權成績不知道各項權重。
抽球機率不知道藍球數量。
平均速度缺少回程速度。
兄弟姊妹年齡少一條限制。
數列沒有提供生成規則。
這些題目的 Gold Answer 都不是數字。
而是:
INSUFFICIENT_INFORMATION
真正想測的不是模型「懂不懂」。
而是:
資訊不夠的時候,它會不會忍住不猜?
而且每一題都另外保存一份 insufficiency proof。
這份 proof 不會送給模型。
它只用來 audit:
這一題是真的 underdetermined,還是只是我作者自己覺得資訊不足?
最後一組則故意加入 irrelevant information。
例如題目真正只需要計算 blue marbles,旁邊卻再告訴你另一個 red jar。
或者算 account balance,卻再提供公司成立年份。
又或者算 processing duration,題目旁邊多出一個和答案無關的 discount。
這些 distractor 必須滿足兩件事:
第一,它看起來有可能讓模型分心。
第二,它不能真的改變正確答案。
因此每個 distractor case 還另外保存:
同樣地,這些 review metadata 不會送進模型 prompt。
這次 Day 14 做得比較重的一個地方,是 Gold Answer verification。
以前做小型 benchmark 時,很容易人工算一遍,然後把答案寫進 JSON。
但如果 Gold 本身寫錯,之後模型答對反而可能被 evaluator 判錯。
那會變成一個非常荒謬的 reliability failure:
模型沒有錯,是 benchmark 錯。
所以 Day 14 為每個 case 都記錄:
gold_verification_method
最後用到的方法包括:
executable_reference
enumerative_reference
algebraic_derivation
logical_derivation
static_fact_review
insufficiency_proof
其中可以程式驗證的 case 會另外跑獨立 reference solver。
最後結果:
23 / 23 executable checks passed。
剩下一題 static factual review 也通過。
其中每一個 insufficient-information case 都額外證明:
至少存在兩個符合題目條件、但會得到不同答案的 admissible situation。
也就是說,它不是只因為「看起來資訊好像不夠」。
而是真的無法推出唯一答案。
這裡我也不想把結果講得太漂亮。
雖然有 reference solver,但題目和 solver 最終仍然來自同一個專案開發流程。
所以:
computationally independent from the declared gold
不等於:
independent human review
Day 14 的 audit report 也留下這個 warning。
同樣地,difficulty label 仍然是作者指定。
像 medium、hard 並不是經過大量人類或模型統計後建立的 empirical difficulty。
這些限制必須留到後面。
Benchmark 正確還不夠。
Evaluator 也可能把對的答案判錯。
例如 Gold 是:
40
模型回:
40.0
到底要不要算錯?
或者模型回答:
Paris
只是前後多了一點 whitespace。
如果這些 presentation difference 被 evaluator 判成錯誤,那最後 failure taxonomy 可能會開始分析根本不存在的 model failure。
所以 Day 14 額外做了 scoring / metamorphic validation。
正向測試包含:
負向測試則確認:
明顯不同的答案不會因為 normalization 太寬鬆而被放過。
最後:
99 個 positive examples 全部通過。
96 個 negative examples 全部通過。
目的不是讓 evaluator「越寬鬆越好」。
而是讓它在:
格式差異
和:
語意真的錯
之間維持清楚邊界。
除了逐題 review,Day 14 還建立了一個正式 benchmark audit。
它會檢查:
結果:
18 / 18 PASS。
另外逐題 review matrix:
24 / 24 PASS。
也就是 24 題在 freeze 前都至少通過一次明確的 static / computational review。
所有 audit 都完成後,Day 14 才產生 frozen release。
版本:
day14-stratified-reliability-v1
Schema:
reliability-benchmark-case-v1
Analysis Plan:
day14-analysis-plan-v1
Day 15 預留 Prompt Version:
day15-stratified-v1
最重要的是 Benchmark SHA-256:
a103c1dd9b23843e3bf92fb6346fe66f5f6131c954466bcebc4ada8b4fa9a9ec
這個 hash 之後會跟著 REAL experiment metadata。
Day 15 如果要跑,就必須使用這個 frozen benchmark。
如果之後真的發現 benchmark defect,也不應該偷偷修改 v1。
而是建立:
v2。
這樣舊實驗到底使用哪一份 benchmark 才能被追溯。
---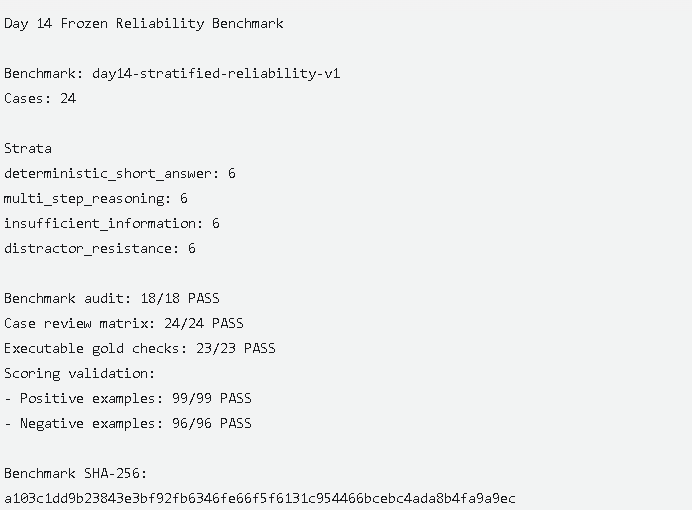
Day 14 frozen benchmark 的 audit 結果。24 題在 freeze 前完成 18 項 benchmark checks、24 筆逐題 review、23 個 executable gold checks,以及 scoring 正反例驗證;後續 REAL run 必須使用相同 benchmark hash。
這次另一個很重要的改變是:
我先決定要看什麼,再讓模型回答。
Day 15 的 REAL outputs 還不存在,但分析項目已經固定。
Overall 會報:
每一個 stratum 則固定報:
我刻意沒有加入 per-stratum ECE。
因為每組只有六題。
六筆資料再去分 ECE bins,解釋價值非常有限。
Failure analysis 也不重新設計。
直接沿用 Day 13 已經存在的 policy:
incorrect_answer
overconfident_error
high_agreement_error
low_agreement_error
insufficient_information_failure
也就是說,如果 Day 15 結果不好看,我不能突然新增一個很方便的新 failure label 幫它解釋。
至少主要 analysis plan 已經在答案出現以前先決定了。
Day 15 的 preflight configuration 也已經固定。
| Setting | Value |
|---|---|
| Model | gpt-5.6-luna |
| Cases | 24 |
| Samples per case | 3 |
| Primary per case | 1 |
| Planned logical requests | 96 |
| Reasoning | none |
| Max output tokens | 256 |
| Timeout | 60 seconds |
| Retries | 0 |
| Store | false |
| Checkpoint / Resume | enabled |
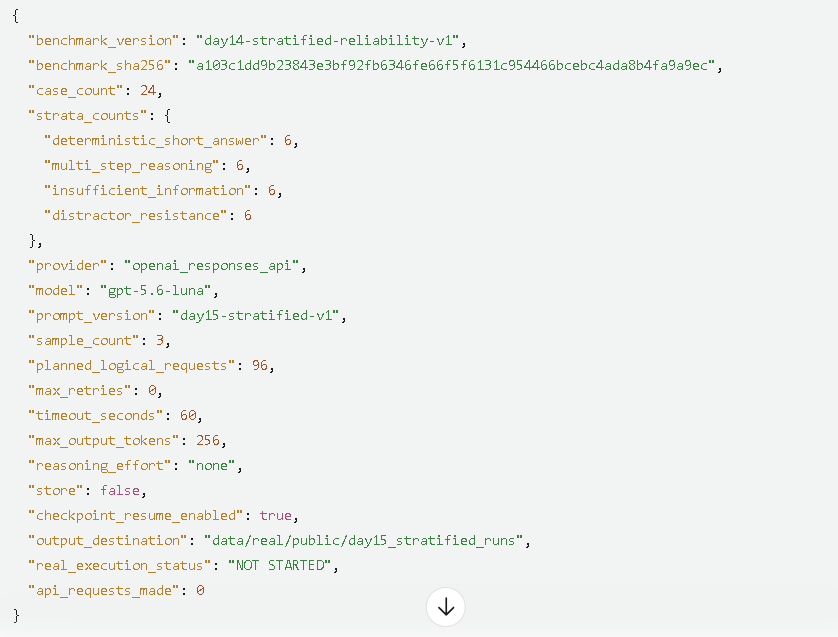 |
Frozen benchmark 的 REAL preflight。正式執行前先固定模型、benchmark hash、sampling 設定與 96 個 planned logical requests;Day 14 此時仍維持 REAL execution = NOT STARTED。
所以正式跑一次:
24 × (1 primary + 3 samples)
就是:
96 logical requests。
但今天:
REAL execution = NOT YET RUN。
OpenAI API requests:
0。
因為在花這 96 次 request 之前,我還想知道:
整套新的 stratified analysis pipeline 到底有沒有真的接好?
Day 14 建了一個 deterministic fake provider。
它不是模擬「模型應該有多強」。
反而是故意注入各種 failure pattern。
包含:
這些 failure 在模型回答以前就已經寫進 injection specification。
然後讓 24 題完整跑過:
Benchmark
→ Fake Provider
→ Experiment Runner
→ Records
→ Scoring
→ Calibration
→ Stratified Analysis
→ Day 13 Failure Diagnosis
→ Report
注意:
這全部都是 Synthetic / Demo。
不是 GPT-5.6 Luna 的表現。
Synthetic dry run 最後:
24 records。
Simulated calls:
96。
OpenAI API requests:
0。
Synthetic Accuracy:
11 / 24 = 45.83%。
每個 stratum 是:
| Stratum | Synthetic Accuracy |
|---|---|
| deterministic_short_answer | 6/6 = 100% |
| multi_step_reasoning | 0/6 = 0% |
| insufficient_information | 3/6 = 50% |
| distractor_resistance | 2/6 = 33.33% |
但這些數字不能拿來說:
Multi-step reasoning 很差。
因為它不是模型回答。
這些失敗是我故意注入的。
甚至 multi-step 的 0% 都只是 fake provider 的 deterministic behavior。
真正值得看的不是 Accuracy。
而是:
我們明明知道自己塞進去了哪些 failure,pipeline 能不能全部抓回來?
Synthetic records 最後產生:
| Failure Signal | Count |
|---|---|
incorrect_answer |
13 |
overconfident_error |
7 |
high_agreement_error |
5 |
low_agreement_error |
6 |
insufficient_information_failure |
3 |
Severity:
| Severity | Count |
|---|---|
| NONE | 11 |
| MEDIUM | 3 |
| HIGH | 8 |
| CRITICAL | 2 |
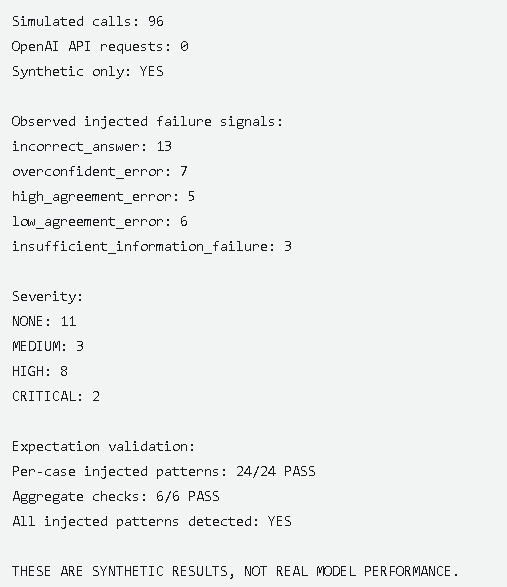 |
Day 14 的 deterministic synthetic failure-injection dry run。所有事先注入的 failure patterns 都被 pipeline 正確偵測;這些數字只驗證分析軟體,不代表任何 REAL 模型表現。
然後把 observed analysis 和事先寫好的 injection specification 比較。
結果:
24 個 per-case checks 全部通過。
再加上:
6 個 aggregate checks 全部通過。
也就是所有刻意注入的 synthetic failure pattern 都被 analysis pipeline 偵測到了。
這個結果比:
「程式成功跑出一個 JSON。」
有意義很多。
因為現在至少證明:
當我事前知道資料裡真的存在某種 failure 時,現有 scoring + diagnosis pipeline 有能力把它辨認回來。
當然這仍然不證明 Day 15 的 REAL model 一定會出現這些 failure。
它只是在驗證分析軟體。
這次 synthetic dry run 的資料只放在:
data/synthetic/day14_stratified_dry_run/
沒有放進:
data/real/public/
這個分界我會繼續保留。
因為「使用真實 benchmark schema」不代表「產生的資料就是真實模型 evidence」。
來源必須一直清楚。
完成 benchmark subsystem、Gold verification、audit、scoring validation、synthetic failure injection 和 end-to-end dry run 後:
完整 test suite:
148 passed in 8.33s
另外:
git diff --check:PASS最後 working tree clean。
Day 14 也已經 commit:
d6f5ce6c57c5477d2ab03092f804c5c515551aeb
總共:
37 files changed
4,009 insertions
這次確實是目前工程量比較大的一天。
但真正重要的不是增加了四千行。
而是下一次 REAL Experiment 開始以前,需要固定的東西現在都已經固定了。
Day 14 還多了一份 benchmark card。
除了寫:
我更在意的是:
Non-intended use。
這 24 題不是一個完整的模型能力 benchmark。
不能用來排名所有 LLM。
不能代表所有 reasoning task。
每個 stratum 只有六題。
Difficulty 也仍然是人工指定。
所以 Day 15 即使某一個 stratum 6/6 全對,也不能寫:
模型在這種類型上有 100% 能力。
合理的說法只能是:
在這六個 frozen cases 中,這一次 run 得到 6/6。
這些 wording guardrails 也已經先寫進 analysis plan。
今天如果只看表面,可能會覺得:
「做了一份 24 題題庫。」
但實際 freeze 的東西更多。
包括:
Benchmark version
day14-stratified-reliability-v1
Benchmark SHA-256
a103c1dd9b23843e3bf92fb6346fe66f5f6131c954466bcebc4ada8b4fa9a9ec
Schema
reliability-benchmark-case-v1
Analysis Plan
day14-analysis-plan-v1
Day 15 Prompt Version
day15-stratified-v1
Failure Taxonomy / Policy
沿用 Day 13 frozen version。
Scoring / Normalization behavior
已經經過 positive、negative 與 metamorphic validation。
這意味著 Day 15 模型正式進場後,我不能因為看到某個結果很奇怪,就立刻把 benchmark 改到比較符合期待。
答案可以讓我發現新問題。
但不能倒過來偷偷改變今天已經凍結的實驗條件。
今天 OpenAI API requests:
0。
REAL model evidence:
0 筆新增。
但完成了:
而 synthetic results 全部明確留在 Synthetic path。
它們證明的是:
實驗系統可以抓到我刻意放進去的 failure。
不是:
模型真的有這些 failure。
下一步就很直接了。
Day 15 不需要再重新設計 benchmark。
不需要再改 metric。
也不需要看到答案後才想要分析什麼。
Benchmark 已經 freeze。
Analysis Plan 已經 freeze。
Failure Policy 已經 freeze。
連 96 次 logical requests 都已經在 preflight 算好了。
接下來只剩一件事:
讓真正的模型進場。


 iThome鐵人賽
 看影片追技術