
前幾天一直在研究 confidence、agreement、sampling budget,但做到 Day 17 後,其實又回到一個很基本的問題:現在手上的 REAL benchmark 還是只有 24 題。
Day 15 雖然跑出了 23/24 的結果,Day 16 也從裡面找到 self-confidence 全部卡在 1.0 的問題,Day 17 再往下分析 3、5、7、9 samples 的差別,但這些分析最後都會被同一件事限制住:case 太少,而且 Day 15 總共只有一個錯誤。
如果下一步只是把同樣 24 題從 3 samples 改成 7 samples,我會得到更細的 agreement,但本質上還是在反覆研究同一份小考卷。所以 Day 18 我先不跑新的 API,而是把 benchmark 本身擴大,從原本的 24 cases 增加到 48 cases。
今天的重點不是模型表現,而是把下一輪 REAL experiment 的考卷和分析方式先準備好。
 這次新的 benchmark 版本叫:
day18-stratified-reliability-v2
它不是直接把 Day 14 的 benchmark 改掉,而是保留原本完整的 24 題,再另外新增 24 題。
最後四個 strata 都變成 12 題:
| Stratum | Legacy | New | Total |
|---|---|---|---|
| deterministic_short_answer | 6 | 6 | 12 |
| multi_step_reasoning | 6 | 6 | 12 |
| insufficient_information | 6 | 6 | 12 |
| distractor_resistance | 6 | 6 | 12 |
| Total | 24 | 24 | 48 |
這裡我特別要求原本的 24 題不能因為看過 Day 15 的結果就偷偷修改。最後檢查時,前 24 rows 不只是題意一樣,而是原本每個 field 和 serialized bytes 都完整保留。
原因很簡單。
如果看過模型在哪裡出錯後,再回頭修改舊題,那後面即使還叫同一個 benchmark version,實際上也已經不是同一份實驗了。
所以 Day 18 的作法是:舊版保留,新題另外加,最後直接建立新的 v2。
新的 24 題一樣平均分到四個 strata,每組六題,但我刻意讓題型和原本有所變化。
Short answer 新增了:
Multi-step reasoning 新增:
Insufficient information 則新增不同種類的缺失:
Distractor resistance 也不只是一直塞多餘數字,而是換不同形式:
這樣做的目的不是讓 benchmark 看起來很多元,而是避免 48 題其實只是 24 種模板各複製兩遍。
尤其是 multi-step reasoning,我沒有直接照 D14-011 那題的 failure 去出六題「類似題」。因為那樣很容易變成看到一個 error 後,整份新 benchmark 都圍著那個 error 設計,最後測到的只是我們自己已經知道的弱點。
題目增加一倍後,Gold Answer 寫錯的風險也跟著增加。
如果 benchmark 自己的答案錯了,那模型明明答對卻會被 evaluator 判錯,後面的 calibration、failure diagnosis 全部都會一起被污染。
所以這次 48 題全部重新跑 Gold validation。
結果:
48 / 48 PASS
其中:
而且 benchmark validation 本身也有一整套檢查,最後是:
30 / 30 PASS
包含 case count、stratum balance、ID uniqueness、Gold、normalization、hidden metadata separation、deterministic ordering、serialization 和 hash 等檢查。
Scoring 的正反例也重新擴大。
Positive cases:
198 / 198 PASS
Negative cases:
192 / 192 PASS
我現在越來越覺得,benchmark 做大後最麻煩的反而不是「出題」,而是確保 evaluator 沒有因為格式或 normalization 把正常答案判錯。
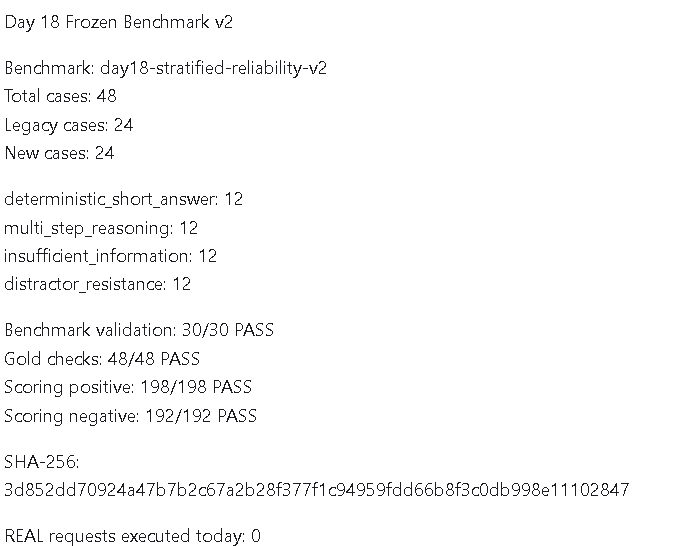 全部檢查完成後,新的 benchmark 才正式 freeze。
版本:
day18-stratified-reliability-v2
SHA-256:
3d852dd70924a47b7b2c67a2b28f377f1c94959fdd66b8f3c0db998e11102847
這個 hash 之後會直接跟著 Day 19 的 REAL experiment。
如果後面真的發現題目有 defect,也不能直接修改這一份 v2,應該再建立新的 benchmark version。
這次還另外檢查了之前的資料有沒有被影響。
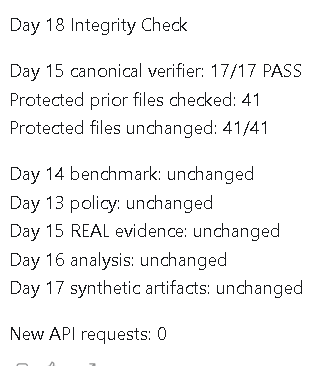
Day 15 canonical verifier:
17 / 17 PASS
總共有 41 個 protected files 維持 byte-identical,包括:
所以 Day 18 的工程沒有回頭動到前面的實驗歷史。
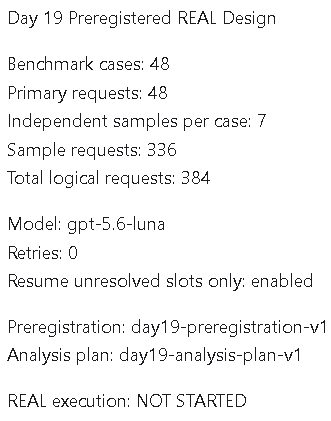
 這次我不只 freeze 題目,連下一輪 REAL experiment 的分析方式也一起先固定。
Day 19 preregistration:
day19-preregistration-v1
Analysis plan:
day19-analysis-plan-v1
模型先維持:
gpt-5.6-luna
這裡我沒有因為新模型出了就直接換模型,因為如果 Day 19 同時改 benchmark、sample_count 和 model,到時候看到差異會更難解釋。
Sampling 則採用 Day 17 的實驗設計建議:
每題 7 個 independent samples
再加一個 primary。
所以 48 題的 request budget 變成:
| Component | Requests |
|---|---|
| Primary responses | 48 |
| Samples:7 per case | 336 |
| Total logical requests | 384 |
也就是 Day 19 如果正式跑下去,會是:
384 個 logical requests
比 Day 15 的 96 次整整多四倍。
這也是為什麼今天不順便直接跑。384 次已經不是「先試一下看看」的規模,最好在真的花掉之前把實驗條件全部固定。
Day 16 曾經用一個很簡單的 rule:
samples 不 unanimous → review
在 Day 15 那 24 題裡,它剛好 review 2 題,而且抓到唯一錯誤。
但 Day 17 已經算過,sample 數增加後,要「全部一致」會變得越來越難。所以如果 Day 19 改成 7 samples,不能直接把 non-unanimous rate 和 Day 15 拿來比較。
不然很容易看到 Day 19 disagreement 變多,就以為模型變不穩。
其實可能只是因為:
3 次全部相同
本來就比
7 次全部相同
容易很多。
所以這次 analysis plan 把這個限制直接寫進去,raw non-unanimity rate 不能單獨拿來當 improvement 或 regression。
另外 preregister 一個固定的 descriptive flag:
agreement < 0.8
這個 threshold 是在看到 Day 19 結果前先定下來的,不會等跑完後才找一個剛好最好看的數字。
它也不會被稱為 production policy,只是拿來觀察 7-sample 設計下的 case-level variation。
Overall 還是保留之前的主要 metrics:
每個 stratum 會看:
另外因為這次有 7 samples,sampling uncertainty 會多看:
Failure analysis 則繼續沿用 Day 13 的 policy,不會看到新結果後再新增一堆 label。
Selective threshold accounting 也沿用 Day 16 的方法,但會明確考慮 Day 17 已經發現的 sample-count effect。
這樣 Day 19 真正跑完後,就不用再臨時決定「這次看什麼數字比較有故事」。
從 24 題變 48 題確實比較好了,但我還是不會把它當成大型 benchmark。
每個 stratum 只有 12 題,而且這些題目和 reference constraints 最後還是來自同一個開發流程。
也就是說,雖然現在 Gold validation 比以前完整很多,但仍然不能把它包裝成真正的 independent human-reviewed benchmark。
另外 legacy 24 題的 outcome 已經看過了,所以 Day 19 的 48 題裡,有一半不是完全新的 blind cases。
這些限制都會保留在後面的分析裡。
今天沒有新的模型回答。
OpenAI API requests:
0
Provider calls:
0
Network calls:
0
但完成了:
完整 test suite 最後是:
384 passed in 28.97s
這次做完後,我比較有感的是:前幾天一直在改「怎麼量」,Day 18 開始真的把「拿什麼來量」也補起來。
下一步已經很清楚。
考卷現在是 48 題。
Sample budget 是 7。
分析規則也先寫好了。
接下來就只差讓真正的模型跑這 384 個 requests。


 iThome鐵人賽
 看影片追技術