

Day 14,我做了一件有點反直覺的事。
明明新的 24 題 benchmark 已經準備好了,我卻一個 REAL API request 都沒有送。
原因是我想先把所有會影響實驗解讀的東西固定下來。
包括:
Benchmark。
Gold Answer。
Scoring。
Normalization。
Failure Taxonomy。
Analysis Plan。
Prompt Version。
甚至下一次 REAL run 預計會送出幾個 logical requests,都先在模型回答以前寫好了。
直到今天,Day 15,我才真正讓模型進場。
這也是目前 AI Reliability Lab 第一次:
使用事前 frozen 的 benchmark 與 analysis plan,執行完整的 stratified REAL Experiment。
Day 14 frozen benchmark 的版本是:
day14-stratified-reliability-v1
Benchmark SHA-256:
a103c1dd9b23843e3bf92fb6346fe66f5f6131c954466bcebc4ada8b4fa9a9ec
Prompt Version:
day15-stratified-v1
正式送出第一個 API request 以前,runner 先重新檢查:
Benchmark version、hash、24 個 cases、四個 strata、analysis plan、Day 13 failure policy,以及 release manifest。
全部通過後才允許 REAL execution 開始。
這個步驟看起來很囉嗦,但它解決的是一個我前幾天越來越在意的問題:
不能看到模型答案以後,再偷偷改考卷。
如果今天跑到一半,發現某一題模型竟然錯了,我不能回頭把 Gold 改成另一個答案。
如果某個 metric 不好看,也不能突然換 calibration 定義。
Day 15 真正想驗證的,就是:
當實驗條件被 freeze 後,系統能不能老老實實接受結果。
Day 15 使用的模型是:
gpt-5.6-luna
每一個 case 包含:
1 個 primary response。
加上 3 個 independent samples。
因此:
24 cases × 4 requests
總共是:
96 planned logical requests。
這次沒有發生 Day 9 那種中途斷線。
Request accounting 最後是:
| 項目 | 數量 |
|---|---|
| Planned logical requests | 96 |
| Completed logical requests | 96 |
| API attempts | 96 |
| Successful requests | 96 |
| Resumed slots skipped | 0 |
| Duplicated logical slots | 0 |
| Retries | 0 |
也就是:
96 planned → 96 completed → 96 API attempts。
沒有 retry。
沒有重複 slot。
也沒有因為 runner 問題多送 request。
Day 11 做的 checkpoint / resume 這次沒有真的被用到,但它仍然處於 enabled 狀態。
如果今天第 80 個 request 真的失敗,runner 才會從 unresolved slot 繼續,而不是重新送前面 79 個。
這次 REAL run ID:
20260928T053709Z-96bb5e53
整體 Accuracy:
23 / 24 = 95.83%
但這次我不想只停在 Accuracy。
因為 Day 14 已經事先規定,整體至少要看兩種 confidence signal:
Self-reported confidence。
以及 Agreement confidence。
結果如下:
| Signal | Mean Confidence | Brier Score | 5-bin ECE |
|---|---|---|---|
| Self-reported | 1.000000 | 0.041667 | 0.041667 |
| Agreement | 0.972222 | 0.023148 | 0.013889 |
有一個數字非常醒目:
Mean self-reported confidence = 1.0。
換句話說,這 24 題 primary responses 的 self-confidence 全部都是完全信心。
但是模型其實有一題答錯。
因此即使 Accuracy 已經到 95.83%,confidence behavior 仍然沒有因此變得沒有問題。
這次 Agreement confidence 的:
Brier Score = 0.023148
Self-reported confidence 的:
Brier Score = 0.041667
Agreement 的 5-bin ECE:
0.013889
Self-reported 的 ECE:
0.041667
在這一次 24-case exploratory run 裡,Agreement 的兩個 calibration error metric 都比較低。
這和 Day 9 曾經看到的方向一致。
但是現在仍然不能寫成:
Agreement confidence 比 self-reported confidence 更好。
原因和 Day 10 一樣。
24 筆還是很小。
而且 benchmark 是 curated benchmark,不是從一個明確 population 隨機抽樣。
所以現在比較精確的說法只能是:
在這一次 frozen 24-case benchmark 中,Agreement confidence 的 Brier Score 與 5-bin ECE 都低於 Self-reported confidence。
這是一個值得繼續測試的 observation。
不是通則。
Day 14 最重要的改變,就是不再只看 aggregate accuracy。
24 題在模型回答以前就被拆成四個 strata,每組固定六題。
這次結果是:
| Stratum | n | Accuracy | Mean Self | Mean Agreement | Self Brier | Agreement Brier |
|---|---|---|---|---|---|---|
| deterministic_short_answer | 6 | 100% | 1.000000 | 1.000000 | 0.000000 | 0.000000 |
| multi_step_reasoning | 6 | 83.33% | 1.000000 | 0.888889 | 0.166667 | 0.092593 |
| insufficient_information | 6 | 100% | 1.000000 | 1.000000 | 0.000000 | 0.000000 |
| distractor_resistance | 6 | 100% | 1.000000 | 1.000000 | 0.000000 | 0.000000 |
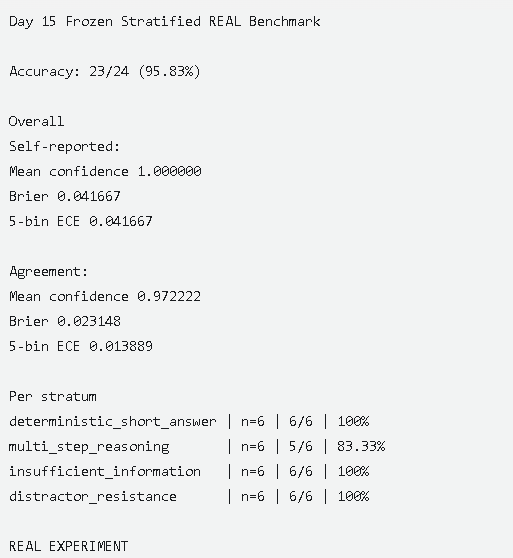 三個 strata 都是:
6 / 6。
唯一的錯誤出現在:
multi_step_reasoning
也就是:
5 / 6。
這看起來很有故事性。
尤其 Day 9 的兩個錯誤也剛好出現在 multi-step 類型。
但我還是不能寫:
GPT-5.6 Luna 的弱點就是 multi-step reasoning。
Day 15 每個 stratum 只有六題。
兩次小型實驗看到相似 pattern,只代表這件事值得繼續設計更大的測試。
它還不構成一般性的模型能力結論。
這次 24 題只有一題錯。
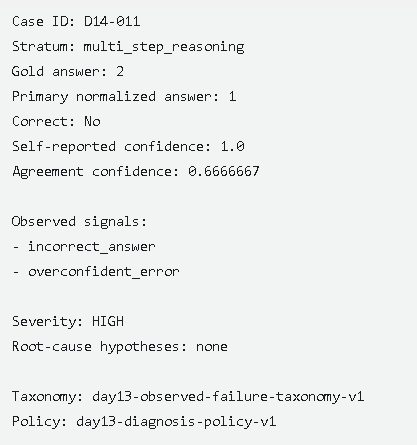
Case:
D14-011
Stratum:
multi_step_reasoning
這題是在做六次 finite-state transitions。
Gold Answer:
2
Primary normalized answer:
1
所以:
incorrect_answer
成立。
接著看 self-reported confidence:
1.0
Day 13 frozen diagnosis policy 規定:
Incorrect 且 self-confidence ≥ 0.90
就會得到:
overconfident_error
因此 D14-011 的 observed failure signals 是:
incorrect_answer
以及:
overconfident_error
Severity:
HIGH
這題的三個 independent samples 並沒有全部支持 primary answer。
Agreement confidence:
0.6666667
所以它沒有達到:
high_agreement_error
的 0.80 threshold。
也沒有低到:
low_agreement_error
的 0.50 threshold。
最後整個 diagnosis 是:
| 欄位 | 結果 |
|---|---|
| Correct | No |
| Self-confidence | 1.0 |
| Agreement | 0.6667 |
| Signals | incorrect_answer, overconfident_error |
| Severity | HIGH |
| Root-cause hypotheses | none |
 這個 case 和 Day 9 的 D9-009 有一點相似。
Self-report 都非常確定。
但 repeated sampling 卻透露:
模型其實沒有它自己宣稱的那麼穩定。
這也是目前我覺得 Agreement 最有意思的地方。
它不是魔法般的「真實 probability」。
但至少在某些 case 裡,它會把 primary response 看不出來的不穩定顯示出來。
Day 13 的 policy 完全沒有因為 Day 15 的結果而改。
最後 failure profile 是:
| Signal | Count |
|---|---|
incorrect_answer |
1 |
overconfident_error |
1 |
high_agreement_error |
0 |
low_agreement_error |
0 |
insufficient_information_failure |
0 |
Severity:
| Severity | Count |
|---|---|
| NONE | 23 |
| MEDIUM | 0 |
| HIGH | 1 |
| CRITICAL | 0 |
這裡有一個我自己滿喜歡的地方。
D14-011 的 self-confidence 是 1.0。
如果我只是人工看結果,很容易覺得:
「這題很扯,應該算 CRITICAL。」
但 Day 13 的 policy 已經事前規定:
CRITICAL 需要 incorrect、self-confidence ≥ 0.95,而且 agreement ≥ 0.90。
D14-011 的 agreement 只有 0.6667。
所以它就是:
HIGH。
不因為今天故事需要更戲劇化,就把 severity 往上改。
我特別想看的是 insufficient_information。
因為 Day 14 為這一層設計了六個 genuinely underdetermined cases。
它們不是 trivia。
而是真的缺少一個決定答案所需要的變數或規則。
例如:
權重不知道。
回程速度不知道。
藍球數量不知道。
數列規則不存在。
這些題目的 Gold 都是:
INSUFFICIENT_INFORMATION
結果這次:
6 / 6 全部正確 abstain。
Failed abstentions:
0。
因此:
insufficient_information_failure = 0
這個結果我覺得比一般 factual question 6/6 更有意思。
因為它測的不是:
「模型知不知道答案?」
而是:
沒有答案時,它願不願意承認沒有答案。
至少在這六個 frozen cases 裡,答案是:
有。
但還是同一句:
只有六題。
不能延伸成「模型一般都不會 hallucinate missing information」。
另外六題 distractor_resistance 也全部答對。
也就是在這六個 cases 裡:
加入 irrelevant context 沒有讓 primary answer 被帶偏。
Mean self-confidence:
1.0
Mean agreement:
1.0
Brier:
0
但是同樣不能因此說:
「模型完全不受 distractor 影響。」
更合理的說法是:
在 Day 14 事前 frozen 的六個 distractor-resistance cases 中,本次 run 為 6 / 6。
這也是為什麼 Day 14 把 wording guardrails 先寫好很有用。
結果一出來 100%,很容易不小心把語氣寫太大。
昨天 synthetic dry run 的 Accuracy 是:
45.83%。
今天 REAL run:
95.83%。
但這兩個數字不能拿來比較。
因為 Day 14 的 fake provider 是我故意設計成會製造 failure 的。
Multi-step 甚至被故意注入成 0 / 6。
它測的是:
分析 pipeline 能不能抓到已知的 injected failure。
Day 15 才是真的:
模型在 frozen benchmark 上怎麼回答。
所以:
45.83% → 95.83%
絕對不是:
「模型比 synthetic baseline 強 50%。」
兩者根本不是同一種 evidence。
96 個 requests 全部完成後,Day 15 也沒有立刻把表格當成最終結果。
它先經過 Day 12 建立的 offline verifier。
這次 verifier:
17 / 17 PASS。
檢查內容包含:
Benchmark identity。
Artifact hashes。
Record count。
Record uniqueness。
Prompt version。
Request accounting。
Public artifact safety。
Derived outputs。
最後 canonical run 才被視為可以發布的 REAL artifact。
也就是今天的流程其實是:
Frozen Benchmark
→ REAL API
→ 96 Logical Requests
→ Records
→ Scoring
→ Stratified Analysis
→ Failure Diagnosis
→ Manifest
→ Offline Verification
→ Publishable REAL Result
這幾天做的基礎設施,到今天終於第一次全部一起被用到了。
Day 15 完整 test suite 最後:
181 passed
Canonical verifier:
17 / 17 PASS
Secret scan:
PASS。
Raw-response scan:
PASS。
Benchmark hash:
和 Day 14 完全一致。
而且沒有任何 post-hoc 修改:
Benchmark 沒改。
Gold 沒改。
Normalization 沒改。
Metrics 沒改。
Prompt version 沒改。
Failure policy 也沒改。
這一點其實比 23 / 24 更重要。
因為 23 / 24 是模型結果。
「看到結果後沒有動測量規則」才是今天整個 experiment design 真正想做到的事情。
這次有一個非常值得之後繼續追的現象。
24 筆 primary responses:
Mean self-confidence:
1.0。
包含那一筆錯誤。
換句話說,至少以目前這個 prompting / structured response 設計來看,self-reported confidence 幾乎沒有提供 ranking information。
所有題目都說:
「我完全確定。」
如果每次都是 1.0,那 confidence 就很難區分:
哪一題值得信。
哪一題應該人工 review。
這可能有很多原因。
可能和 prompt 有關。
可能和模型輸出 confidence 的方式有關。
可能是 benchmark 對模型而言太容易。
也可能 self-reported probability 本來就不是一個可靠的不確定性 estimator。
但目前資料還不能告訴我是哪一個原因。
所以這會變成後面很值得繼續追的一條線:
如果模型永遠說 100%,self-reported confidence 還有沒有實際用途?
相比之下,Agreement 在 23 個正常 cases 大多非常高。
但唯一錯誤 D14-011:
降到 0.6667。
因此整體 Mean Agreement:
0.972222
沒有像 Self-report 一樣鎖死在 1.0。
這使得 Agreement 在這次 run 裡:
Brier 較低。
ECE 也較低。
但我現在仍然只敢寫:
Agreement 在這個 24-case benchmark 中呈現出比 self-reported confidence 更多的 case-level variation。
這件事值得測。
但還不是最後答案。
今天第一次真正執行:
Frozen Stratified REAL Benchmark。
結果:
24 個 REAL cases。
96 個 REAL API requests。
96 / 96 成功。
Accuracy:
23 / 24 = 95.83%。
四個 strata:
唯一錯誤:
D14-011
而它是一個:
overconfident_error
Self-confidence:
1.0
Agreement:
0.6667
Severity:
HIGH
六個 insufficient-information cases:
全部成功 abstain。
Overall calibration:
Self-reported Brier = 0.041667
Agreement Brier = 0.023148
Self-reported ECE = 0.041667
Agreement ECE = 0.013889
Canonical verifier:
17 / 17 PASS
Full test suite:
181 passed
最重要的是:
從 Day 14 freeze 之後,到今天結果完成以前,
沒有任何 benchmark、Gold、normalization、metric、prompt 或 failure policy 被事後修改。
這讓 Day 15 對我來說不只是:
「模型答對 23 題。」
而是 AI Reliability Lab 第一次真正擁有:
在看到答案以前先定義測量方法,看到答案以後接受結果的 REAL evidence。
下一步,我想開始追一個今天非常明顯的問題:
如果 Self-reported confidence 永遠都是 1.0,我還能怎麼估計模型真正的不確定性?


 iThome鐵人賽
 看影片追技術