

Day 15 跑完 frozen benchmark 後,整體結果其實滿漂亮的。24 題裡答對 23 題,Accuracy 是 95.83%,Agreement confidence 的 Brier Score 和 ECE 也都比 self-reported confidence 低。不過我在整理結果的時候,反而一直注意到另一個更奇怪的地方:24 題的 self-reported confidence 全部都是 1.0。
也就是說,不管模型答對還是答錯,它都覺得自己 100% 確定。唯一答錯的 D14-011 也一樣給 1.0。這讓我開始懷疑,雖然 self-confidence 的 Brier Score 看起來沒有很差,但如果每一題數字都一樣,那這個 confidence 對實際系統到底有沒有幫助?
所以 Day 16 我沒有再跑新的 API。今天完全是用 Day 15 已經收好的 24 筆 REAL records 做離線分析。OpenAI API requests、provider calls、network calls全部都是 0。我想處理的問題很簡單:除了 calibration 之外,confidence 本身到底有沒有能力把「比較值得擔心的 case」分出來。
之前在看 Brier Score、ECE 的時候,我主要在看 calibration,也就是 confidence 和實際 correctness 是否對得上。假設模型常常說自己有 80% 把握,那長期來看,這些 80% confidence 的答案是不是大約真的有 80% 答對。
但如果要把 confidence 用在實際流程裡,例如「低 confidence 的答案送人工 review」,還有另一個很重要的問題:不同 case 的 confidence 有沒有真的不一樣。
舉個很極端的例子,如果模型 100 題裡答對 96 題,而且每一題 confidence 都固定填 0.96,那 aggregate calibration 可能看起來還不錯,但你完全沒辦法靠 confidence 找出哪四題比較危險,因為全部都是一樣的分數。
這就是 Day 16 想看的另一件事:resolution。白話一點講,就是這個 confidence signal 到底有沒有「分辨力」。
Day 15 的 self-reported confidence 幾乎是最極端的例子。24 筆資料的 mean、minimum、maximum 全部都是 1.0,population standard deviation 直接是 0,而且只有一個 distinct confidence value。正確的 23 題平均 confidence 是 1.0,唯一答錯的一題平均當然也是 1.0。
所以如果現在要我用 self-confidence 排出「最需要人工檢查的題目」,根本排不出來,因為 24 題全部並列第一。
Agreement confidence 就稍微有點變化。它的平均是 0.9722,最低是 0.6667,最高是 1.0,一共有兩個不同的 confidence level。23 個正確 case 的平均 agreement 是 0.9855,唯一錯誤的 D14-011 則是 0.6667。
雖然兩個 level 還是非常粗,但至少它沒有全部卡死在同一個數字。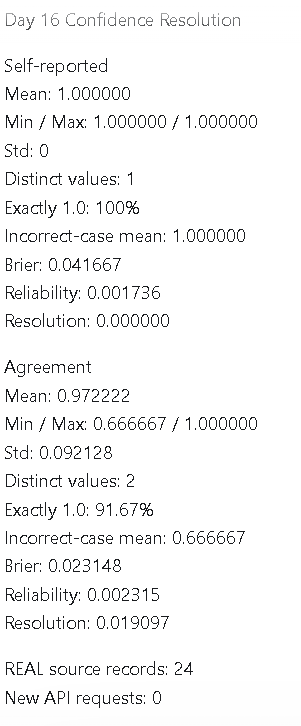
Day 15 的結果裡,self-reported confidence 的 Brier Score 是 0.041667,Agreement 是 0.023148。只看這個數字,很容易直接說 Agreement 比較好,但我想再往下一層看,所以 Day 16 加了 Brier decomposition。
Brier Score 可以拆成:
Reliability - Resolution + Uncertainty
這裡的 Reliability 比較接近 confidence 和該 confidence group 實際 accuracy 的落差;Resolution 則是看不同 confidence group 的 correctness rate 能不能和整體平均拉開;Uncertainty 則和整體的 base rate 有關。
這次 Day 15 整體是 23/24,所以兩個 confidence signal 的 uncertainty 都一樣:
0.0399306
Self-reported confidence 的 decomposition 是:
| Component | Value |
|---|---|
| Brier | 0.0416667 |
| Reliability | 0.0017361 |
| Resolution | 0 |
| Uncertainty | 0.0399306 |
Agreement 則是:
| Component | Value |
|---|---|
| Brier | 0.0231481 |
| Reliability | 0.0023148 |
| Resolution | 0.0190972 |
| Uncertainty | 0.0399306 |
兩邊重新組回 Brier Score 的誤差都小於 1e-12。
這裡我最在意的不是 Brier 本身,而是 self-reported confidence 的 Resolution 真的是 0。原因也很直接:24 題全部都在同一個 confidence group,也就是 1.0,當然沒辦法形成高低 confidence group 之間的差異。
Agreement 則因為至少有 1.0 和 0.6667 兩個 level,所以出現了非零的 empirical resolution。不過這個結果不能講太大,因為資料只有 24 筆,而且只有一個 error。現在只能說,在這一批 REAL records 裡,Agreement 比 self-report 多出一些 case-level variation,不能直接推成 Agreement 在一般情況一定比較好。
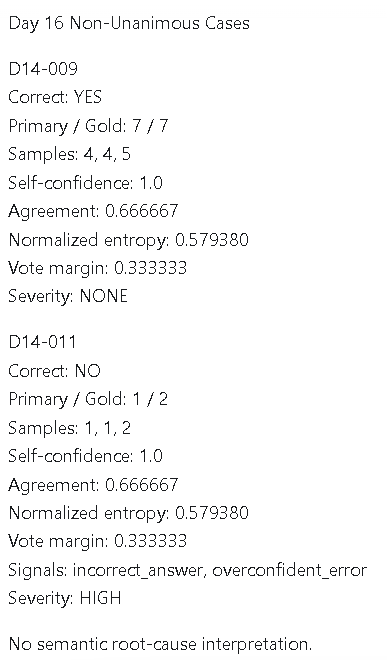
接著我直接回去看三個 independent samples。24 題裡只有兩題不是 unanimous,而且兩題都在 multi_step_reasoning。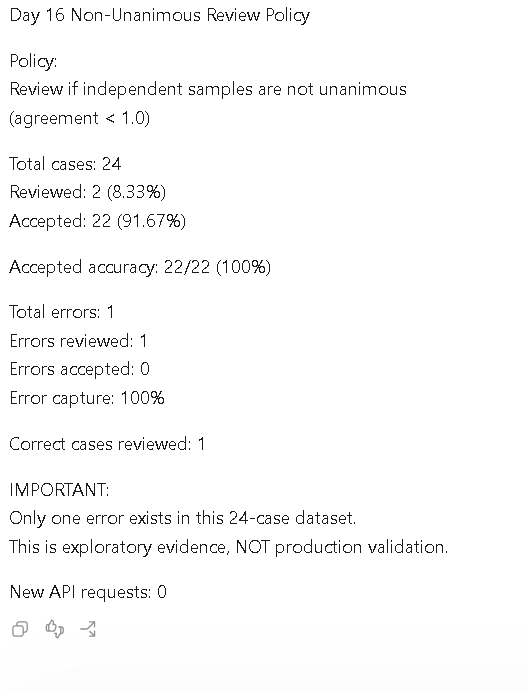
第一題是 D14-009。Primary answer 是 7,Gold 也是 7,所以這題最後判定是正確的。不過三個 samples 卻是:
4, 4, 5
也就是三個 sample 沒有一個答 7。
它的 Agreement 是 0.6667,normalized entropy 是 0.57938,vote margin 是 0.33333。Self-reported confidence 還是 1.0。
這題我覺得很有意思,因為只看 primary 的話,會覺得它完全沒問題:答對、confidence 1.0。但看 sampling 會發現,模型其實沒有想像中穩定,只是 primary 剛好答對。
另一題 D14-011 就是 Day 15 唯一答錯的 case。Primary answer 是 1,Gold 是 2,samples 是:
1, 1, 2
它的 Agreement 一樣是 0.6667,normalized entropy 也是 0.57938,vote margin 也是 0.33333。不同的是,這題 primary 本身答錯,所以 Day 13 的 diagnosis 會給它:
incorrect_answer
和
overconfident_error
Severity 是 HIGH。
把 D14-009 和 D14-011 放在一起看,其實也提醒我一件事:sampling disagreement 不能直接當成「答案錯了」的證明。兩題的 disagreement 指標幾乎一模一樣,但一題 primary 是對的,一題是錯的。
所以 Agreement、entropy、vote margin 比較適合被理解成「這題生成結果不太穩定」,而不是 correctness oracle。
分析到這裡後,我想把這些 signal 往實際工程用途推一步。
假設未來 AI Reliability Lab 不是只做 benchmark,而是真的放進一個系統裡,我不可能每一個答案都人工檢查。比較實際的方法可能是:高 confidence 自動接受,低 confidence 送人工 review。
所以 Day 16 做了一個簡單的 selective review 分析。
Self-reported confidence 幾乎沒有什麼可分析的,因為唯一的 observed threshold 就是 1.0。如果規則是 confidence >= 1.0 就接受,那 24 題全部都會直接通過,唯一錯誤也一樣通過。
結果就是:
| Item | Result |
|---|---|
| Accepted | 24 |
| Reviewed | 0 |
| Coverage | 100% |
| Accepted correct | 23 |
| Accepted errors | 1 |
| Accepted accuracy | 95.83% |
| Error capture | 0% |
 這很清楚地說明一件事:self-confidence 不是「threshold 不好選」,而是根本沒有東西可以選。
Agreement 就不一樣了。它有 1.0 和 0.6667 兩個 observed values。如果只接受 Agreement = 1.0 的 case,那會自動接受 22 題,另外兩題送 review。
這 22 題剛好全部答對,兩個被 review 的 case 就是 D14-009 和 D14-011,其中 D14-011 是唯一錯誤。
所以結果是:
| Item | Result |
|---|---|
| Accepted | 22 |
| Reviewed | 2 |
| Coverage | 91.67% |
| Accepted accuracy | 100% |
| Errors reviewed | 1 |
| Errors accepted | 0 |
| Correct cases reviewed | 1 |
換句話說,在這批資料裡,只 review 2/24,也就是 8.33% 的 case,就剛好把唯一錯誤抓到,而且剩下自動接受的 22 題全部正確。
這看起來很漂亮,但也是今天最不能過度解讀的地方。因為整份資料只有一個 error。抓到 1/1 和抓到 100/100 完全是不同等級的證據。
所以我沒有把它寫成一個已經驗證的 production policy,只把它定義成一個很簡單的 exploratory rule:
day16-nonunanimous-review-policy-v1
規則就是:
agreement < 1.0 就送 review。
它這次的結果很好,但還遠遠不到可以說「這個方法已經有效」。
Day 16 還加了 Shannon entropy 和 vote margin,但這兩個我現在只把它們當作 sampling disagreement 的描述工具。
目前每題只有三個 samples,資料非常少。2 比 1 的 split 就已經會讓 entropy 明顯上升,但這不代表我們真的知道模型內部的 uncertainty。
而且這些 samples 本身全部還是同一個模型生成的,所以它們不是外部獨立證據。
因此目前比較安全的說法是:
Agreement、entropy、vote margin 都是在描述「多次生成之間有多一致」。
它們可能和風險有關,但不是「真實不確定性」。
這一天所有數字都來自 Day 15 的 canonical REAL run:
20260928T053709Z-96bb5e53
分析前重新跑 verifier,結果仍然是:
17 / 17 PASS
Day 15 source records 沒改。
Day 14 benchmark hash 沒改。
Day 13 diagnosis policy 也沒改。
所以 Day 16 不是新的 REAL Experiment,而是 existing REAL evidence 的 derived analysis。
今天新增的主要是 confidence distribution diagnostics、Brier decomposition、sample entropy、vote margin,以及 selective review analysis。完整 test suite 最後是:
217 passed
而且沒有任何新的 API、provider 或 network call。
Day 16 最後我得到的不是「Agreement 已經贏了」。
比較像是發現了一個新的問題。
Self-reported confidence 在這次資料裡完全沒有 resolution,因為 24 題全部都是 1.0。Agreement 至少能把兩題 non-unanimous case 分出來,其中一題剛好是唯一錯誤,所以拿去做 selective review 看起來有點潛力。
但現在每題只有三個 independent samples,Agreement 本身能取的值也非常粗。三次 sampling 不是 unanimous 的時候,大部分情況就是 2/3。
所以接下來真正值得問的是:
如果 sample 數從 3 增加到 5、7、9,Agreement 會不會更穩?又要多花多少 request?
這會是下一步我要處理的問題。
Day 16 到這裡比較確定的一件事只有:
Confidence 不只是要看準不準,也要看它有沒有辦法把不同 case 分開。
如果每一題都永遠是 1.0,再漂亮的 confidence 數字,到了實際決策時也可能沒什麼用。


 iThome鐵人賽
 看影片追技術