

Day 16 做完後,我原本很自然地想到一件事:既然三次 independent sampling 太粗,那多抽幾次不就好了?
現在每題只有 3 個 samples,所以 Agreement 能看到的變化很有限。Day 15 的 24 題裡,實際上幾乎就是 1.0 和 0.6667 兩種狀態。Day 16 雖然發現唯一錯誤 D14-011 的 Agreement 剛好降到 0.6667,但另一題 D14-009 也是 0.6667,而且 primary answer 是對的,所以我不能因為剛好抓到那一題錯誤,就直接宣布「三次 sampling 很有效」。
更直接的問題是:如果未來真的把 sample 數從 3 增加到 5、7、9,Agreement 會變得比較細沒錯,但到底會不會比較穩?人工 review 的決策會不會更可靠?又要多花多少 request?
所以 Day 17 我還是沒有打新的 API,而是先把這些問題用數學和 Synthetic simulation 算一輪。今天所有結果都不是新的模型表現,Day 15 的 REAL records 也完全沒有被補出假的第 4、5、6 個 sample。
分析版本是:
day17-sampling-budget-analysis-v1
Day 15 source run 在開始前重新驗證,仍然是:
17 / 17 PASS
今天的 OpenAI API requests、provider calls 和 network calls也全部都是 0。
現在 n=3 時,Agreement 能表達的數字非常粗。增加 sample count 後,確實可以得到更細的數值。
| Samples | Possible Agreement Levels | Level Count | Spacing |
|---|---|---|---|
| 3 | 1/3, 2/3, 3/3 | 3 | 0.333333 |
| 5 | 1/5 ~ 5/5 | 5 | 0.200000 |
| 7 | 1/7 ~ 7/7 | 7 | 0.142857 |
| 9 | 1/9 ~ 9/9 | 9 | 0.111111 |
所以如果只看「數字細不細」,增加 sample 當然有幫助。n=3 一格就是 0.3333,n=7 一格縮到大約 0.1429,n=9 更細到 0.1111。
但這只能說 estimator 的刻度變細,不能直接說它變得更準,更不能說模型答題能力因此變好。這點後面的結果其實會變得很明顯。
我先從一個很單純的情況開始。假設模型每次 sampling 只有兩種答案,其中比較常出現的那個答案,每次出現的機率是 q。
例如 q = 0.9,可以想成模型每次獨立抽樣有 90% 機率回傳同一個 preferred answer;q = 0.5 則表示兩個答案幾乎完全五五波。
這部分沒有用 Monte Carlo,而是直接算 binomial probability。
先看幾個比較有代表性的 q。
| q | Samples | Preferred Majority | Unanimous | Non-unanimous | Expected Agreement |
|---|---|---|---|---|---|
| 0.50 | 3 | 0.5000 | 0.2500 | 0.7500 | 0.7500 |
| 0.50 | 9 | 0.5000 | 0.0039 | 0.9961 | 0.6367 |
| 0.60 | 3 | 0.6480 | 0.2800 | 0.7200 | 0.7600 |
| 0.60 | 9 | 0.7334 | 0.0103 | 0.9897 | 0.6582 |
| 0.75 | 3 | 0.8438 | 0.4375 | 0.5625 | 0.8125 |
| 0.75 | 9 | 0.9511 | 0.0751 | 0.9249 | 0.7580 |
| 0.90 | 3 | 0.9720 | 0.7300 | 0.2700 | 0.9100 |
| 0.90 | 9 | 0.9991 | 0.3874 | 0.6126 | 0.9001 |
| 1.00 | 3 | 1.0000 | 1.0000 | 0 | 1.0000 |
| 1.00 | 9 | 1.0000 | 1.0000 | 0 | 1.0000 |
這裡有一個我一開始沒有特別想到的現象。
假設 q = 0.9,n=3 時 samples 全部 unanimous 的機率還有 73%。但 n=9 時,unanimous 的機率反而只剩 38.74%。
原因其實很簡單。樣本抽得越多,要「每一次都一樣」就越難。
所以如果我把 Day 16 的規則直接搬過來:
只要 samples 不是 unanimous 就送人工 review
那 sample 數增加之後,不一定會讓 review policy 更精準,反而可能只是讓更多 case 被送去 review。
這是 Day 17 第一個很重要的結果。
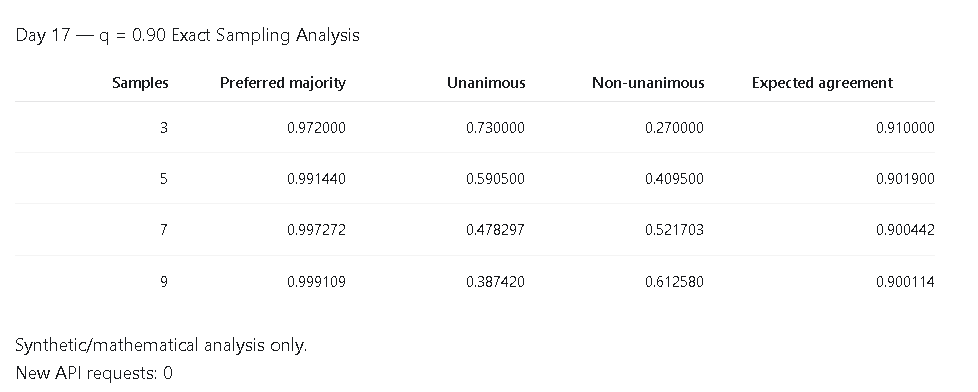 另一方面,多抽幾次也不是完全沒有好處。
即使單次 sampling 有 90% 機率落在 preferred answer,增加 sample 數仍會讓 majority vote 更穩,但「全部 samples 一致」反而越來越難,因此 unanimity 不能直接跨不同 sample count 當成同一套 review 標準。
還是用 q = 0.75 當例子。
n=3 時,majority vote 選到 preferred answer 的機率大約是:
84.38%。
n=5:
89.65%。
n=7:
92.94%。
n=9:
95.11%。
也就是如果 underlying distribution 本身真的偏向某一個答案,增加 sample count 會讓 majority vote 更穩定地找出那個 modal answer。
q = 0.9 時更明顯。
n=3 已經是 97.2%,到了 n=9 變成 99.91%。
所以增加 sampling budget 確實可以改善一部分東西,只是「多抽幾次」和「全部一致」是兩個不同概念。
前者可能讓 majority estimate 更穩定,後者反而會越來越難達成。
真實 LLM 當然不一定只會在兩個答案之間選。
所以第二部分我做了五種事先固定好的 Synthetic distributions:
| Scenario | Distribution |
|---|---|
| Stable | [0.95, 0.05] |
| Moderately stable | [0.75, 0.25] |
| Ambiguous binary | [0.55, 0.45] |
| Three-way | [0.50, 0.30, 0.20] |
| Diffuse | [0.40, 0.35, 0.25] |
每種 scenario 都分別測 n=3、5、7、9,每一格跑 100,000 次 simulation,random seed 固定為:
17092026
這些全部都是 Synthetic,目的是看 sampling estimator 本身的行為,不是模擬 GPT-5.6 Luna 的真實答案分布。
結果裡有幾個滿明顯的趨勢。
| Scenario | Mean Agreement n=3 → n=9 | Unanimity n=3 → n=9 | Population-mode Match n=3 → n=9 |
|---|---|---|---|
| Stable | 0.9523 → 0.9499 | 85.70% → 62.89% | 99.24% → 100.00% |
| Moderately stable | 0.8117 → 0.7584 | 43.50% → 7.53% | 84.46% → 95.17% |
| Ambiguous binary | 0.7522 → 0.6425 | 25.66% → 0.53% | 57.48% → 62.18% |
| Three-way | 0.6597 → 0.5519 | 15.88% → 0.19% | 67.89% → 77.08% |
| Diffuse | 0.6375 → 0.5138 | 12.17% → 0.03% | 56.02% → 56.90% |
最直觀的是 unanimity。
只要 underlying distribution 不是幾乎完全固定,多抽幾次後,要全部 samples 完全一樣會越來越困難。
例如 Moderately stable 的 [0.75, 0.25],n=3 時還有 43.5% 機率全部一致;到了 n=9,只剩 7.53%。
Diffuse scenario 更誇張,n=9 時 unanimity 幾乎只剩:
0.03%。
所以「samples 不 unanimous 就 review」這條規則,本質上其實非常依賴 sample count。
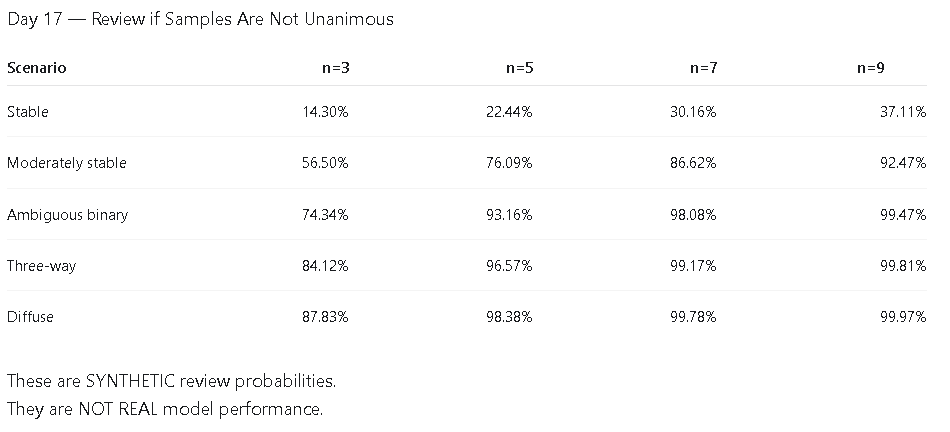
Synthetic simulation 顯示,如果沿用 Day 16 的「samples 不 unanimous 就 review」,隨著 sample count 增加,大多數非極度穩定的 distribution 最後幾乎都會被送去 review。Sample budget 改變後,review policy 也必須一起重新設計。
Day 16 的規則很單純:
agreement < 1.0 → review
也就是只要不是全數一致就 review。
拿到 Synthetic simulation 裡跑,結果如下:
| Scenario | Review Probability n=3 | n=5 | n=7 | n=9 |
|---|---|---|---|---|
| Stable | 14.30% | 22.44% | 30.16% | 37.11% |
| Moderately stable | 56.50% | 76.09% | 86.62% | 92.47% |
| Ambiguous binary | 74.34% | 93.16% | 98.08% | 99.47% |
| Three-way | 84.12% | 96.57% | 99.17% | 99.81% |
| Diffuse | 87.83% | 98.38% | 99.78% | 99.97% |
看到這張表後,Day 16 那個 rule 就變得很清楚。
它不是一條可以直接跨 sample count 使用的固定 policy。
例如 [0.75, 0.25] 這種還算有明顯 preferred answer 的 distribution,n=3 時 review 大約 56.5%;到了 n=9,竟然會 review 92.47%。
如果放到產品裡,人工 review workload 會完全不同。
所以未來如果 sample_count 改變,review threshold 也一定要重新定義,不能單純沿用「不 unanimous 就 review」。
Day 17 另外比較了兩批獨立 samples 會不會做出同樣的 review / accept decision。
有些 scenario 到 n=9 時 decision agreement 非常高。
例如 diffuse distribution:
n=9 時 two-batch agreement 是:
99.94%
乍看非常穩。
可是它穩的原因其實是:
兩批幾乎都會選擇 review。
Review probability 已經是:
99.97%
所以「兩次 decision 幾乎永遠一樣」並不代表這個 policy 很有辨識力,它也可能只是幾乎永遠輸出同一個答案。
這和 Day 16 self-confidence 全部 1.0 的問題其實有點像。
穩定本身不是目的。
如果一個 decision rule 永遠都是 review,當然非常穩,但那也失去選擇性。
我另外固定一個純示範 threshold:
agreement < 0.8 → flag
0.8 不是調參找出來的最佳值,只是事前固定,拿來觀察不同 n 的行為。
結果也不是完全單調。
例如 Stable scenario 的 flag probability:
n=3:14.30%
n=5:2.26%
n=7:4.35%
n=9:7.07%
這個變化看起來有點怪,其實和 Agreement 的離散刻度有關。
不同 sample count 可以取到的 Agreement values 不一樣,固定 0.8 threshold 剛好會切在不同格子中間,所以 policy 行為也會跟著變。
這也再次提醒我:
sampling budget 和 threshold 不能分開設計。
今天只改 sample_count、不重新看 decision rule,本身就可能改變整個 review system。
前面的數學和 simulation 都不用 API,但未來如果真的要增加 REAL sampling,request 數就會直接上升。
Frozen benchmark 還是 24 題,每題保留一個 primary,再加 k 個 samples。
| Samples per Case | Primary Requests | Sample Requests | Total | Increase vs Day 15 | Factor |
|---|---|---|---|---|---|
| 3 | 24 | 72 | 96 | 0 | 1.0× |
| 5 | 24 | 120 | 144 | +48 | 1.5× |
| 7 | 24 | 168 | 192 | +96 | 2.0× |
| 9 | 24 | 216 | 240 | +144 | 2.5× |
所以從 3 samples 提高到 9,不是免費得到更細的 uncertainty estimate。
request 數會從:
96
增加到:
240。
等於 2.5 倍。
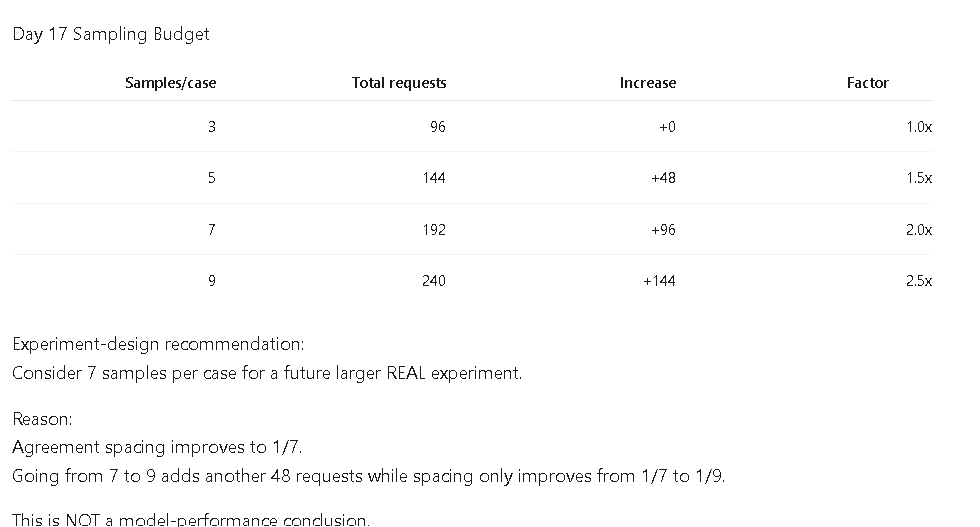
增加 sampling budget 的 request 成本。Day 17 暫時把 7 samples 當作下一輪 REAL experiment 的候選設計,理由是 granularity 與 request 數的折衷,而不是因為它已經被證明能提升模型正確率。
Day 17 最後給的 experiment-design recommendation 是:
未來如果要做一輪較大的 REAL experiment,可以優先考慮 7 samples per case。
這不是因為 7 samples 在 D14-011 上一定比較好,因為我根本沒有補跑 D14-011 的第 4 到第 7 次 REAL sample。
推薦 7 的理由比較單純。
n=3 的 Agreement spacing 是 1/3,真的太粗。
n=5 改善到 1/5。
n=7 已經到:
1/7 ≈ 0.1429。
如果再升到 n=9,只會從:
0.1429
改善到:
0.1111。
但 request 數卻要從:
192
再增加到:
240。
也就是多 48 個 requests。
所以目前看起來,7 是一個可以拿來做下一輪實驗設計的中間點:比 3、5 有更細的 granularity,但又沒有直接把 request 拉到 9 samples 的 240 次。
這不是模型 performance 結論,只是 sampling budget 的工程取捨。
Day 17 做完後,我覺得最重要的反而不是最後推薦了 7 samples。
而是發現原本很直覺的一句話:
「Samples 不一致就人工檢查。」
其實沒有想像中那麼簡單。
因為 sample 數改變後,「不一致」本身的機率也會大幅改變。
抽 3 次都一樣和抽 9 次都一樣,本來就是兩個完全不同難度的事件。
所以如果未來真的把 sampling budget 從 3 增加到 7,我不能只修改:
sample_count = 7
然後其他 review policy 全部原封不動。
sample count、Agreement granularity、threshold 和人工 review workload其實是一起綁著的。
今天沒有新的 REAL model evidence。Day 15 的 24 筆 REAL records 還是原本那 24 筆,我也沒有拿三個 samples 去幻想第 4 到第 9 個答案會是什麼。
Day 17 所做的比較像是在下一輪 REAL experiment 前,把 sampling 這件事的代價和行為先算清楚。
最後完整 test suite:
310 passed in 17.69s
Day 15 verifier:
17 / 17 PASS
API requests:
0
Provider calls:
0
Network calls:
0
下一次如果真的要增加 sampling budget,至少現在不會只是因為「感覺多抽幾次比較準」就直接開始燒 request 了。


 iThome鐵人賽
 看影片追技術