
上一篇介紹了知識庫的卡片,以及用關鍵字找資料的方式。不過,有時候我要找東西,只記得大概的用途或內容,卻想不起來名稱,也不確定該輸入什麼關鍵字。
所以我嘗試在知識庫裡串接 AI 的原因是我希望可以直接描述自己的想法,讓它幫我找出可能相關的資料,再整理給我看,這樣就不用每一筆重新翻。
例如,我可能記得看過一篇勒索軟體的入侵案例,但忘了是哪個組織、哪一種勒索軟體。如果只能靠名稱搜尋,就會有點不知道從哪裡開始。
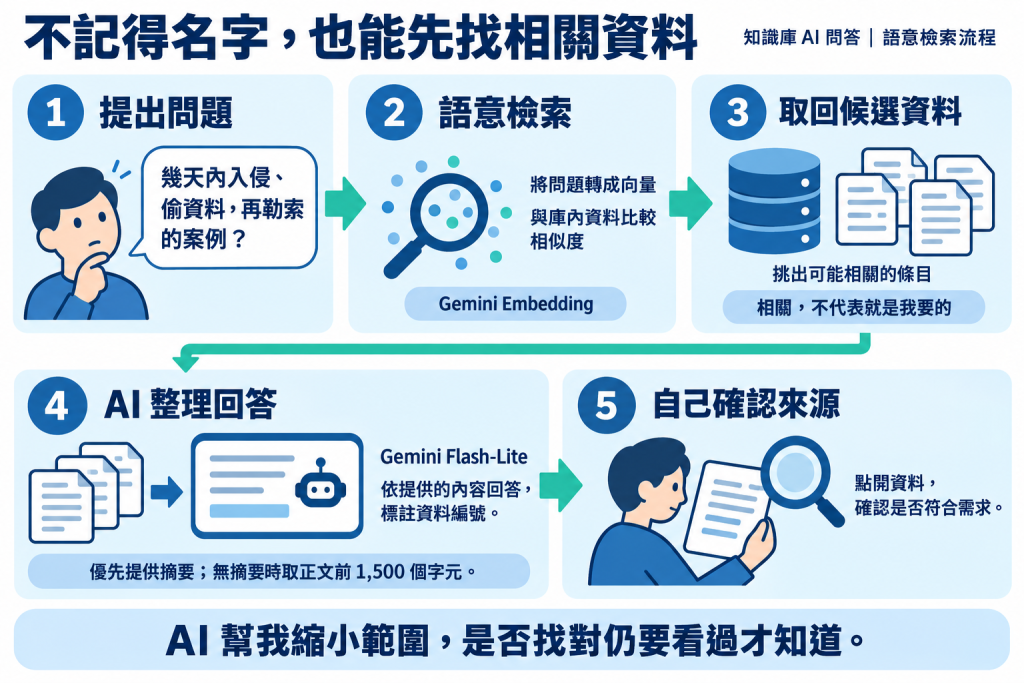
目前系統裡有一個「問知識庫」的功能,可以輸入問題,讓 AI 根據知識庫裡的資料回答。
為了寫這篇,我請 AI 協助核對正式版的程式,也實際測試了一次,重新了解這個功能是怎麼運作的。
它的流程大致是:
提出問題 → 系統找相關資料 → AI 整理回答 → 我查看內容與來源。
這裡其實有兩個不同的工作:先找到資料,再根據資料回答。
正式版目前使用 gemini-embedding-001,把問題與資料轉成一組數字,這個數字表示叫做「向量」。系統再比較這些向量的相似程度,挑出可能相關的資料。
我先把它理解成:除了比對有沒有出現同一個詞,也多了一種依照內容意思尋找資料的方式。不過,相似程度高,還是不能直接當成找對了。
找到候選資料後,再交給 Gemini Flash-Lite 整理回答。程式使用的是 gemini-flash-lite-latest 這個別名,本次另外查詢模型時,回傳的版本是 gemini-3.5-flash-lite。因為別名可能隨更新切換,所以這是本次查證的結果。
這次選的是前一篇出現過的「BlackByte 2.0 五日入侵完整攻擊鏈 IR 案例」。
先前直接指定案例名稱時,系統可以找到資料並產生概要。但這還不能確認,當我忘記名稱、只記得部分內容時,它是不是也能找到。
所以這次由 AI 協助在正式版輸入下面這個問題:
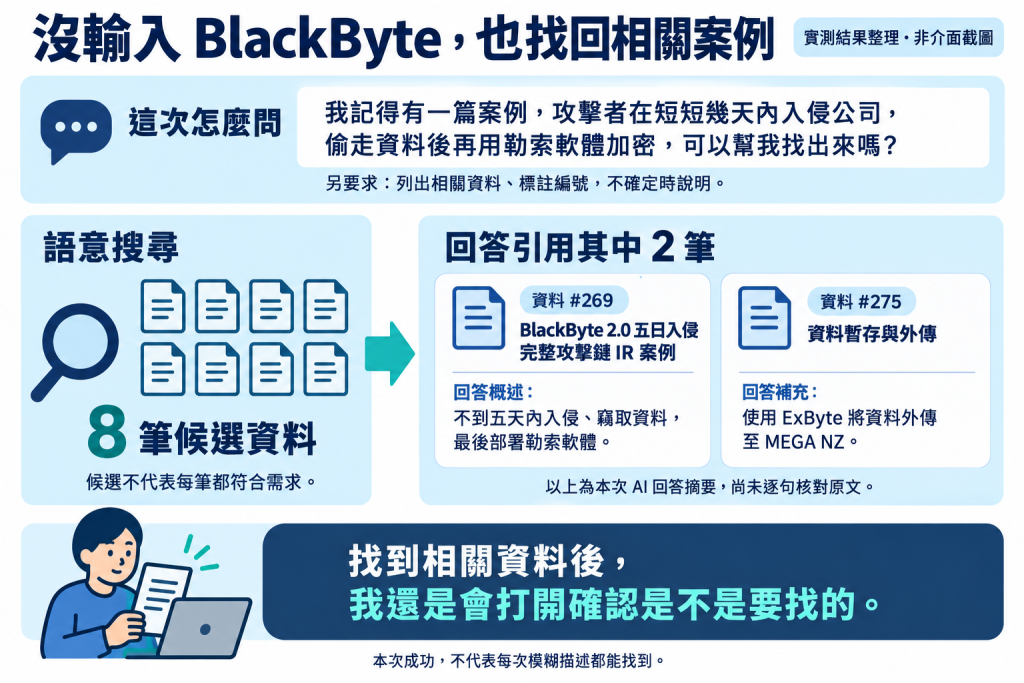
我記得有一篇案例,攻擊者在短短幾天內入侵公司,偷走資料後再用勒索軟體加密,可以幫我找出來嗎?請列出可能相關的資料並標註資料編號,不確定時請說明。
這句沒有出現 BlackByte,也沒有寫出案例的完整標題,只保留我可能記得的幾個線索:時間很短、入侵公司、偷走資料,以及最後進行加密。
這次系統使用語意搜尋,取回了八筆候選資料,最後的回答引用了其中兩筆:
回答先說明完整案例記錄的入侵過程,再用另一筆資料補充外傳的細節。
這個結果有接近我的期待。即使沒有記得名稱,也可以先透過描述找到相關的內容。
這次測試也讓我注意到,「系統找回來的資料」和「AI 最後引用的資料」並不是同一件事。
系統先取回八筆候選資料,回答中引用的是兩筆。不能因為有八筆結果,就認為每一筆都符合我的需求。
而且,我描述得比較模糊,也可能有其他案例符合「先偷資料,再進行勒索」這個情境。
所以即使 AI 找到了資料,我還是會先把它當成可能相關的內容。要看過,才能確定是不是原本想找的那篇。
對我來說,能先縮小範圍,不用每一筆重新翻,就已經有幫助了。
這次核對程式時,還確認到一個我覺得需要說明的地方:目前回答模型不是把知識庫裡的每篇原文全部讀完。
系統取回候選資料後,會優先把各筆資料的摘要提供給它;如果沒有摘要,才取正文前 1,500 個字元。
也就是說,如果某個重要限制沒有出現在摘要裡,這次回答就可能沒有拿到那段資訊。
提示詞有要求 AI 根據提供的資料回答、標註資料編號,資料不足時不要編造。但這是給它的要求,仍然要從實際結果確認它有沒有做到。
這次測試確認了系統能找回案例、產生回答並標註來源,還沒有逐句對照原文,核實回答中的每個細節。因此,我不會只因為看到資料編號,就認為內容一定正確。
這也接回前面一直在調整的事情:資料存進來之後,摘要整理得如何,也會影響後面能怎麼使用它。
目前我希望的使用方式,大致就是這樣。
記得名稱或關鍵字時,可以直接搜尋;只記得大概內容時,就試著描述給 AI,讓它先幫我找出可能相關的資料,再整理給我看。
這次用模糊描述找到了 BlackByte 案例,不代表之後每個問題都一定能成功。不過,它確實讓我看到,原本存下來的資料,可以多一種找回來的方式。
最後是不是我要找的、整理的內容有沒有問題,我還是會打開來確認,也在閱讀的過程中再學一次。


 iThome鐵人賽
 看影片追技術