
上一篇把 Browser-use 裝好,也跑完第一支不用寫 selector 的自動化了。
但真的要拿來跑測試,光那幾行不夠。
要跟團隊的系統、腳本長期整合,就得先知道它能「控制」到什麼程度、能「留下」什麼證據。
這篇先看底層,再看六類常用功能:
| 分類 | 解決什麼問題 |
|---|---|
| 底層運作 | 它是怎麼從一句話,找到畫面上那顆按鈕的 |
| Agent 設定 | 控制 AI 怎麼跑、跑多久、遵守什麼規則 |
| Browser 設定 | 控制瀏覽器環境,讓每次執行條件一致 |
| Tools 自訂動作 | 把不該讓 AI 摸索的步驟,收回來自己寫 |
| Error Handling | 出錯時它會怎麼處理、我們能控制到哪 |
| 敏感資料 | 帳密不要送進 LLM |
| 結果輸出與證據 | 失敗時能回頭查,成功時能自己驗證 |
上一篇講過它大致的流程,但這裡要詳細拆開來看每一塊原理。
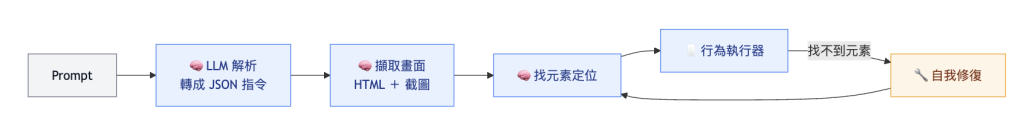
1. LLM 把 Prompt 轉成結構化指令
例如使用 GPT、Claude 等理解 Prompt 後產出一份 JSON,內容包含:
2. 擷取當前頁面:整頁 HTML + 截圖
3. 核心技術:自動找出定位點
| 做法 | 怎麼做 |
|---|---|
| 視覺為主 | 把截圖+HTML 片段餵給有視覺能力的模型,問「哪個是右上角的登入按鈕?」,讓它回傳元素與 XPath |
| 結構為主 | 先用 HTML 分析工具整理出所有 button / a / div,再讓 LLM 挑出最符合語意的那一個 |
4. 核心技術:行為執行器
把 JSON 指令轉成真正的瀏覽器操作:
def execute_action(action, driver):
    if action["type"] == "click":
        element = find_element(action["target"], driver)
        element.click()
    # verify、input、scroll... 每種行為都要自己寫
5. 核心技術:自我修復
Browser-use 就是把這幾塊都包好了,所以我們一句話就能跑。
而後面要講的常用功能,其實就是在調整每一塊:
| 底層環節 | 對應的功能 |
|---|---|
| LLM 解析 Prompt | task、extend_system_message |
| 擷取畫面(HTML+截圖) | use_vision、Browser 設定 |
| 行為執行器 | Tools 自訂動作 |
| 自我修復 | max_failures、Error Handling |
注意:這段的理解非常重要!後續文章會提到這個概念
from browser_use import Agent, ChatOpenAI

agent = Agent(
    task="搜尋「QA 三十天養成日記」,確認搜尋結果有出現列表",
    llm=ChatOpenAI(model="gpt-4.1-mini"),
    initial_actions=[{"navigate": {"url": "https://www.google.com"}}],
    extend_system_message="禁止點擊任何「刪除」「送出訂單」按鈕。",
    max_failures=3,
    max_actions_per_step=3,
)

history = await agent.run(max_steps=20)
| 參數 | 為什麼 QA 會需要 |
|---|---|
max_steps(放在 run()) |
最多走幾步,預設 100。不設的話,卡住時它會一直繞 |
max_failures |
同一步最多重試幾次,控制「自我修復」能修到什麼程度 |
max_actions_per_step |
每一步最多做幾個動作,調小一點過程比較好追 |
use_vision |
要不要把截圖給模型看,關掉省 token,但判斷畫面的能力會變弱 |
initial_actions |
開跑前先執行的固定動作,不經過 AI,前置步驟不用讓它猜 |
extend_system_message |
團隊的測試規則寫在這,每支測試都自動帶上 |
固定的步驟寫死,AI 只負責真正需要判斷的部分。
from browser_use import Browser

browser = Browser(
    headless=True,
    window_size={"width": 1920, "height": 1080},
    allowed_domains=["*.google.com"],
    wait_for_network_idle_page_load_time=3.0,
    record_video_dir="logs/videos",
)
| 參數 | 為什麼 QA 會需要 |
|---|---|
headless |
不開視窗跑,接 CI 一定要開 |
window_size / viewport |
桌機版、手機版畫面不一樣,要固定 |
allowed_domains |
限制只能去哪些網域 |
wait_for_network_idle_page_load_time |
頁面慢的系統要調大,不然畫面還沒出來就開始判斷 |
record_video_dir |
錄下整段執行影片,失敗時直接看最快 |
自我修復有時候「想辦法」的方式,就是跑去別的網站找答案,限制網域等於幫它畫好邊界。
內建動作就是點擊、輸入、捲動這些,不想讓 AI 自己摸索的步驟,就自己寫:
from browser_use import Tools, ActionResult, BrowserSession

tools = Tools()

@tools.action(description="用測試帳號登入後台")
async def login_with_test_account(browser_session: BrowserSession):
    page = await browser_session.must_get_current_page()

    account = await page.get_elements_by_css_selector("#account")
    password = await page.get_elements_by_css_selector("#password")
    submit = await page.get_elements_by_css_selector("button[type='submit']")

    await account[0].type("qa_test_user")
    await password[0].type("qa_test_password")
    await submit[0].click()

    return ActionResult(extracted_content="已用測試帳號登入")

agent = Agent(task="登入後台,確認首頁有顯示使用者名稱", llm=llm, tools=tools)
description 一定要寫清楚:AI 靠這段決定「什麼時候該用這個動作」ActionResult:內容會寫進執行紀錄,AI 也會讀到把 AI 的判斷留給真的需要判斷的地方。
| 出錯的地方 | 它會怎麼做 | 用什麼控制 |
|---|---|---|
| 動作失敗(找不到元素、點不到) | 換個方式再試(自我修復) | max_failures |
| LLM API 出錯(429 流量限制、逾時) | 自動重試,不行就切換備援模型 | fallback_llm |
| 單一步驟卡太久 | 直接中斷這一步 | step_timeout(預設 180 秒) |
agent = Agent(
    task="...",
    llm=ChatOpenAI(model="gpt-4.1-mini"),
    fallback_llm=ChatOpenAI(model="gpt-4.1"),
    max_failures=3,
    step_timeout=60,
)
批次跑幾十支測試時,沒設 fallback_llm,一支撞到 429,後面整批跟著全紅,看起來像系統壞了,其實是 API 被限流。
金額算錯這種錯誤,AI 自我修復的結果可能是繞過去、走完流程,最後還回報成功。
這種時候,直接在自訂動作裡結束整個任務:
EXPECTED_TOTAL = "1,280"

@tools.action(description="檢查購物車總金額是否正確")
async def check_cart_total(browser_session: BrowserSession):
    page = await browser_session.must_get_current_page()
    elements = await page.get_elements_by_css_selector(".cart-total")
    actual = await elements[0].get_text()

    if actual != EXPECTED_TOTAL:
        return ActionResult(
            extracted_content=f"金額錯誤:預期 {EXPECTED_TOTAL},實際 {actual}",
            is_done=True,
            success=False,
        )

    return ActionResult(extracted_content="金額正確")
is_done=True 讓 Agent 立刻停下,success=False 明確標記失敗。
自我修復適合用在「怎麼走到那裡」,不適合用在「結果對不對」。
帳密如果寫在 task 裡,會整段送到 LLM 的 API 上,改用 sensitive_data:
sensitive_data = {
    "https://*.example-staging.com": {
        "x_user": "qa_test_user",
        "x_pass": "qa_test_password",
    },
}

agent = Agent(
    task="用 x_user 和 x_pass 登入 example-staging.com",
    sensitive_data=sensitive_data,
    use_vision=False,
    llm=llm,
)
LLM 只看得到 x_user 這種代號,真正的值會直接填進表單,而且只在綁定的網域才會填入。
use_vision 關掉,是因為截圖可能會拍到填進去的帳密。
失敗時想回頭查,記得開 save_conversation_path(AI 的判斷過程)跟 record_video_dir(執行影片)。
save_conversation_path 是唯一能看到「AI 為什麼這樣做」的東西,一定要開。
agent.run() 回傳的結果,常用的方法:
history = await agent.run(max_steps=20)

history.action_names()     # 實際做了哪些動作
history.model_thoughts()   # 每一步的思考過程
history.errors()           # 每一步的錯誤
history.final_result()     # 最後的回答
history.is_successful()    # AI 自己判斷有沒有成功
官方文件原文:
"is_done() does not imply success. is_successful() reports the agent's own assessment; verify important external outcomes."
白話:is_successful() 只是 AI 對自己的評價,重要的結果要自己去驗。
做法是讓 AI 回傳固定格式的資料,再自己寫斷言:
from pydantic import BaseModel

class SearchResult(BaseModel):
    keyword: str
    result_count: int
    first_title: str

agent = Agent(
    task="搜尋「QA 三十天養成日記」,回傳第一筆結果的標題與結果數量",
    llm=llm,
    output_model_schema=SearchResult,
)

history = await agent.run()
result = SearchResult.model_validate_json(history.final_result())

assert result.result_count > 0
assert "QA 三十天養成日記" in result.first_title
判斷成功與否的權力,要拿回在我們自己手上。
想在每一步結束時做點事(截圖、記網址、寫 log),可以用 hooks:
async def log_each_step(agent: Agent):
    url = await agent.browser_session.get_current_page_url()
    print(f"這一步結束,目前在:{url}")

await agent.run(on_step_end=log_each_step)
on_step_start 跟 on_step_end 兩個時機可以掛。
Browser-use 改版很快,網路上的教學(包含我自己以前的筆記)很多都是舊寫法。
| 舊寫法 | 新寫法 |
|---|---|
Controller() |
Tools()(controller= 參數還能用,是 tools= 的別名) |
BrowserProfile(...) / BrowserConfig(...) |
Browser(...) |
from langchain_openai import ChatOpenAI |
from browser_use import ChatOpenAI |
自訂動作參數寫 browser: Browser |
要寫 browser_session: BrowserSession |
官方文件特別警告:自訂動作的參數名稱是靠「名字」對應注入的,名字寫錯,動作會默默失效,不會報錯。
所以看到範例時,先對一下官方文件的版本,再動手貼。


 iThome鐵人賽
 看影片追技術