
今天是我是實戰演練後的遇到狀況:同一個環境、同一支測試,我連續跑了三次,三次都成功。,但是 三次的過程完全不一樣!
我做了這兩類:
Test Step:
1. 打開 https://www.google.com
2. 在搜尋框輸入「QA 三十天養成日記」,按 Enter

Expect Result:
1. 搜尋結果列表有出現
2. 第一筆結果標題包含「QA 三十天養成日記」
步驟少、頁面單純、判斷點明確,每次都會 PASS。
到這裡我還是很興奮的,覺得這東西真的可以用!
使用:SauceDemo 練習,公開給大家練自動化的假購物網站
Test Step:
1. 打開 https://www.saucedemo.com
2. 帳號輸入 standard_user、密碼輸入 secret_sauce,點「Login」
3. 商品排序選「Price (low to high)」
4. 將「Sauce Labs Onesie」、「Sauce Labs Bolt T-Shirt」、「Sauce Labs Backpack」加入購物車
5. 點右上角購物車圖示,進入購物車頁
6. 在購物車頁點「Sauce Labs Bolt T-Shirt」的「Remove」
7. 點「Checkout」,填入 First Name: QA、Last Name: Tester、Zip: 100,點「Continue」
8. 在結帳確認頁點「Finish」

Expect Result:
1. 排序後第一個商品為「Sauce Labs Onesie」($7.99)
2. 結帳確認頁只有「Sauce Labs Onesie」、「Sauce Labs Backpack」兩項
3. 金額顯示 Item total: $37.98、Tax: $3.04、Total: $41.02
4. 出現「Thank you for your order!」
5. 右上角購物車圖示不再顯示數字
它最後還是會過,但發現每次過的方式不太一樣。
有時候中間會多繞去一個我沒預期它會去的頁面,然後再自己繞回來。
結果畫面是對的,只是過程不是。
當下我沒有很在意,想說「反正有過就好」。
這個念頭後來被我自己推翻了。
還記得昨天講的結果分析嗎?
result = await agent.run()
print(result.action_names())        # 它實際做了哪些動作
print(result.extracted_content())   # 每一步的描述與結果
print(result.errors())              # 過程中的錯誤
action_names() 是我後來最常看的一個。
因為它會告訴你這次總共做了幾步。
這個就變成我判斷「它是不是在亂繞」的第一個訊號。
browser-use 有一個很厲害的能力就是自我修復:找不到元素的時候,它不會直接失敗,而是自己去試別的可能,換個描述、捲動看看、找找有沒有長得像的東西。
當下我以為:太好了,這就是解決「產品改版腳本就死」的答案。
前端把按鈕文字從「送出」改成「確認送出」,傳統腳本直接錯一片,它完全不受影響。這在成功的時候真的很開心。
但當我把測試從單一步驟擴展到多步驟流程之後,問題全部浮出來
「錯誤的成功」是什麼意思?
我去看執行紀錄才發現:它沒有在購物車頁按 T-Shirt 的「Remove」,而是去側邊選單按了「Reset App State」(把整個網站狀態重置),購物車全部清空,再自己回商品頁把 Onesie 和 Backpack 重新加回去。
所以它卻繞過了我指定寫好的測試步驟
如果它走的根本不是我預期走的步驟,那這個 PASS 是真的 PASS 嗎?
| 傳統自動化 | browser-use | |
|---|---|---|
| 產品真的壞了 | 🔴 紅燈 | 可能還是綠燈(它繞過去了) |
| 腳本過期了 | 🔴 紅燈 | 綠燈(它自己修好了) |
| 元素改名了 | 🔴 紅燈 | 綠燈(這個是真的加分) |
| 你能不能相信這個綠燈 | 能 | 不確定 |
自動化測試的價值不在於「會過」,在於「它說過的時候你敢相信」。
Browser-use 遇到阻礙會自己想辦法繞過,每次路徑都可能不一樣。
但自動化測試要的剛好相反:路徑固定、遇到問題就停下來告訴我哪裡壞了。
自動化測試本質上是一種需要高度控制權的工作。
而 Browser-use 的整個設計哲學,就是把控制權交出去給 AI Agent 換取彈性。
我認為目前最大的瓶頸是:
「預期正確」這件事,對 AI 來說仍然非常困難。
它可以判斷「這個畫面看起來像成功了」,但它沒辦法判斷「這是不是你要的那種成功」。
昨天講的 Tools 自訂動作,其實就是在做這件事:把不該讓 AI 判斷的步驟收回來自己寫死。
tools = Tools()

@tools.action(description="用測試帳號登入")
async def login_with_test_account(browser_session: BrowserSession):
    # 這裡完全不給 AI 判斷空間
    ...
你寫死的步驟越多,執行就越穩定、越可重複。
但有沒有發現...一個奇怪的地方...
但寫死的 Tools 越多,就其實越接近傳統自動化概念,那我當初為什麼要用 browser-use?XD
(因為我原本是想要只要寫測試案例後就直接高歌離席呢XDDD)
這就是這條路真正的天花板:
可控性跟彈性,你只能選一個。
而你為了拿回可控性所寫的每一行程式,都在抵銷它「不用寫程式」的優勢。
剛開始用的時候,我以為它最大的優點是「維護成本低」。
維護成本沒有消失,它只是換了個形式。
以前花時間修 selector,現在你花時間看 AI 執行紀錄,確認 AI 這次到底走了哪條路
然後一次的生產的 Log 歷程非常多,看個三五次沒問題,但如果每天都要大量查閱 Log 時,甚至不是看 Error 而是在看 AI 歷程,這長期下來的資訊就會漸漸疲乏
(僅示意,這已經算是簡單化 Log 量了)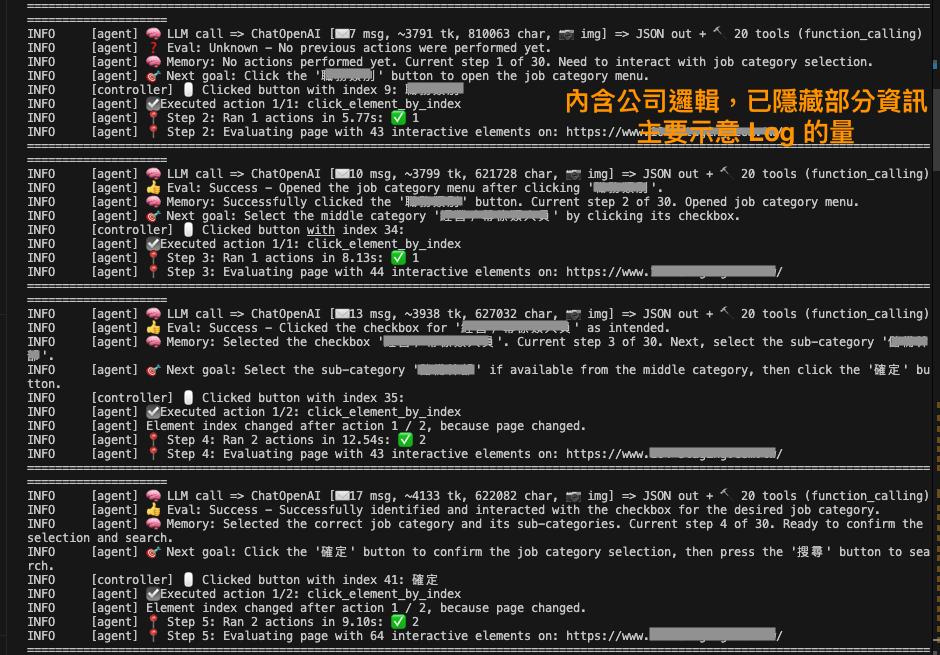
當然能用!但取決於團隊想要的測試目標以及能接受的維護成本
但這樣做的技術成本其實就不低了。
你等於要自己補一層框架,去約束一個天生不想被約束的東西。
到那個時候,值得問自己一句:我到底是在用工具,還是在跟工具搏鬥?
工具沒有好壞,只有適不適合你要解決的問題。
我覺得這其實才是選型最重要的一件事,但也是最容易被跳過的一件事,因為大家看到新工具,第一個問的都是「它能不能跑」,而不是「我到底要它幫我解決什麼」。
明天換一條路:Chrome DevTools MCP。


 iThome鐵人賽
 看影片追技術