
前面我們已經調整過 Epoch、Batch Size、Learning Rate 和 Optimizer,但還有一個問題:
如果 Training Data 的數量有限,模型能不能從原本的圖片中看到更多不同的變化?
今天要介紹的就是 Data Augmentation(資料增強)。
Data Augmentation 是在訓練過程中,對原本的圖片進行一些隨機變化,例如旋轉、翻轉、縮放、平移等產生不同的影像變化,雖然圖片看起來有所不同,但仍然是同一個病灶類別,這麼做的原因是為了讓模型在不同 Epoch 中,有機會看到同一張圖片的不同變化。
如果模型一直看到完全相同的 Training Data,可能會逐漸太熟悉這些圖片的細節,產生前面介紹過的 Overfitting,而 Data Augmentation 則可以增加訓練圖片呈現方式的多樣性,利用原本的 Training Data 產生不同的影像變化,希望模型不要只記住固定的位置或方向,而是學習更具有泛化能力的特徵。
影像分類常見的方式包括:
| 方法 | 作用 |
|---|---|
| Rotation | 將圖片旋轉一定角度 |
| Flip | 將圖片水平或垂直翻轉 |
| Zoom | 將圖片隨機放大或縮小 |
| Translation | 將圖片稍微往不同方向移動 |
TensorFlow 也提供了可以直接使用的 Layer。
這裡要特別注意,Data Augmentation 並不是圖片變化越多越好。
尤其我們現在處理的是醫學影像,如果圖片被改得太誇張,就可能產生不合理的影像。
例如,旋轉角度太大、過度裁切、過度縮放、顏色改變太明顯等等
都有可能讓影像和原始資料差異過大,甚至改變原本重要的病灶特徵。
因此使用 Data Augmentation 時,要考慮:
這種影像變化在目前的資料與任務中是否合理?
以目前的皮膚病灶影像實驗來說,我們先使用比較保守的 Rotation、Horizontal Flip 和 Zoom,再觀察模型結果。
這次我們建立兩個模型:
CNN without Augmentation vs. CNN with Augmentation
其他設定盡量保持一致,觀察加入 Data Augmentation 後是否真的有差異。
先建立 Data Augmentation:
data_augmentation = tf.keras.Sequential([

    # 隨機水平翻轉
    tf.keras.layers.RandomFlip("horizontal"),

    # 隨機旋轉
    tf.keras.layers.RandomRotation(0.1),

    # 隨機縮放
    tf.keras.layers.RandomZoom(0.1)
])
將 Data Augmentation 放在模型前面:
def create_aug_model():

    model = tf.keras.Sequential([

        # 輸入圖片
        tf.keras.layers.Input(shape=(64, 64, 3)),

        # Data Augmentation
        data_augmentation,
        tf.keras.layers.Conv2D(32,kernel_size=(3, 3),activation="relu",padding="same"),
        tf.keras.layers.MaxPooling2D((2, 2)),
        tf.keras.layers.Conv2D(64,kernel_size=(3, 3),activation="relu",padding="same"),
        tf.keras.layers.MaxPooling2D((2, 2)),
        tf.keras.layers.Flatten(),
        tf.keras.layers.Dense(128,activation="relu"),
        tf.keras.layers.Dense(7,activation="softmax")
    ])

                model.compile(optimizer=tf.keras.optimizers.Adam(learning_rate=0.001),loss="sparse_categorical_crossentropy",metrics=["accuracy"])

    return model
要注意的是,這些隨機變化主要會在 Training 時使用,Validation 和 Test 不需要跟著隨機改變。
在真正訓練之前,可以先看看同一張圖片經過 Augmentation 後會變成什麼樣子
從這邊可以看到同一張原始圖片產生多種不同的旋轉、翻轉與縮放結果
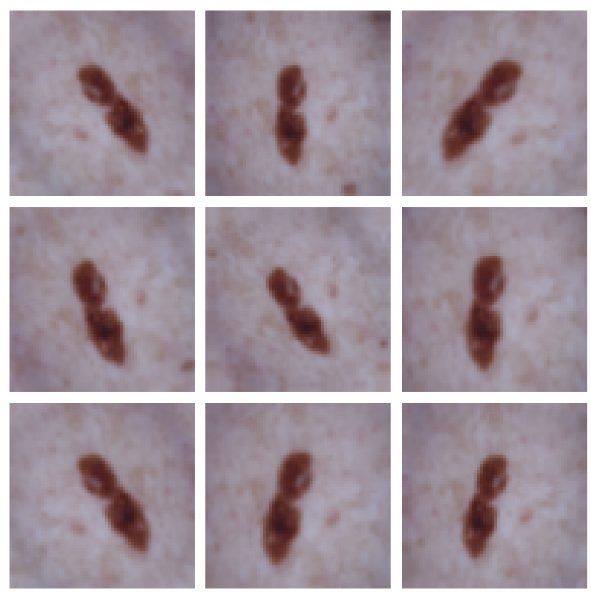
了解 Data Augmentation 的概念後,接下來直接用實驗看看它是否真的能改善模型表現。
這次我建立兩個相同架構的 CNN:
模型一:Without Data Augmentation 使用原始 Training Data 訓練
模型二:With Data Augmentation 加入 Rotation、Flip、Zoom
除了 Data Augmentation 之外,兩個模型都使用相同的 CNN 架構、Adam Optimizer、Learning Rate = 0.001、Batch Size = 32,以及相同的 Train、Validation、Test Data。
將兩個模型的 Validation Loss 畫在一起後,可以看到兩者的訓練過程有所不同。
沒有使用 Data Augmentation 的模型,Validation Loss 前期下降得比較快,在最低點後開始回升。
加入 Data Augmentation 後,前期下降速度比較慢,但後期的變化相對平穩。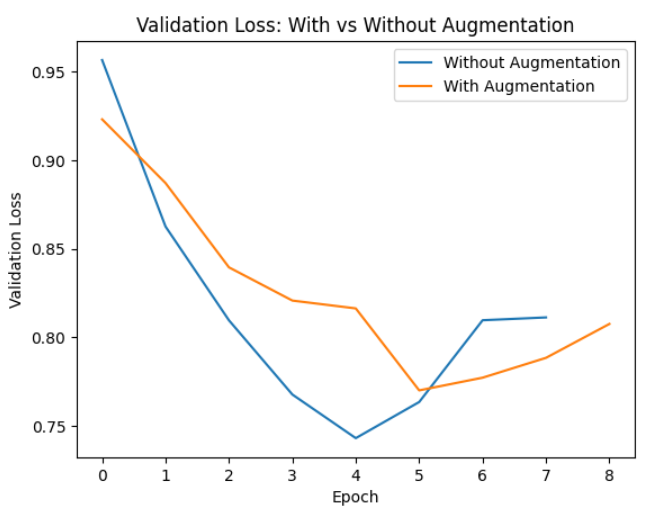
最後使用相同的 Test Data 評估兩個模型: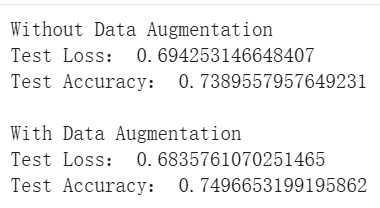
結果可以看到,加入 Data Augmentation 後,Test Accuracy 從 73.90% 提升到 74.97%,Test Loss 也從 0.6943 降低到 0.6836。
雖然提升幅度不大,但在這次實驗中,加入 Rotation、Flip 和 Zoom 後,模型在 Test Data 上的表現確實有小幅改善。
不過這不代表 Data Augmentation 一定會讓模型變好,實際效果仍然會受到資料、模型以及 Augmentation 方法的影響。
今天透過 Rotation、Zoom 和 Flip,讓同一張 Training Image 在訓練過程中產生不同的變化。
這次實驗中,加入 Data Augmentation 後,Test Accuracy 從 73.90% 提升到 74.97%,可以看到適當增加影像變化,確實有機會幫助模型提升泛化表現。
不過在醫學影像中,Augmentation 並不是變化越多越好,更重要的是:
影像的變化必須符合目前資料與任務的合理性。
下一篇,我們將從「改變資料」轉向「改變模型」,看看 Dropout 為什麼故意關掉一些 Neuron,反而可能減少 Overfitting。


 iThome鐵人賽
 看影片追技術