
前幾天我們一直使用 Loss 和 Accuracy 觀察模型表現。
例如 Day24 加入 Dropout 後,Test Accuracy 從 73.16% 提升到 74.03%。
但看到 74.03% 之後,我開始想到另一個問題:
剩下預測錯誤的圖片,到底錯在哪裡?
模型可能很會辨識某些類別,卻一直把另一種皮膚病灶認成其他類別。
因此今天要使用 Confusion Matrix(混淆矩陣),看看模型最容易把哪些皮膚病灶搞混。
Accuracy 告訴我們:
全部預測中,有多少比例預測正確?
但 HAM10000 並不是每個類別都有相同數量的圖片,因此即使整體 Accuracy 看起來不錯,也不代表每一個皮膚病灶類別都辨識得一樣好。
今天我們想進一步知道:
這時就需要 Confusion Matrix。
Confusion Matrix 會把 真實類別(Actual) 和 模型預測類別(Predicted) 放在一起比較。
假設只有三種類別:
| Actual \ Predicted | A | B | C |
|---|---|---|---|
| A | 80 | 10 | 10 |
| B | 5 | 90 | 5 |
| C | 15 | 10 | 75 |
對角線上的數字代表 模型預測正確,而不在對角線上的數字則代表 模型把這個類別認成其他類別,因此我們不只可以知道模型「錯了多少」,還可以知道 它到底錯成什麼?
在理解 Confusion Matrix 時,常常會看到:
以其中一個皮膚病灶類別為例:
在 HAM10000 這種多分類問題中,可以一次選擇其中一個類別,把它當成 Positive,再觀察其他類別。
這次不重新訓練模型,直接使用 Day24 加入 Dropout 後的模型:
y_prob = model_dropout.predict(X_test)y_pred = np.argmax(y_prob, axis=1)
模型最後會輸出 7 個類別的機率,因此使用 argmax() 找出機率最高的類別,作為最後的預測結果。
接著使用 Test Data 的正確答案 y_test,和剛剛得到的 y_pred 建立 Confusion Matrix。
from sklearn.metrics import confusion_matrix
cm = confusion_matrix(y_test,y_pred)print(cm)
這時就會得到一個 7 × 7 的矩陣,分別對應 HAM10000 的 7 種皮膚病灶類別。
只有數字不太容易觀察,因此可以把結果畫成圖:
from sklearn.metrics import ConfusionMatrixDisplay
import matplotlib.pyplot as plt

display = ConfusionMatrixDisplay(confusion_matrix=cm,display_labels=class_names)
display.plot(xticks_rotation=45,cmap="Blues")

plt.title("Confusion Matrix")
plt.show()
我們把 X 軸設成 Predicted Label、Y 軸是 Actual Label,對角線代表預測正確的圖片,其他位置則可以看出模型最容易把哪兩種類別搞混。
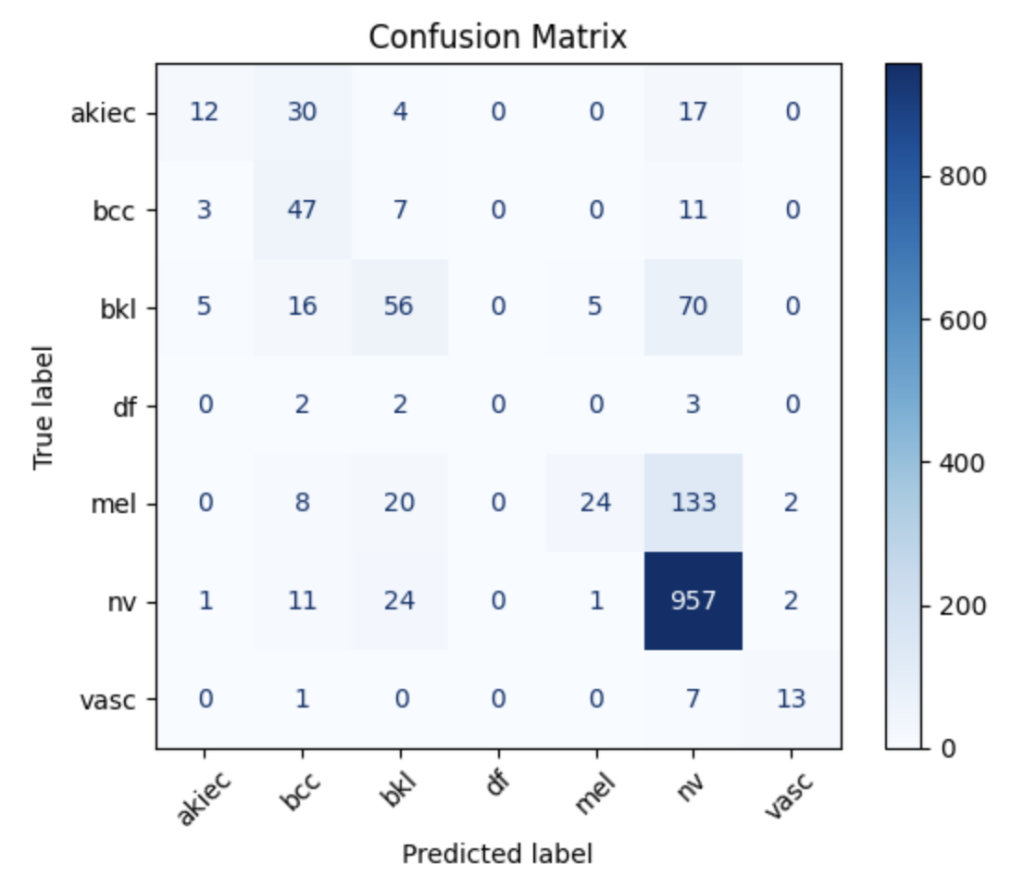
從 Confusion Matrix 可以看到,不同類別的辨識結果差異非常明顯,其中 nv 的辨識效果最好,在 996 張圖片中有 957 張預測正確,約為 96.1%。
相較之下,其他類別就沒有這麼理想,例如 mel 共有 187 張圖片,卻只有 24 張預測正確,其中更有 133 張被模型預測成 nv。
bkl 也有類似的情況,152 張圖片中有 56 張預測正確,但有 70 張被預測成 nv。
另外,df 的 7 張圖片中沒有任何一張被正確分類。不過由於 Test Data 中的 df 樣本只有 7 張,因此不能只根據這個結果就直接判斷模型完全無法辨識 df。
整體來看,可以發現模型有一個很明顯的現象許多預測錯誤的圖片,都被模型判斷成了 nv。
這也讓我想到我們前面提過的 Class Imbalance 問題,雖然模型整體 Test Accuracy 可以達到約 74%,但這並不代表模型對七種類別都有相同的辨識能力。
這次的 Confusion Matrix 也讓 Accuracy 的限制變得更明顯。
nv 在資料中本來就是數量最多的類別,而模型對 nv 的辨識結果也非常好,因此即使其他少數類別的辨識效果不理想,整體 Accuracy 仍然可以維持在一定程度。
如果只看到整體 Accuracy,就很難發現不同類別之間有這麼大的差異。
因此在 Class Imbalance 的多分類問題中,除了 Accuracy,也需要搭配 Confusion Matrix 等方式觀察每個類別的預測情況。


 iThome鐵人賽
 看影片追技術