
前面介紹 Overfitting 時,我們知道模型如果太熟悉 Training Data,可能會出現 Training 表現越來越好,但 Validation 表現沒有跟著改善,這代表模型可能逐漸記住 Training Data 的特徵,卻沒有辦法把學到的東西很好地應用到新的資料。
除了上一篇介紹的 Data Augmentation 之外,今天要從模型本身下手,介紹另一種常見的方法:Dropout
在介紹 Dropout 之前,先認識一個名詞:Regularization(正則化)
Regularization 的目的,是透過一些限制或方法,降低模型過度配合 Training Data 的情況,希望模型具有更好的 Generalization(泛化能力)。
簡單來說:
不是只讓模型把 Training Data 學得很好,而是希望它遇到沒看過的資料時也能有好的表現。
而 Dropout 就是一種常見的 Regularization 方法。
Dropout 的概念其實很特別:
在模型訓練時,隨機讓一部分 Neuron 暫時不參與這一次的計算。
假設原本某一層有:
● ● ● ● ● ●
加入 Dropout 後,某一次訓練可能變成:
● × ● ● × ●
下一次又可能是:
× ● ● × ● ●
其中 × 代表這一次暫時被 Dropout 的 Neuron,所以並不是永久刪掉這些 Neuron,而是在每次訓練時隨機讓部分 Neuron 暫時不參與。
如果模型一直依賴固定的 Neuron 組合來判斷 Training Data,就可能逐漸過度配合訓練資料,Dropout 會在訓練過程中隨機關閉部分 Neuron,使模型不能一直依賴完全相同的組合。
我們希望可以藉由這種方式,降低對特定 Neuron 的依賴,減少模型過度配合 Training Data,提升面對新資料時的泛化能力。
在 TensorFlow 中,可以這樣加入 Dropout:
tf.keras.layers.Dropout(0.5)
其中 0.5 = 訓練時隨機 Dropout 50% 的輸出
例如:
tf.keras.layers.Dropout(0.2)  # 20%
tf.keras.layers.Dropout(0.3)  # 30%
tf.keras.layers.Dropout(0.5)  # 50%
但 Dropout Rate 並不是越高越好。
如果關掉太多,模型能使用的資訊變少,也可能造成模型學習不足。
因此 Dropout Rate 也是需要調整的參數。
這次延續前面的 CNN,在 Dense Layer 後加入:
tf.keras.layers.Dropout(0.5)
觀察它是否會影響模型的 Overfitting 情況
這次建立兩個相同架構的 CNN:
除了 Dropout 之外,其他主要設定保持相同:
Adam
0.001
32
相同
這次主要想觀察:
加入 Dropout 後,是否能降低模型的 Overfitting,並改善模型在新資料上的表現?
這次除了 Validation Loss,也把 Training Loss 一起觀察。
如果模型出現 Overfitting,可能會看到 Training Loss 持續下降,Validation Loss 不再下降,甚至開始上升因此可以比較有無 Dropout 後,Training 和 Validation 之間的差距是否有所改變。
不過要注意:
加入 Dropout 並不保證 Validation Loss 或 Test Accuracy 一定會變好。
如果 Dropout Rate 太高,也可能讓模型學習不足,所以最後還是要透過實驗結果判斷。
最後使用相同的 Test Data,比較加入 Dropout 前後的模型表現: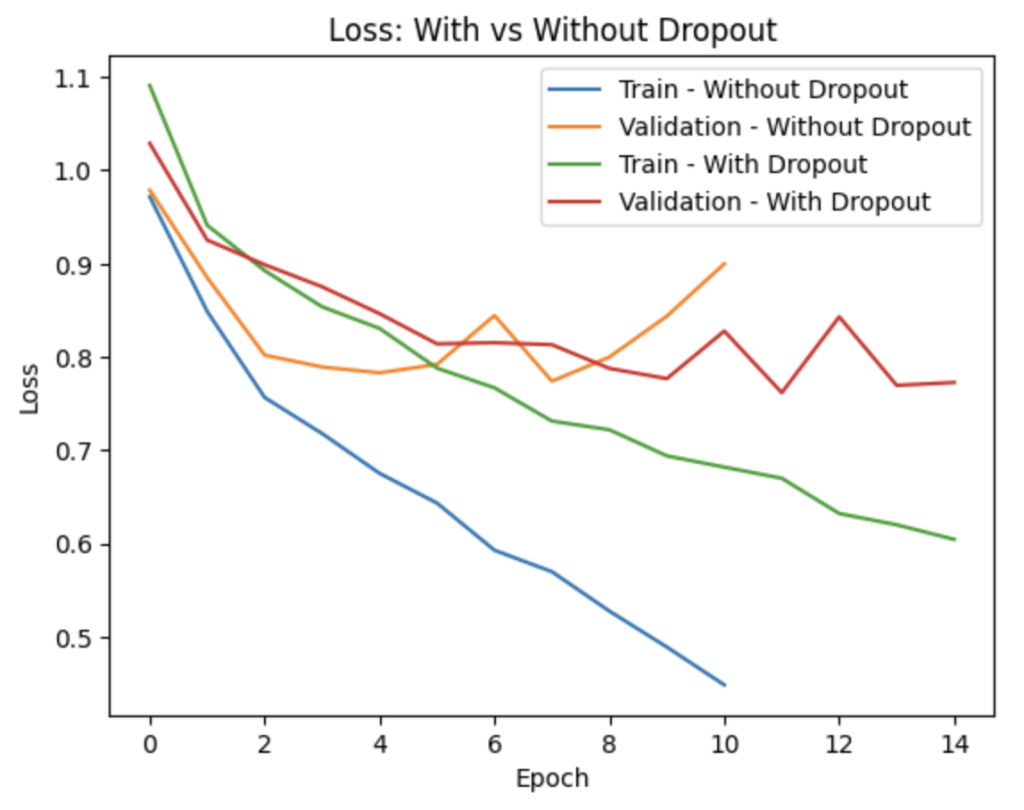
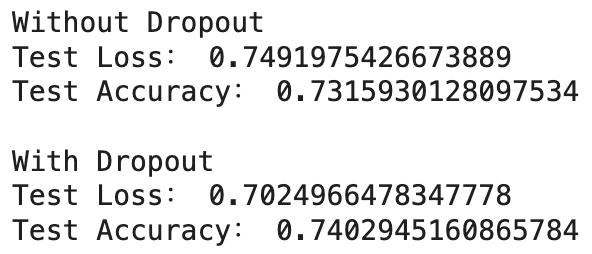
從結果可以看到,加入 Dropout 後,Test Loss 從 0.7492 降低到 0.7025,Test Accuracy 則從 73.16% 提升到 74.03%。
雖然 Accuracy 的提升幅度不大,但搭配前面的 Loss 曲線可以發現,沒有 Dropout 時,Training Loss 持續下降,但 Validation Loss 後期反而開始上升,顯示模型逐漸出現 Overfitting。
加入 Dropout 後,Training Loss 下降的比較慢,因為訓練過程中會隨機讓部分 Neuron 暫時不參與計算。不過在這次實驗中,加入 Dropout 的模型在 Test Data 上得到較低的 Loss 與較高的 Accuracy。
因此這次實驗可以看出,Dropout 雖然讓模型在 Training Data 上學得比較慢,但有助於降低過度配合 Training Data 的情況,並讓模型在未看過的資料上有較好的表現。
不過 Dropout 並不保證每次都能提升模型表現,實際效果仍會受到 Dropout Rate、模型架構與資料等因素影響。
今天介紹了另一種降低 Overfitting 的方法:Dropout。
它的做法看起來有點奇怪:訓練模型時故意隨機關掉部分 Neuron,避免模型過度依賴固定的 Neuron
不過 Dropout 不是越多越好,Rate 設得太高也可能讓模型無法充分學習。
所以和前面介紹的 Batch Size、Learning Rate 一樣,Dropout Rate 也需要根據實際模型與資料進行調整。
上一篇我們從「資料」的角度使用 Data Augmentation,今天則從「模型」的角度加入 Dropout,兩者的目的之一,都是希望模型不要只在 Training Data 上表現很好,而是能更好地面對沒有看過的新資料。


 iThome鐵人賽
 看影片追技術