
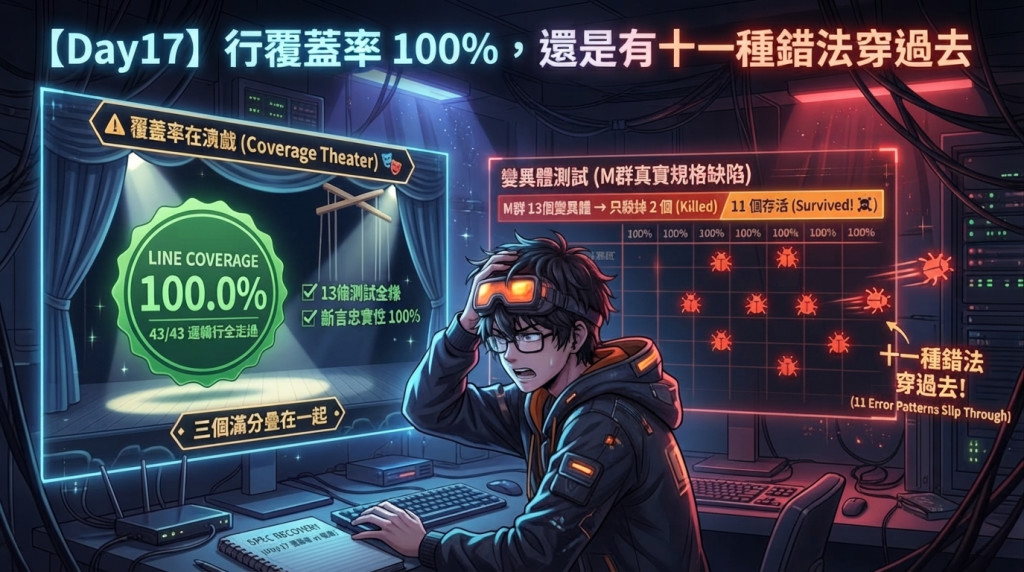
昨天用 assert_inspector.py 擋掉了真空斷言,tests/test_checklist.py 拿到忠實性 100%。加上它本來就 13 條全過,已經有兩個綠燈;今天補上第三個最常被拿來當證據的:行覆蓋率。
那個「AI 寫的測試有多強」的數字要算出來之前,得先說清楚它取代的是什麼。這是第二塊拼圖。
tools/coverage_probe.py 拿 tests/test_checklist.py 去跑 shadow/calc.py:
tests/test_checklist.py → shadow/calc.py
  測試 13 條全部執行成功
  邏輯敘述 43 行,走過 43 行 → 行覆蓋率 100.0%
  未覆蓋:無
把三天的量測放在一起:
| 量的是什麼 | 結果 |
|---|---|
| 測試通過率(Day 14) | 13 條全綠 |
| 斷言忠實性(Day 16) | 100%,十七條精確等式、零個真空斷言 |
| 行覆蓋率(今天) | 100%,43 行邏輯一行沒漏 |
| 變異體存活(Day 14) | 21 個存活 12 個;M 群 13 個只殺掉 2 個 |
M 群的每一個變異體都對應一條真實的規格決定或已知缺陷。三個滿分疊在一起,而十三種真實錯法裡有十一種改下去,測試不會叫。
昨天那條 INV-1 就是縮影:它有六條精確的 ==,覆蓋率把它走過的每一行都計了分,但它比的是兩份完全相同的輸入。行被執行過,邏輯沒有被檢驗過。
差 35 個百分點。程式碼沒變,測試沒變,是探針自己壞了。
要自己數覆蓋率,得先決定分母算哪些行。shadow/calc.py 用 @dataclass 定義 Params 與 Result,二十三行欄位宣告:那是型別描述不是邏輯,算進分母會稀釋「測試跑得多深」這件事,所以預設排除,--with-decl 可以切回含宣告的算法。
錯的是分子。sys.settrace 掛在 import 之後,而那二十三行在 import 當下就執行完了,永遠進不了分子。於是含宣告的模式報出 43 ÷ 66 = 65.2%:分母算了宣告,分子沒算。
把追蹤器移到 import 之前,兩種算法各自成立:排除宣告 43/43,含宣告 66/66,都是 100%。
所以 65.2% 從來不是「另一種比較嚴格的算法」,它就是個錯的數字。
變異測試(Mutation Testing):故意在受測程式碼注入語意缺陷,那份被改壞的副本叫變異體(mutant),觀察現有測試套件會不會報紅。報紅叫 killed,全綠放行叫 survived。
它問的問題跟覆蓋率反過來:不問測試走過多少行,問測試抓得出多少被故意改壞的地方。
理論基石有兩個(Jia & Harman, 2011):
>= 寫成 >、少乘一個 (1 + r/12)。變異分數的算法:
變異分數 = 殺掉的變異體 ÷ (變異體總數 − 等價變異體) × 100%
等價變異體(equivalent mutant)指語法改了、但在任何輸入下輸出都跟原始程式碼一樣的變異體。它理論上殺不死,所以要從分母剔除。而「哪些算等價」是人判斷的,不是工具算的:真的要報分數那天,這一格會是最難填的一格。
| 度量 | 行覆蓋率 | 變異分數 |
|---|---|---|
| 衡量什麼 | 程式碼是否被「執行過」 | 程式碼邏輯是否被「嚴格約束」 |
| 面對弱斷言 | 毫無知覺,執行即計入 | 敏銳暴露,弱斷言殺不死變異體 |
| 本質限制 | 無法反映斷言品質 | 滯後指標,受限於變異體設計的多樣性 |
變異分數是滯後指標,不是造題機。 它只對已經寫好的測試套件打分。如果變異目錄裡沒有某個維度的錯法,即使分數 100%,系統依然可能在那個維度崩潰。
回扣 Day 3:那四個缺陷是人工審查找到的,不是工具算出來的。方法論的價值不在於「AI 能自動找出人不知道的 bug」,而在於一旦人看出了某種錯法,能不能把它固化成變異體、量出測試防不防得住、確保同一個坑不再踩第二次。
所以那份變異體目錄不能隨手寫:每一個都要說清楚它模擬哪一種真實的金融錯法,並標明證據等級:實證的(有跨檔案行號)或推測的(設計出來的)。沒設計到的錯法,分數看不見。
kojenchieh 的《你的自動化測試,大部分是在演戲》系列 Day 5 把這個病命名為 Coverage Theater:覆蓋率很高,而一半以上的斷言空洞或毫無殺傷力。
兩個系列不是競爭,是上下游。他們把病命名了,解法停在「人來審」;本系列做的是給尺。 演戲系列回答「AI 時代人該做什麼」,本系列回答「人要怎麼客觀證明 AI 產出的東西有沒有效」。
探索性測試適合 UI 流程與行為路徑。但退休金試算的輸出是一個數字:缺陷 A' 讓圖表底線停在 0,背後真實餘額是 −862,034,人眼盯著那條漂亮的曲線看不出任何異狀。面對跨期複利,只有故障注入與嚴格斷言擊穿得了這種盲區。
65.2% 那一次,我差點就把它寫進文章了。
當下的解讀很自然:「覆蓋率只有六成五,果然跟預期一樣,AI 寫的測試沒有看起來那麼周全。」數字剛好落在會讓人點頭的位置:不夠高到可疑,不夠低到離譜,而且完全符合我事前的猜測。
而且那次的 65.2% 跟現在講的還不是同一個病。第一版探針有六條測試因為 fixture 沒接上根本沒執行,十三條只跑了七條。我是順手看了一眼「執行成功幾條」才發現的,當時工具沒有任何東西會攔我。把 fixture 修好、十三條全跑起來之後,數字還是 65.2%,那才輪到分母與分子不對稱這件事。同一個數字,兩種壞法。
所以現在的 coverage_probe.py 裡有一條 _assert_all_ran():任何一條測試沒跑起來就拒絕印出覆蓋率。那不是當時救我的東西,是那次之後補上去的。
Day 13 寫過一句規矩:結果跟猜的一樣,要問的是自己有沒有洩漏;不一樣,那才是資料。當時是拿來檢查 AI 的,今天輪到我自己。
這個數字不能拿來做什麼
100% 是 tests/test_checklist.py 對 shadow/calc.py 一組配對的結果,不是這個 repo 的整體覆蓋率,更不能推論「AI 寫的測試覆蓋率都很高」。
分母排除了二十三行 @dataclass 欄位宣告,那是本篇明講的選擇,不是業界標準。在這個案例上兩種算法都得到 100%(那二十三行 import 時全部執行),所以選擇不影響結論;但換一份有未使用宣告的檔案就會分岔。要跨專案比較覆蓋率,得先確認兩邊的分母是同一種算法。
M 群 13 個變異體是 Day 14 設計的,不是窮舉。「十三種錯法殺掉兩種」說的是這十三種,不是所有可能的錯法。
只帶走一件事
一套 AI 寫的測試可以同時拿下三個滿分,而十三種真實錯法只擋住兩種。
綠燈量得出來,抓不抓得到量不出來:得自己動手把程式碼改壞,它才會回答你。
明天要面對的問題更麻煩:量變異分數的那台引擎本身也是程式碼,誰來驗收驗收者?
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day17


 iThome鐵人賽
 看影片追技術