
昨天留了個問題沒回答:不同的 key 撞在同一格時會發生什麼事,又該怎麼處理?今天就來看看~
首先,再次看到熟悉的訂單資料~只是這次我們只給 4 格的 bucket 儲存空間:
const orders = {
  'A-1003': { amount: 180 },
  'A-1008': { amount: 500 },
  'A-1025': { amount: 90 },
  'A-1031': { amount: 510 },
  'A-1042': { amount: 240 },
};
上一篇用 8 格的時候,這 5 筆訂單剛好各自落在不同的位置,一格一筆,看起來一切都很順利:
bucket 0 :(空)      bucket 4 :(空)
bucket 1 :(空)      bucket 5 : A-1042
bucket 2 : A-1003     bucket 6 : A-1025
bucket 3 : A-1031     bucket 7 : A-1008
那如果今天記憶體不足,預算有限(?把格數砍成一半會怎樣呢?
把 5 筆訂單重新算一次,會落在哪就變成這樣了:
| 訂單 | 字元碼相加 | % 4 |
落在 |
|---|---|---|---|
A-1003 |
306 |
2 |
bucket 2 |
A-1008 |
311 |
3 |
bucket 3 |
A-1025 |
310 |
2 |
bucket 2 |
A-1031 |
307 |
3 |
bucket 3 |
A-1042 |
309 |
1 |
bucket 1 |
A-1003 和 A-1025 都指向第 2 格,A-1008 和 A-1031 都指向第 3 格,而這種「不同的 key 被算到同一格」的情況就叫做 collision(碰撞)。
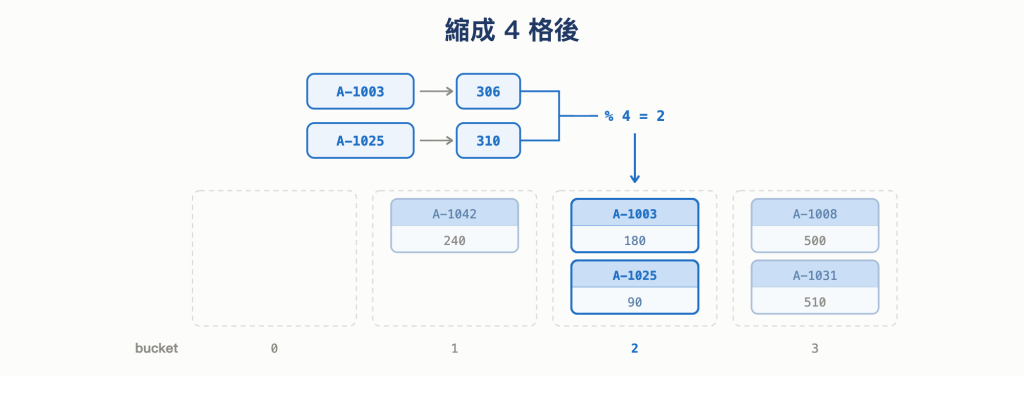
圖 1 表縮成 4 格後會產生的碰撞問題
這裡會碰撞有兩種不同的原因。第一種是 hash 值本身就相同,上一篇提過,那個把字元碼相加的做法只在乎用到哪些字元、不管順序,所以 A-1003 和 A-1030 算出來都是 306,連取餘數都還沒開始就已經一樣了。
第二種是 hash 值不同,但取餘數之後撞在一起。A-1003 是 306、A-1025 是 310,兩個數字差了 4,但除以 4 的餘數都是 2,上面那張表裡的四次碰撞全部屬於這一種。
區分這兩種原因是有意義的,因為它們對應的改善辦法不一樣。第一種只能從 hash function 下手,既然 A-1003 和 A-1030 在還沒取餘數之前就已經是同一個數字了,那麼表開多大都沒有用,把格數加到一百萬格,它們還是會一起落在第 306 格。要讓它們分開,只能換一個不會忽略順序的算法。
第二種則和表開多大直接相關,306 和 310 本來是兩個不同的數字,是除以 4 之後才被壓成同一個餘數;換成除以 8,它們就分開成第 2 格和第 6 格了。同樣這 5 筆訂單,開 8 格的時候一次都沒撞,開 4 格就撞了四次,差別只在分母。
那有沒有可能把表開得夠大,大到完全不撞呢?基本上不太有辦法,而且這件事可以講得更精確一點,上一篇提到 hash function 的定義是「把一個較寬的定義域映射到較窄的值域」,輸入可以是任意長度的字串、數量沒有上限,輸出卻被限制在固定的格數之內,而定義域比值域寬,就一定會有兩個不同的輸入對到同一個輸出,這是函數本身的性質,和實作寫得好不好無關。
而這正是 [Day04] Pure Function 是什麼? 那條規則的另一半。當時說數學上函數的定義是「一個輸入只能對應到一個輸出,但不同的輸入可以對應到同一個輸出」,前半句就是上一篇說的 key 不能重複,後半句正是今天在談的碰撞。因此碰撞從來就不是函數壞掉,它是函數定義裡本來就允許的那一半。
既然一定會碰撞,那碰撞之後要怎麼辦呢?常見的處理方式有兩大類:
今天會專注介紹 Separate Chaining,Open addressing 這篇不會展開,有興趣的可參考 Rust Algorithm Club:HashMap,裡面有更多說明~
Separate chaining 的想法很單純:既然一格可能要放不只一筆資料,那就別讓 bucket 直接存一組 key-value,改成讓它存一個陣列,撞進來的資料就往那個陣列裡放。
bucket 2
  ↓
[
  ['A-1003', { amount: 180 }],
  ['A-1025', { amount: 90  }]
]
看到 bucket 要存陣列,可能會覺得眼熟,因為上一篇寫的 SimpleHashTable 就已經是這樣了:
set(key, value) {
  const bucket = this.buckets[this.hash(key)];
  const pair = bucket.find(([k]) => k === key);
  if (pair) {
    pair[1] = value;
  } else {
    bucket.push([key, value]);   // 撞進來的就接在後面
  }
}
當時把 bucket 實作為陣列、又把 key 和 value 整組存進去,理由是「hash 只保證同樣的 key 會落到同一格,並沒有保證不同的 key 一定落到不同格」。那句話講的就是現在這個情況。只是上一篇的 5 筆訂單剛好都沒撞到,每個陣列裡都只有一筆,所以看不出來這段程式碼其實一直在為碰撞做準備。
那個「陣列」其實也不是唯一的選擇,bucket 裡要放什麼,常見的有兩種:
今天這篇主要會用陣列來說明,Linked List 這資料結構之後會介紹。
資料放得進去之後,接著來看如何存取,假設現在要查 A-1025,步驟如下:
hash('A-1025') 算出 310
310 % 4 得到 2,跳到 bucket 2A-1003,不是要找的A-1025,回傳它的 value前兩步和上一篇一模一樣,變化發生在第 3 步之後:原本一步就能拿到的東西,現在要在格子裡逐一比對。而這也解釋了為什麼 bucket 裡非得存 key 不可。假設當初只存了 value,那走到第 4 步的時候,程式看到的會是 [{ amount: 180 }, { amount: 90 }] 這樣兩筆金額,沒辦法判斷哪一筆屬於 A-1025。key 存在裡面,才有東西可以拿來比對。
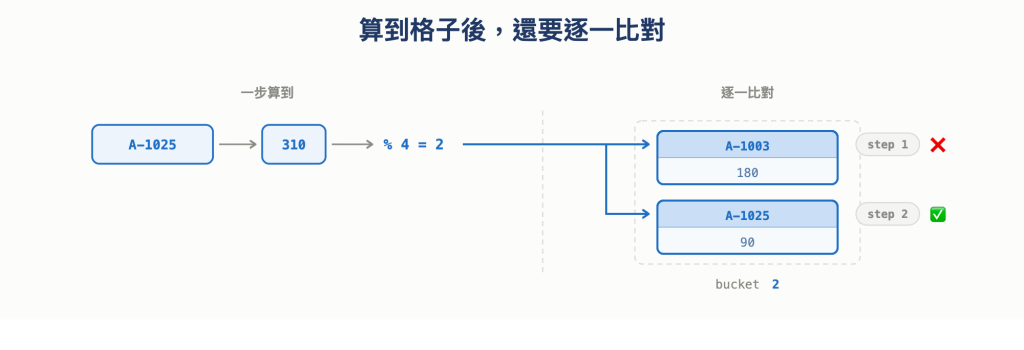
圖 2 hash 只帶我們到那一格,格子裡有幾筆就得比幾次
既然要逐一比對,成本就和「那一格裡有幾筆」有關。最好的情況是每一格都只有一筆或空著,那算完 hash 跳過去、比對一次就結束了,步數不會隨著資料變多而增加,這就是上一篇說的平均 O(1)。
最壞的情況則是所有資料都擠在同一格,這時候 hash function 算了也沒有用,因為不管查哪一個 key 都會被帶到同一個地方,接著要在一個裝了 N 筆資料的陣列裡逐一比對,成本是 O(N),和沒有 hash table、直接拿一個陣列從頭找到尾是一樣的。
| 情況 | 每一格的樣子 | 查找成本 |
|---|---|---|
| 撞得少,分布平均 | 多數格子只有一兩筆 | 平均 O(1) |
| 全部撞在同一格 | 一格裝了 N 筆 |
最壞 O(N) |
中間地帶也可以試算看看,如果 N 筆資料平均分配到 k 個格子,每一格大約有 N / k 筆,查找成本就是 O(N/k)。所以只要 k 跟著 N 一起長大、讓 N / k 維持在某個小的常數,複雜度就會退回 O(1);反過來如果 k 固定不動、資料一直加,N / k 就會一路長大,最後和 O(N) 沒有分別。
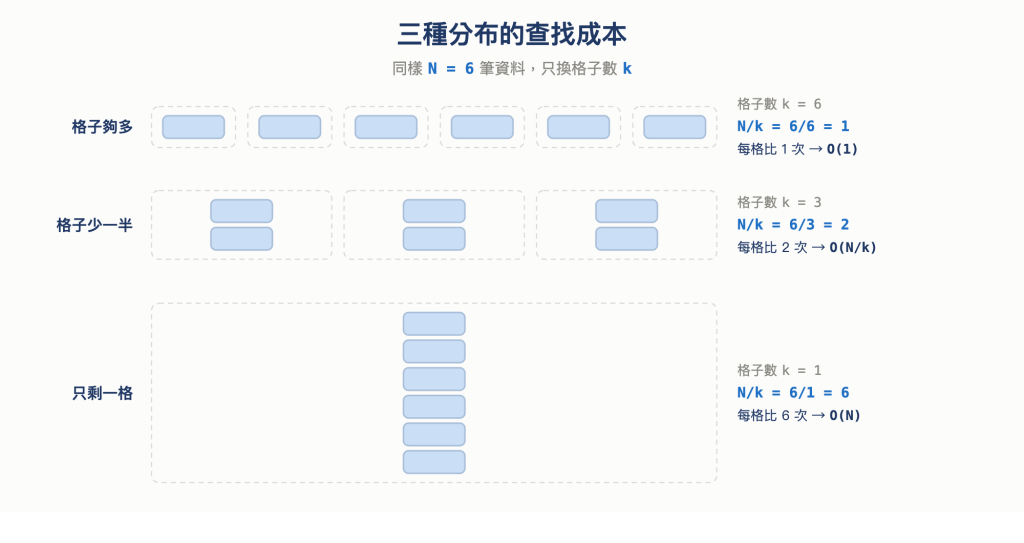
圖 3 三種分布的查找成本
因此真正決定效率的是碰撞有沒有被控制住,而不是有沒有碰撞。而控制它的辦法有兩個,一個是控管表的大小,一個是挑選 hash function 的品質。
在控管表的大小之前,先看我們怎麼判斷一張表的大小是否適當。要判斷一張表空間是否足夠,最直接的指標是資料筆數和格數的比例,這個比例叫做 load factor(負載因子):
Load Factor(負載因子)是儲存的資料筆數除以 bucket 的數量,用來衡量一張表被填得多滿。
以我們的例子來說,5 筆訂單放進 4 格,load factor 是 5 / 4 = 1.25,意思是平均每一格要裝 1.25 筆。上一篇用 8 格的時候則是 5 / 8 = 0.63,平均每格連一筆都不到。
那 load factor 要多少才算適當呢?電腦科學家的經驗法則是每 7 筆資料配 10 格,也就是 load factor 大約 0.7。這個數字是在兩件事之間取平衡:格子/空間開得多,碰撞就少,但沒用到的格子也是在佔用記憶體;格子開得少省空間,可是每一格會越來越擠,查找就慢下來。不過這個門檻並沒有唯一答案,實務上 0.7 到 0.75 之間都很常見,實作上還是可以依自己的取捨而定。
| 做法 | 好處 | 代價 |
|---|---|---|
| 格子開多一點 | 碰撞變少 | 記憶體用得多 |
| 格子開少一點 | 省記憶體 | 碰撞變多,查找變慢 |
答案是換一張更大的表,這動作叫 resize,而在 resize 的過程中,舊表裡的每一筆資料都必須重新算一次位置。
原因回到 hash function 的最後一步,hash 的結尾是 total % this.buckets.length,取餘數的分母就是格數,格數一改,同一個 key 算出來的位置也會跟著改。A-1025 的字元碼相加是 310,在 4 格的表裡 310 % 4 是第 2 格,在 8 格的表裡 310 % 8 就變成第 6 格了。
這個把所有 key 重新分配一次的過程叫做 rehash,它也有自己的成本,表裡有幾筆就要重算幾次,於是觸發到 resize 的那一次 set 是 O(N)。
這件事 Day 05 其實已經遇過一次了,dynamic array 在空間不足時也是去找一塊大得多的、把舊資料整批搬過去,代價同樣落在那一次操作上。兩者唯一的差別是搬過去之後要做什麼:陣列只要照原順序複製,位置不會變;Hash Table 則因為分母換了,每一筆都得重新算一次位置才知道該放哪。
把 load factor 和 resize 加進上一篇那個 class 的程式,大概長這樣:
class HashTable {
  constructor(size = 4) {
    this.buckets = Array.from({ length: size }, () => []);
    this.count = 0; // 目前存了幾筆
  }

  hash(key, bucketCount = this.buckets.length) {
    let total = 0;
    for (const char of key) {
      total += char.charCodeAt(0);
    }
    return total % bucketCount; // 分母改成可以指定的,resize 時會用到
  }

  set(key, value) {
    const bucket = this.buckets[this.hash(key)];
    const pair = bucket.find(([k]) => k === key);
    if (pair) {
      pair[1] = value;
      return; // 覆蓋舊值,筆數沒有增加
    }

    bucket.push([key, value]);
    this.count++;
    if (this.count / this.buckets.length > 0.7) {
      this.resize();
    }
  }

  resize() {
    const bigger = Array.from({ length: this.buckets.length * 2 }, () => []);
    for (const bucket of this.buckets) {
      for (const [k, v] of bucket) {
        bigger[this.hash(k, bigger.length)].push([k, v]); // 每一筆都重新算
      }
    }
    this.buckets = bigger;
  }

  get(key) {
    for (const [k, v] of this.buckets[this.hash(key)]) {
      if (k === key) return v;
    }
    return undefined;
  }
}
有了這段之後,把 5 筆訂單依序存進一張 4 格的表,過程會是這樣:
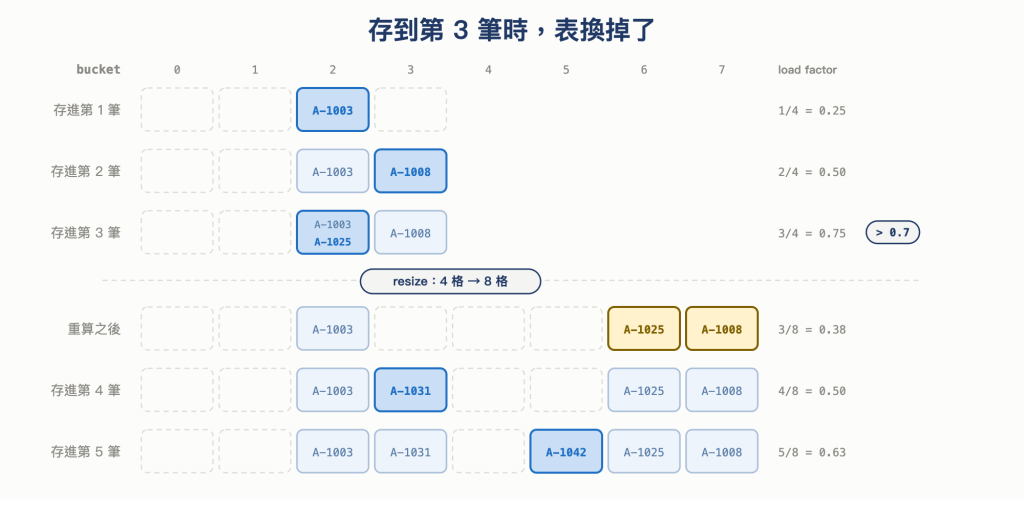
圖 4 存到第 3 筆時,表換掉了
第 3 筆存進去的瞬間,load factor 會來到 3 / 4 = 0.75,超過了 0.7,於是表被換成 8 格,三筆資料重新分配。A-1008 從第 3 格搬到第 7 格、A-1025 從第 2 格搬到第 6 格,而 A-1003 算出來還是第 2 格、留在原地,每一筆都要重算,但不是每一筆都會搬家。
同樣是 8 格的表、同樣 5 筆資料,如果 hash function 把它們通通算到同一格,load factor 再低也沒有意義。因此除了「別太擠」,實務上還會要求 hash function 盡量把 key 打散到不同的格子,這個性質稱為 distribution。
那我們自己寫的那個 hash function 表現如何呢?samwho 在 Hashing 這篇文章裡實際測過一個叫做 stringSum 的 hash function,它的寫法是這樣的:
function hash(input) {
  let hash = 0;
  for (let c of input) {
    hash += c.charCodeAt(0);
  }
  return hash % 1000000;
}
這正是我們上一篇寫的那個 hash function,字元碼相加再取餘數,只差在分母不同。而他拿它和一個叫 murmur3 的 hash function 對照,結果是這樣(以下數字取自該文章):
| 測試資料 | murmur3 的碰撞 | stringSum 的碰撞 |
|---|---|---|
| 一億個隨機 IP | 1,156,959(1.157%) | 99,999,566(99.999%) |
| 466,550 個英文單字 | 25(0.005%) | 464,220(99.5%) |
stringSum 中,46 萬個英文單字,撞了 46 萬次。
為什麼會差這麼多呢?可以用一個叫做 avalanche effect(雪崩效應)的性質來解釋:一個好的 hash function,輸入只要改動一個 bit,輸出應該有大約一半的 bit 跟著改變。而 stringSum 只要改一個字元,輸出通常也只變動一點點,因為它做的事情就只是相加而已,改動一個字元就只是讓總和加減一個小數字。(avalanche effect 詳細介紹可參考 https://en.wikipedia.org/wiki/Avalanche_effect)
所以我們寫的那個簡易 hash 版本能用來理解原理,但不能拿去用。各語言內建的 hash function 都經過這類測試,不會有人用字元碼相加當正式實作。
補充:最壞情況也可能是「被攻擊出來的」
前面說最壞情況是所有資料擠在同一格、退回
O(N),聽起來像是運氣不好才會遇到。但如果 hash function 像stringSum那樣可以被預測,這就有可能被拿來攻擊,進而產生資安問題。既然字元碼相加不管順序,攻擊者就能輕易生出成千上萬個保證撞在同一格的 key,而當這些 key 是從外部進來的(例如把 HTTP 參數、JSON 的欄位名直接拿去當 key),每一次存取都退化成
O(N),處理N筆就是O(N²),伺服器的處理能力就可能被耗盡。這種攻擊叫做 HashDoS。(詳細可參考 https://en.wikipedia.org/wiki/Collision_attack)防禦方式也很好想到,既然問題出在「hash 結果可以被預測」,那就讓它不可預測。實務上的 hash function 會在每次程式啟動時混入一個隨機種子,攻擊者不知道種子,就算不出哪些 key 會撞在一起。Node.js/V8、Python、Rust 等都是這樣處理的。而這也讓前面那句「不能拿去用」多了一層理由:除了分布不夠均勻,還有安全性的考量。
剛好就在今年(2026 年 3 月),Node.js 才修掉一個編號 CVE-2026-21717 的 HashDoS 漏洞,影響 20、22、24、25 全部主流版本,詳細資訊可參考這篇文章~
Hash Table 適合什麼場合呢?答案在它快的那個方向上,也就是已知 key、要拿 value 的等值查找,這在實務上有兩種類型。
第一種是資料本身就帶著配對關係,例如訂單資料,用編號配到訂單內容,其他像商品配到庫存數量、單字配到定義也屬於這類。這種情況下 key 和 value 要放什麼幾乎不用選,資料長什麼樣就照著放。
第二種情況則是,資料原本沒有任何配對關係,但我們還是能自己建一張表出來,拿它來換查找速度。假設手上有一份今天已出貨的訂單編號清單,而我們要反覆確認某筆訂單在不在裡面:
const shipped = ['A-1003', 'A-1008', 'A-1025', 'A-1031', 'A-1042'];

shipped.includes('A-1025'); // 每問一次就從頭找一次
includes 走的就是 Day 06 那個 Linear Search,問一次是一次 O(N),但如果先把每個編號當成 key 建一張表,情況就不一樣了:
const shippedIndex = {};
for (const id of shipped) {
  shippedIndex[id] = true;
}

Boolean(shippedIndex['A-1025']); // 平均 O(1)
這裡的 true 沒有任何意義,它只是用來表示「這個 key 存在」,換成 1 或別的東西結果都一樣,真正在做事的是 key。也就是說,我們把原本要被逐一比對的資料整批搬到 key 的位置上,讓「在不在裡面」這個問題變成一次定位。JavaScript 的 Set 就是把這個做法包好的版本,底層一樣是 hash table,只是連 value 都不必自己填。
代價則是建表時得把清單走訪一次,只查一次反而多做了工,這個做法真正適合的是要反覆查同一組資料的時候,用一次走訪換掉後面每一次的線性搜尋。
這兩種樣貌一個是資料原本就配好對、一個是我們自己配出來的,但快的都是同一件事:拿一個 key 去換它對應的東西。而這個速度是有交換條件的,資料被 hash 打散之後就不再維持任何順序,因此只要問題需要順序才答得出來,Hash Table 就無法幫忙了。
最後稍微連結一下實際應用~PostgreSQL 建索引時會讓你選擇型別,型別類型很多,其中官方文件對 B-Tree 和 Hash 這兩種索引的描述是:
Hash indexes ⋯ can only handle simple equality comparisons.
B-trees can handle equality and range queries ⋯ B-tree indexes can also be used to retrieve data in sorted order.
也就是說,選了 hash 索引,WHERE id = 'A-1003' 很快,但 WHERE id BETWEEN 1010 AND 1030 或 ORDER BY id 則完全用不上它;選 B-tree 則兩種都能做。這正是不同資料型態/結構帶來特性的實際案例,也由此看出,資料結構加速的永遠是針對某一種特定的操作方法。
小小總結一下今天對 Hash Table 的認識~
最後補充幾點~
O(1) 的前提是每一格都只有少少幾筆,全部擠在同一格的時候會退回 O(N)。O(N),這就是 HashDoS。圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術