
今天要介紹的是 Linked List~
假設我們有一份播放清單,5 首歌照著順序排好,播完一首就自動接下一首:
晨光 → 迴聲 → 光暈 → 漂流 → 餘燼
現在聽到〈迴聲〉的時候,突然很想把另一首歌插在它後面、等一下馬上播。如果這份清單是用 Array 存的,這個動作會有點麻煩,因為〈光暈〉以後的每一首歌都得往後挪一格,位置才空得出來。清單只有 5 首的時候感覺還好,但如果是一份 5000 首的清單,而插播又是很常做的事呢?
Array 的元素依靠 index 維持順序,中間插入新資料時,後面的元素往往必須一起移動。那有沒有另一種存法,可以保留資料的順序,卻不要求元素待在相鄰的位置呢?
在那之前,先問個問題:一份 Array 裡的「順序」,到底存在哪裡?
Day 05 有提到,記憶體本身就是一個超級大的 Array,只是它的 index 我們改叫 address,而我們宣告的陣列,是從這個大 Array 裡切出來的一小段。也因為切出來的是連續的一段,電腦真正記住的位址只有 base 這一個,其他每一格在哪裡,都是要用的時候用 base + index × elementSize 當場算出來的。
那順序呢?在 Array 裡,其實找不到任何一個地方寫著「這一格的下一格是誰」,順序這件事沒有被存下來,它藏在位置裡,〈光暈〉之所以排在〈迴聲〉後面,只是因為它剛好住在隔壁那一格而已。
既然順序是靠位置表達的,那位置一亂,順序就跟著亂,這就是為什麼插播一首歌得把後面的人全部往後推。
那有偷懶的做法嗎?例如在清單中間留一個洞,把新歌直接塞進去就好?不太行,Array 不能有洞,中間一旦空一格,後面那些元素該有的 index 就全部對不上了。只要還想用位置來表達順序,搬移就無法避免。
那如果我們不想搬動任何人,到底該怎麼辦?
我們可以把順序存下來。
next這個把順序存下來的資料結構,就是今天要介紹的 Linked List(連結串列),先給一句話的定義:
Linked List 是一串各自獨立的節點 (Node),每個節點存著自己的值,以及下一個節點在哪裡。
也就是說,順序不再由位置決定,而是由每個 node 手上那句「下一個是誰」決定。這有點像在每首歌旁邊貼一張小紙條,寫著接下來要播哪一首,而 Linked List 要做的,就是維持這些小紙條的正確性,之後不管是加歌、插歌還是刪歌,動到的都是紙條而不是歌本身。
有了小紙條之後,資料放在哪就不重要了,〈迴聲〉可以躺在記憶體的某個角落,〈光暈〉在很遠的另一個角落,只要〈迴聲〉手上那張紙條寫著〈光暈〉在哪裡,順序就完整保留下來。
一個 node 只需要裝兩樣東西,一個是資料本身,另一個是下一個 node 在哪裡,後者一般就叫做 next。寫成 JavaScript 就是一個只有兩個欄位的物件,而所謂的串起來,就是把其中一個物件寫進另一個的 next:
const first = { value: '晨光', next: null };
const second = { value: '迴聲', next: null };

first.next = second;
把這件事放回 Day 05 的記憶體模型會更清楚。同樣幾筆資料,用 Array 存和用 Linked List 存,在記憶體裡長得不一樣:
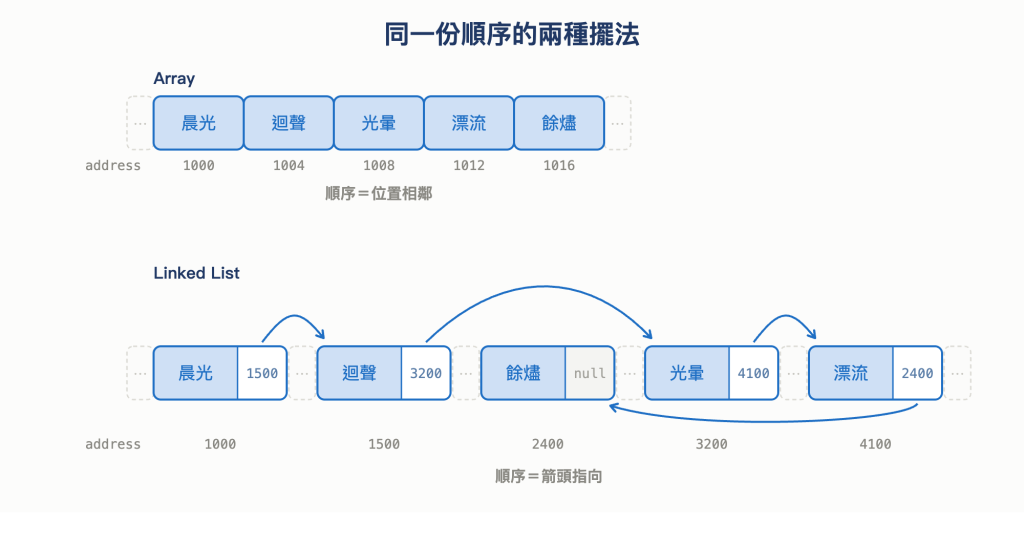
圖 1 同一份順序的兩種擺法
Array 之所以能直接跳到任何一格,是因為電腦只記得 base 這一個位址,其他全部是用算的。Linked List 的做法相反,它不計算,而是讓每一個 node 各自記住一個位址,代價是這些位址彼此之間沒有規律可循,我們沒辦法從 1000 推出第 3 個 node 在 3200,只能從頭一個一個跟著走過去。
那最後一首歌怎麼辦?〈餘燼〉後面沒有東西了,它的 next 就設成 null,這同時也是整條串列的終點記號。而第一個 node 習慣稱為 head、最後一個稱為 tail,整條串起來就是這樣:
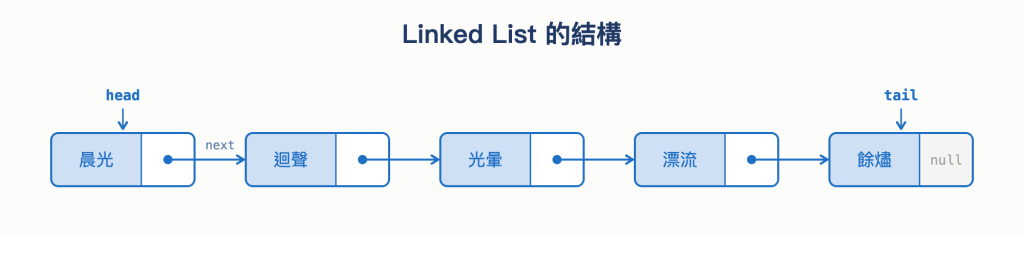
圖 2 Linked List 的結構
next 裡面存了什麼我們要在資料裡多存一張小紙條,那這張紙條上寫的到底是什麼呢?
Day 05 提過 pointer(指標)這個詞,它是一種「內容是一個記憶體位址」的資料,記的是值在哪裡,而不是值本身。next 做的正是同一件事,只是在 JavaScript 裡,我們拿到的不是位址那個數字,而是一個語言層級的參照。
const a = { value: '晨光', next: null };
const b = a;

b.value = '破曉';
console.log(a.value); // '破曉'
b 並沒有複製一份新的物件出來,它和 a 握著的是同一個東西,所以改一邊,另一邊也跟著變。node 之間的連結靠的就是這個性質,node1.next = node2 之後,node1.next 和 node2 指的是同一個 node,而不是兩份長得一樣的資料。
不過 JavaScript 的參照和 C 的 pointer 還是有些差別。C 的 pointer 是一個位址數字,既然是數字就可以拿來做算術;JavaScript 則拿不到那個數字,也不能對它加減,能做的只有 node = node.next,順著紙條走過去。因此更精確的說法是,在 JavaScript 裡 next 存的是另一個 Node 物件而不是位址數字,但兩者的作用相同,都能讓程式從這裡走到下一個。至於只能一個一個往下走這件事,並不是 JavaScript 少給了什麼,用 C 寫的 linked list 一樣要這樣走,因為整條串列裡沒有任何地方記著「第 3 個 node 在哪裡」,沒有東西可以拿來算。
另外,只要還有紙條指著某個 node,它就會一直留在記憶體裡;等到沒有任何東西指向它,JavaScript 的垃圾回收 (garbage collection) 才會把那塊空間收走。
補充:C++ 裡的 node 長什麼樣
C++ 會把 node 寫成一個 struct,型別上直接寫出「這是一個指向 Node 的 pointer」:
struct Node {
    int value;
    Node* next;
};
*表示next是一個 pointer,要走到下一個 node 得寫成node->next。表示法和 JavaScript 不太一樣,但做的事情相同,從手上這個 node 找到下一個。
一整條 Linked List 還需要一個入口,不然程式連第一首歌在哪都不知道,而這個入口就是 head,Linked List 這個結構本身,直接握著的也只有它。
這也是為什麼除了 Node 之外還要有一個 LinkedList。node 彼此串起來之後,資料的順序其實已經完整了,但總得有人記著「這條串列從哪裡開始」,而這件事不屬於任何一個 node,長度、尾端這類整體性的資訊也一樣沒有地方放,所以需要再有資料來保管這些入口資訊。
這也是 Linked List 和 Array 的差異之處。Array 任何一格都能直接跳過去,因為位置算得出來;Linked List 能直接碰到的只有 head 這一個 node,想去別的地方,都得從 head 出發、順著 next 一步一步走過去,這動作稱為走訪 (traversal)。
拿前面那兩個 node 來說,first 就是這條串列的 head,從它出發走一次是這樣:
let current = first;

while (current) {
  console.log(current.value);
  current = current.next;
}
這裡用 while 而不是 for,是因為手上只有 head,沒有任何東西告訴我們後面還接著幾個 node,無法確定迴圈執行次數,而實際上也不需要寫迴圈次數,null 本身就是個終點記號,踩到它代表走訪結束。
另一個差別在迴圈變數。for 的 i 是位置編號,背後假設「第 i 格拿得到」,但在 Linked List 上,i 這個數字換不到任何東西,因此這裡的 current 記的不是第幾個,而是「目前站在哪一個 node」。像這樣記住目前位置、每次往前挪一格的變數,一般稱為 cursor(游標)。
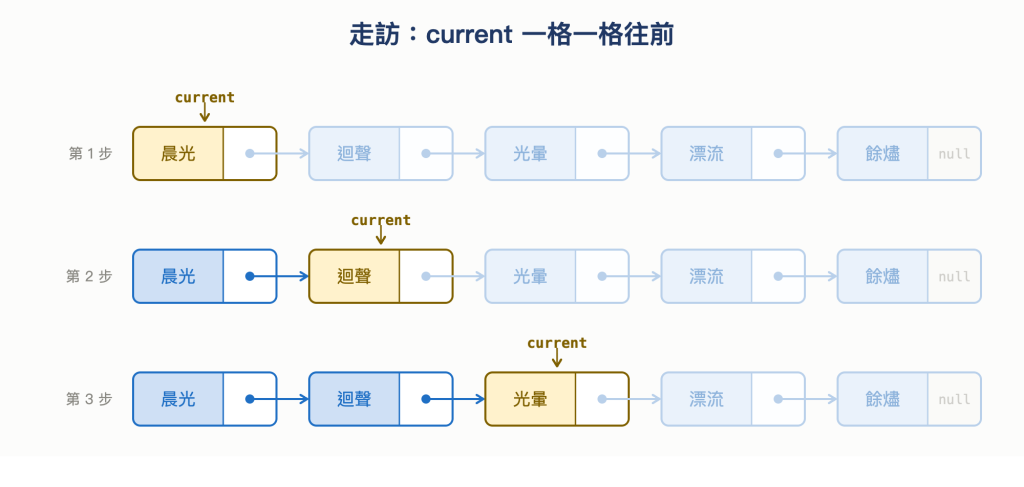
圖 3 走訪:current 一格一格往前
至於 tail,光靠 head 其實也走得到最後一個 node,那為什麼很多實作還要多存一個呢?這件事和 append 的成本有關。
有了 node、head 和 tail,就可以把這個結構寫出來了。JavaScript 沒有內建 Linked List,Array、Map、Set 都有內建,但 Linked List 需要我們自己手寫(Java 則有現成的 LinkedList)。
這裡用兩個 class,把前面那個物件包成 Node,再多一個 LinkedList 管理入口:
class Node {
  constructor(value) {
    this.value = value;
    this.next = null;
  }
}

class LinkedList {
  constructor() {
    this.head = null;
    this.tail = null;
    this.length = 0;
  }
}
先來看看 append,我們要把一首歌加到清單最後面:
append(value) {
  const newNode = new Node(value);

  if (this.tail === null) { // 空清單,head 和 tail 都是這個新 node
    this.head = newNode;
    this.tail = newNode;
  } else {
    this.tail.next = newNode;
    this.tail = newNode;
  }
  this.length++;

  return this;
}
開頭那個 if 是在處理空清單,這時候還沒有尾巴可以接上去,所以 head 和 tail 要一起指向這個新的 node。清單裡已經有東西的話,真正在做事的就只有 else 裡的兩行,先讓原本的尾巴接上新的 node,再把 tail 這個標記移到新的 node 身上,整段程式沒有碰到其他 node。
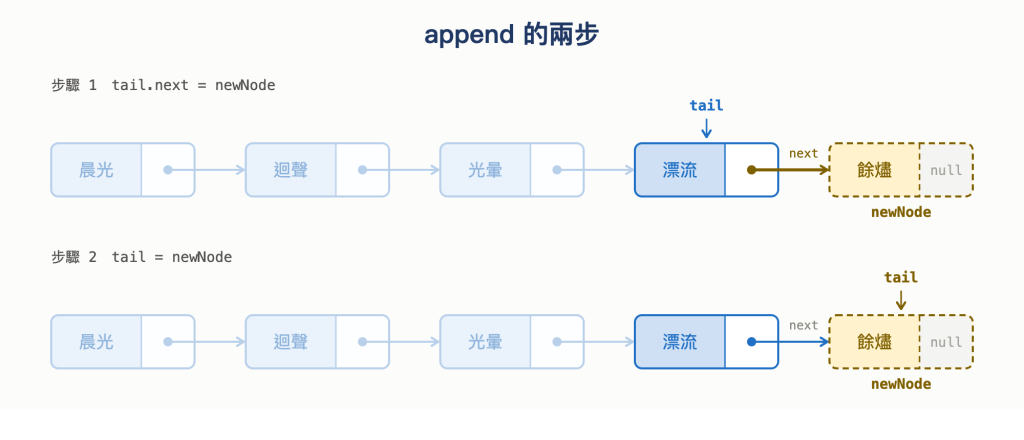
圖 4 append 的兩步:先讓原本的尾巴接上新 node,再移動 tail 標記
接著看 prepend,我們要把歌插到最前面:
prepend(value) {
  const newNode = new Node(value);

  newNode.next = this.head;
  this.head = newNode;
  if (this.tail === null) this.tail = newNode;
  this.length++;

  return this;
}
要注意的是,中間那兩行的順序不能對調。如果先寫 this.head = newNode,原本那個 head 就沒有任何東西指著它了,整條清單會斷掉,等到下一行想拿 this.head 去接的時候,拿到的已經是新 node 自己。這和 Day 05 那條「搬移時不要蓋掉還沒處理的資料」是同一個原則,只是 Array 怕蓋掉元素,Linked List 怕改掉還沒接好的連結。至於最後那行 if,和 append 是同一件事,清單原本是空的時候,這個新 node 同時也是尾巴。
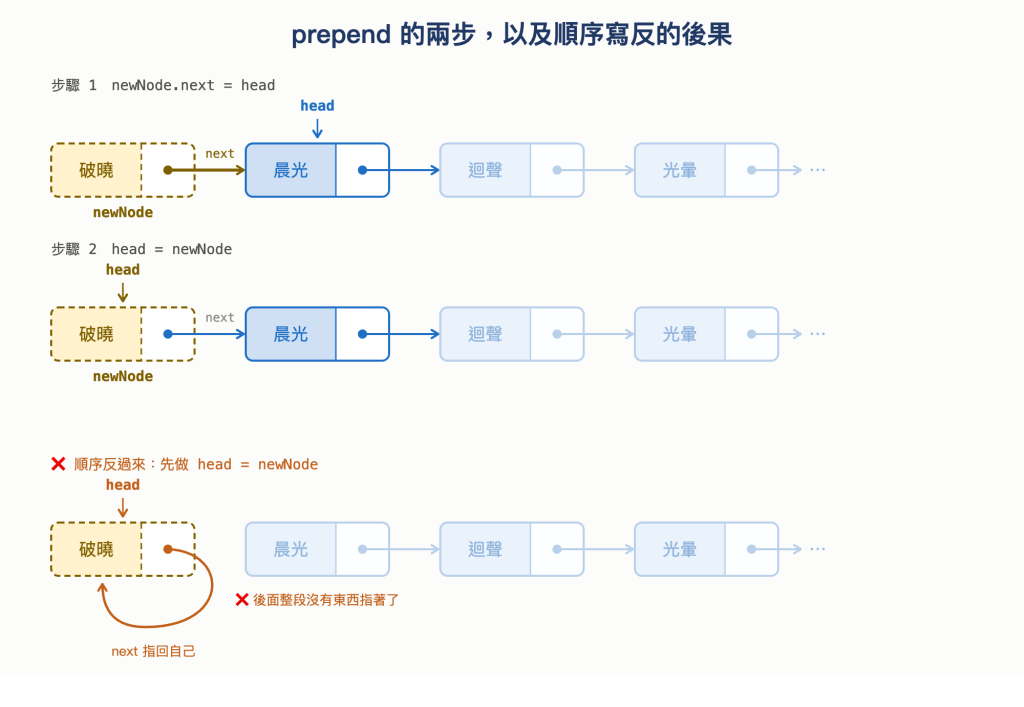
圖 5 prepend 的兩步:先讓新 node 接住舊的 head,再移動 head 標記
讓我們把播放清單建起來看看:
const playlist = new LinkedList();

playlist.append('晨光');
playlist.append('迴聲');
playlist.append('光暈');
playlist.append('漂流');
playlist.append('餘燼');
playlist.prepend('破曉');
兩個方法最後都回傳 this,所以也可以像 playlist.append('迴聲').append('光暈') 這樣一路接下去。而這段跑完之後,清單裡的 head 已經不是〈晨光〉而是〈破曉〉,tail 則是〈餘燼〉,中間 5 首歌從頭到尾沒有任何一個 node 被搬動過,改到的只有兩張紙條。
接著看讀取,Array 的 songs[3] 是一次計算就跳過去,Linked List 沒有這個能力,只能從 head 開始數:
lookup(index) {
  let current = this.head;
  let count = 0;

  while (current) {
    if (count === index) return current.value;

    current = current.next;
    count++;
  }

  return null;
}
寫法和前面的走訪幾乎一樣,差別只在終止條件多了一個,除了走到 null 之外,數到目標 index 也會停。要拿 index 3 的那首歌,就得從 index 0 一路走 4 步,因此清單越長,讀後面的資料越慢。
如果反過來,手上有的是歌名、想知道它排在第幾首呢?寫法幾乎一模一樣:
search(value) {
  let current = this.head;
  let count = 0;

  while (current) {
    if (current.value === value) return count;

    current = current.next;
    count++;
  }

  return null;
}
兩個方法都是從 head 出發、沿著連結往下走,真正的差別只在什麼時候停下來:
| 操作 | 停下來的條件 |
|---|---|
| lookup | 數到指定的 index,或走到 null |
| search | 找到指定的值,或走到 null |
播放清單也可以照歌名排序,那 Binary Search 能不能用在 Linked List 上呢?答案是不行,理由 Day 06 已提過,Binary Search 每一輪都要直接跳到剩餘範圍的中間那一格,而在 Linked List 上,「跳到中間」這件事本身就得先走一趟,省下來的比較次數也就沒有意義了。
以下把前面做過的操作整理成一張表:
| 操作 | 成本 | 為什麼 |
|---|---|---|
| lookup | O(N) |
只能從 head 一步一步走過去 |
| search | O(N) |
同樣要走,而且每一格都要比對值 |
| prepend | O(1) |
要動的 head 本來就在手上 |
| append | O(1),沒存 tail 是 O(N) |
有 tail 就不必再去找最後一個 node |
| insert | O(N),開頭是 O(1) |
改接只要幾行,但得先走到前一個 node |
| delete | O(N),開頭是 O(1) |
同上,花時間的是走過去那一段 |
insert 和 delete 的實作留到下一篇再來介紹~
Linked List 的插入成本應該拆成兩段來看,一段是「走到那個位置」,另一段是「改接連結」,而改接連結永遠只有固定的兩三行,跟清單多長完全無關,成本高的一直是走過去的那一段。
拿插在開頭這件事來看看,一份 5000 首歌的清單,用 Array 存的話,要在最前面插一首,得把 5000 個元素通通往後挪一格;用 Linked List 存的話,要做的是建一個 node、把它的 next 接上原本的 head、再把 head 換成它,總共三個動作。差別不在誰的迴圈寫得比較好,而在前者必須一直維持「位置相鄰」這個條件,後者從一開始就不需要。
另外,append 之所以是 O(1),並不是因為接在尾端這個動作成本比較低,而是因為我們額外存了一個 tail,把「找到最後一個 node」這件事變成不用做。而只保存 head 的實作其實不少見,有些教學資源在介紹 Linked List 時就只給一個 head,這時 append 就需要 O(N)。換句話說,那個 O(1) 是拿一格空間換來的。
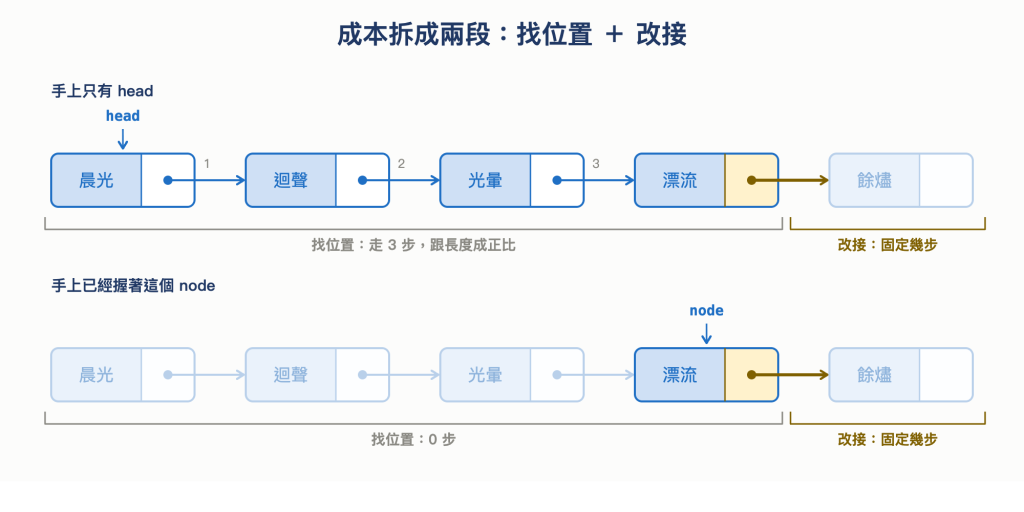
圖 6 成本拆成兩段:找位置 + 改接
前面走訪時說過,Linked List 不需要知道長度,走到 null 就是走完了,不過這句話有個前提,就是整條串列真的會走到 null。
那如果最後一首歌的 next 不是 null,而是指回第一首呢?
以播放清單來說,這可稱之為循環播放功能,這種頭尾接起來的形式有個名字叫 circularly linked list。但這種接法如果不是刻意的,麻煩就大了,前面那個 while (current) 會一直繞下去,永遠踩不到 null,而實際上會冒出這種串列,通常是改連結的時候接錯了。
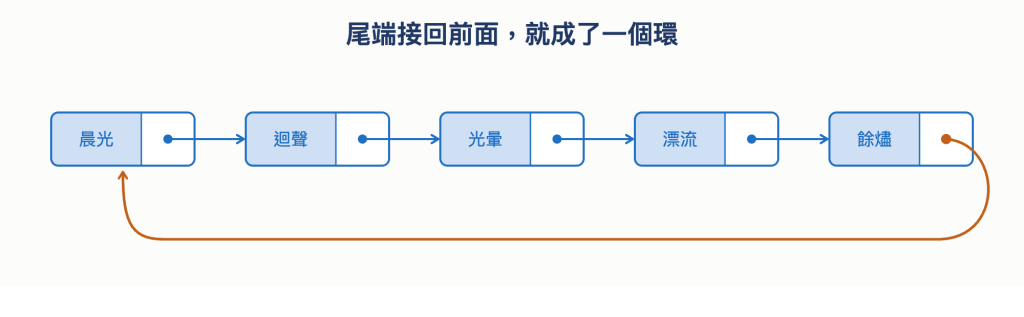
圖 7 尾端接回前面就形成 cycle,走訪永遠踩不到 null
要判斷一條串列有沒有繞回去,有一個巧妙做法,讓兩個 cursor 同時從 head 出發,一個一次走一步,一個一次走兩步。如果串列有終點,走得快的那個會先踩到 null;如果串列繞成了一圈,兩個都停不下來,而走得快的那個遲早會從後面追上走得慢的那個,當兩個 cursor 指到同一個 node,就知道這裡有 cycle 了。之所以一定追得上,是因為兩個 cursor 都進到那個圈子之後,每過一輪它們之間的距離就會縮短一格,而只要距離穩定變小,總會有一輪歸零。這個方法通常叫做龜兔賽跑 (tortoise-hare) 演算法。
寫成程式,骨架就是前面那個走訪的迴圈,只多了一個判斷:
function hasCycle(list) {
  let slow = list.head;
  let fast = list.head;

  while (fast && fast.next) {
    slow = slow.next;
    fast = fast.next.next;

    if (slow === fast) return true;
  }

  return false;
}
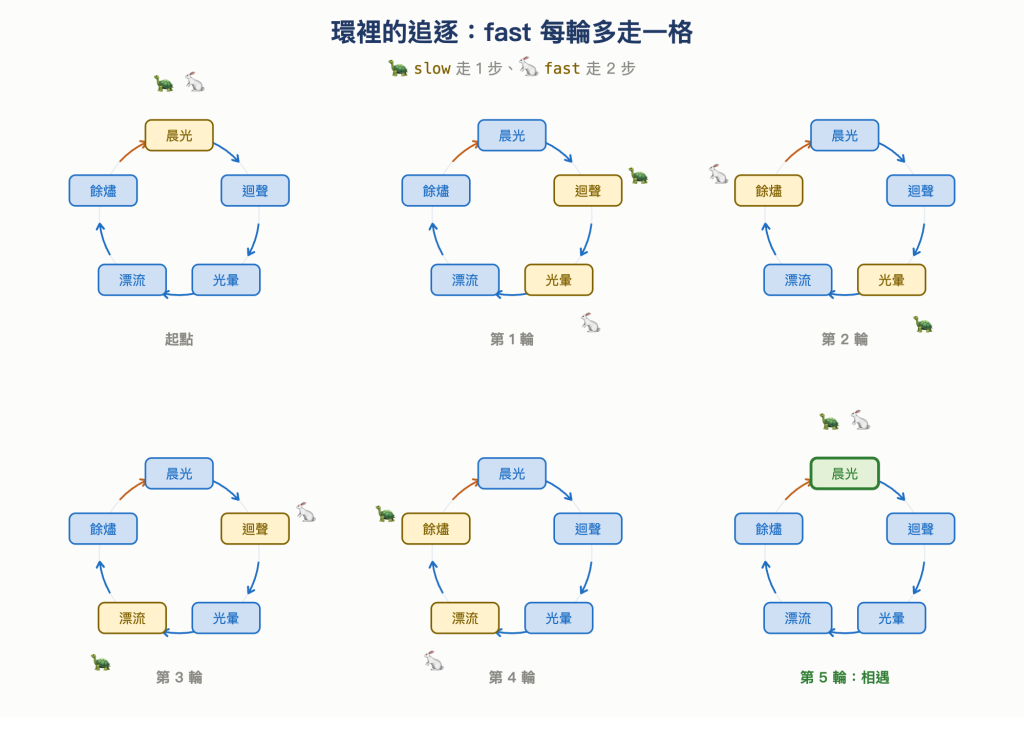
圖 8 環裡的追逐:fast 每輪多走一格,兩者的距離每輪縮短一格
同一組快慢指標還可以拿來做另一件事,找出中間那首歌。如果我們連清單有幾首都不知道,要怎麼判斷現在站的位置就是中間呢?
最直覺的做法是走兩趟,第一趟數出總共有幾首,第二趟再走到一半的位置停下來。而如果改用快慢指標的話,一趟就夠了:
function findMiddle(list) {
  let slow = list.head;
  let fast = list.head;

  while (fast && fast.next) {
    slow = slow.next;
    fast = fast.next.next;
  }

  return slow.value;
}
兔子(fast)一次走兩步、烏龜(slow)一次走一步,因為兔子走的距離永遠是烏龜的兩倍,所以兔子走到底的那一刻,烏龜剛好停在中間。
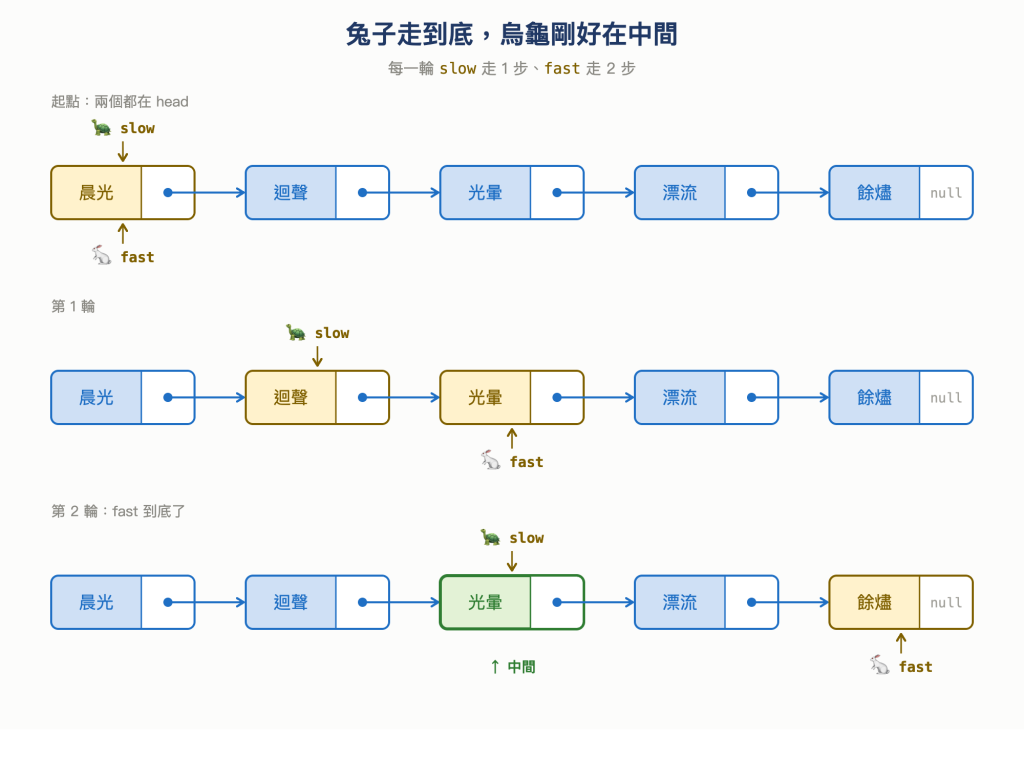
圖 9 兔子走到底時,烏龜剛好停在中間那一格
另外,這比例其實是可以調的。讓兔子改成一次走 3 步、烏龜維持 1 步,兔子走到底的時候烏龜就停在 1/3 的位置;兔子一次走 4 步就是 1/4。想停在幾分之一,兔子就跑幾倍,中間點只是最常見的情況。要注意的是迴圈的終止條件得跟著多檢查幾格,確認兔子真的還跨得出那幾步,不然會踩到 null。
不過快慢指標其實沒有省到步數。走兩趟的做法是先走完一遍、再走半遍,快慢指標則是烏龜走半遍、兔子走一遍,兩邊加起來的移動次數落在同一個量級,真正的差別只在一個要把清單看過兩輪,另一個一輪就結束。而 hasCycle 和 findMiddle 的骨架幾乎一樣,差別只在迴圈裡多不多那個比對兩個 cursor 的 if。
這種在一條串列上同時擺兩個 cursor 的手法在 Linked List 的題目裡很常見,因為在這個結構上,「位置」只能靠走出來,多一個 cursor 就等於多記住一個位置。
整理一下 Array 與 Linked List 的差異,第一組是儲存與存取方式:
| 項目 | Array | Linked List |
|---|---|---|
| 記憶體配置 | 連續的一整段 | 每個 node 各自配置,可以散落各處 |
| 每一格存什麼 | 只有資料 | 資料之外還要存一個 next |
| 能直接碰到的位置 | 任何 index | 只有 head(以及有存的話的 tail) |
| 前往其他位置 | 用 index 算出來 | 從 head 順著連結走過去 |
Linked List 的每個 node 除了資料本身,還得挪一份空間出來放 next,一條 5000 個 node 的 Linked List 就是 5000 份額外開銷,而這是 Array 不用付的成本。Day 03 談 space complexity 時說過,空間和時間一樣是需要拿來衡量的資源,Linked List 的彈性是拿這份空間換來的。
第二組是插入與刪除,這裡兩邊剛好相反:
| 操作位置 | Array | Linked List |
|---|---|---|
| 開頭 | 成本最高,所有元素都要往後挪 | 成本最低,只要改 head |
| 中間 | 後面的元素都要挪 | 要先走到前一個 node |
| 尾端 | 成本最低,直接寫進下一個空位 | 成本最高,要走到底(除非存了 tail) |
可看出兩種資料結構插入成本低的地方不一樣,Array 在尾端成本低,是因為後面沒有人需要挪;Linked List 在開頭成本低,是因為要動的那個 node 本來就握在手上。前者的成本來自搬移,後者的成本來自尋找,這也是它們的最佳與最差位置會剛好對調的原因。
這時可能會有個想法:以後需要頻繁在開頭插入的時候,是不是就用 Linked List 處理就好?這想法理論上成立,不過實際應用還有一些因素要考慮。
Linked List 在實務上有兩個缺點:
因此實務上 Linked List 沒有想像中好用,通常是某些需要極致效能的情境才會自己手刻,其他時候多半會用語言內建的容器,或者乾脆換一種結構。比較安全的說法是,Linked List 的插入之所以成本低,是因為它不用搬資料,而不是因為它比較快,而「不用搬資料」這個好處要真的拿到,前提是我們已經站在要插入的位置上。
Linked List 實際上會用在哪裡呢?機器學習裡有一種資料,形狀正好適合它。
假設有一個線上廣告平台,裡面累積了大量投放紀錄,每一筆記著某則廣告出現在哪個網站上,現在想拿這些紀錄訓練一個模型,讓它學會判斷什麼樣的投放比較有效。
然而,模型吃的是數字,而「出現在哪個網站」是一個字串,得先變成數值才餵得進去。最直覺的做法可能是給每個網站編號,yahoo.com 是 1、google.com 是 2,但這樣等於憑空幫網站排了大小,模型會把編號當成可以比較、可以相加的數值來用,而網站之間本來沒有這種關係。常見做法之一是 one-hot encoding,把所有選項各佔一個維度,是哪一個就在那一維填 1、其餘全部填 0,每個選項彼此獨立,不會誤生出大小關係。代價則是維度等於選項的數量,10,000 個網站就是一條 10,000 維的向量,而裡面只有 1 個位置是 1,其餘 9,999 個維度全是 0。
用 10,000 格去記「是第幾個網站」這一件事,其中 9,999 格存的都是沒有資訊的 0,而像這樣絕大多數元素都是 0 的向量,稱為稀疏向量 (sparse vector)。
那要怎麼存比較好呢?0 在計算上通常不帶什麼資訊,乘出來是 0、加上去也不會改變結果,真正有價值的只有那幾個非零的位置。與其老實開一整排格子連 0 都存下來,不如只記錄「第幾維是多少」這樣的配對。換一個小一點的例子來看,[0, 0, 6, 0, 4, 0, 0] 就只剩下 (3, 6) 和 (5, 4) 兩筆,代表第 3 維是 6、第 5 維是 4,如此不只省下儲存空間,計算時也不必花步驟處理那些必然是 0 的項。
而這些配對本身有順序(依維度由小到大),數量又會隨著計算過程增減,正好是 Linked List 派得上用場的時候,把它們串成一條依維度排好的串列,多一項就是改接一次連結。
計算起來也很方便,要把兩條稀疏向量相加,只需要各派一個 cursor 從頭開始往前走,比較兩邊目前停在第幾維,維度小的那個先前進,維度相同時就把兩個值加起來,整個過程都不會碰到任何一個 0,用的正是前面找中間值那個兩個 cursor 的手法。
實際走一次看看。假設 v1 有兩項,(3, 6) 和 (5, 4);v2 有三項,(1, 2)、(4, 9) 和 (5, -4)。兩個 cursor 一路比下來,第 1 維只有 v2 有、第 3 維只有 v1 有、第 4 維只有 v2 有,這三項各自抄進結果裡;到了第 5 維兩邊都有,於是把 4 和 -4 加起來,得到 0。而 0 在這個表示法裡本來就不存,所以這一項直接消失了,最後的結果只剩下三項。這個表示法不只在儲存的時候跳過 0,運算過程中新長出來的 0 也會一起被丟掉。
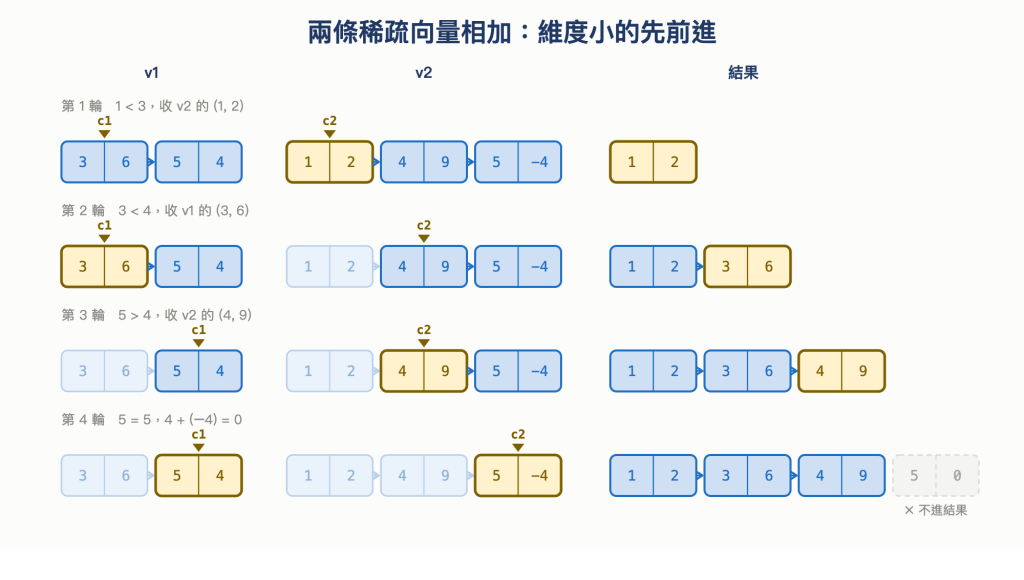
圖 10 兩個 cursor 各走各的,維度小的先前進
還有一個情境要處理,兩條的長度通常不一樣,先走完的那條結束之後,另一條剩下的項要整批接到結果後面,不然資料就漏了。把這些湊起來就是完整的做法,這裡讓每個 node 存一組 [維度, 值]:
function mergeSparse(v1, v2) {
  let c1 = v1.head;
  let c2 = v2.head;
  let head = null;
  let tail = null;

  const push = (pair) => {
    const node = new Node(pair);
    if (tail === null) head = node;
    else tail.next = node; // 在目前尾巴接新的 node
    tail = node; // 更新新的 node
  };

  while (c1 && c2) {
    const [d1, x1] = c1.value;
    const [d2, x2] = c2.value;

    if (d1 < d2) { // d1 維度小,就推 d1 的值並讓他的 cursor 前進
      push(c1.value);
      c1 = c1.next;
    } else if (d1 > d2) { // d2 維度小,就推 d2 的值並讓他的 cursor 前進
      push(c2.value);
      c2 = c2.next;
    } else { // 兩者維度相同時,值相加
      const sum = x1 + x2;
      if (sum !== 0) push([d1, sum]);
      c1 = c1.next;
      c2 = c2.next;
    }
  }

  // cursor 還沒到尾時,將剩下的推入
  while (c1) { push(c1.value); c1 = c1.next; }
  while (c2) { push(c2.value); c2 = c2.next; }

  return head;
}
裡面有三個地方剛好把前面講過的事情用上了。if (sum !== 0) 是「相加變成 0 就不進結果」;最後兩個 while 把還沒走完的那一條補上;而 push 做的就是 append,一樣要先處理結果還是空的那個情況,之後靠 tail 直接接上去,不必每次從頭走一遍。
拿前面那組數字實際跑一次,這裡每個 node 裝的不再是歌名,而是一組 [維度, 值]:
const v1 = new LinkedList();
v1.append([3, 6]);
v1.append([5, 4]);

const v2 = new LinkedList();
v2.append([1, 2]);
v2.append([4, 9]);
v2.append([5, -4]);

mergeSparse(v1, v2);
// (1, 2) → (3, 6) → (4, 9) → null
而把裡面做的事情換掉,同一套骨架還能計算別的東西,例如兩條向量的內積,一樣是兩個 cursor 往前走,只是維度相同的時候改成相乘再累加。
最後再看一個地方,同一份資料換個角度讀,會變成另一個東西。(3, 6) 讀成向量是「第 3 維的值是 6」,讀成多項式就是 6x³,所以多項式其實是稀疏向量的一個特例,像 f(x) = 5 + x - 4x² + 10x⁵ + x¹⁶ 這種只有少數幾項有係數的式子,用同一套結構存就可以了。
小小總結一下今天對 Linked List 的認識~
null。最後補充幾點~
O(N)。今天做的 append 和 prepend,動到的都是手上現成的 node,一個是 head、一個是 tail,所以兩行就寫完了。但如果要插的位置在中間,或是想把某一首歌從清單裡拿掉呢?那就得先走到它前面那一個 node,而且改連結的順序一旦弄錯,斷掉的可能還不只一條。下一篇就從這裡開始~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術