
摘要
ChatGPT Work 與 Codex 都能接手多步驟任務並交付成果,但兩者依賴的工作回饋不同。ChatGPT Work 通常從資料、搜尋、分析與工具操作出發,逐步收斂成文件、試算表、報告或網站;Codex 則面向軟體系統,持續進行「讀取 → 修改 → 執行 → 驗證 → 再修正」的工程迴圈,測試結果、終端機輸出、瀏覽器狀態與錯誤訊息都能成為下一步行動的依據。本文以既有的鐵人賽流量儀表板為案例,將「文章比較」功能交給 Codex。AI 代理自行讀取專案、修改程式,並依現有網站條件驗證兩篇文章選取、第三篇限制、搜尋與 Day 篩選、桌機與手機版面,以及 JavaScript 主控台狀態。第二個案例進一步使用多個 AI 代理,同時建立「底部比較列」與「彈出視窗」兩種互動方案,保留正式版本,再由人比較操作成本、畫面占用與手機體驗。這兩次實作呈現代理式程式開發(Agentic Coding)的核心變化:人交付的單位從程式碼片段提升為包含目標、限制與驗收條件的任務;AI 代理負責讀取系統回饋並推進工程流程,人則把注意力放在需求定義、驗收標準、探索方向與最終決策。
ChatGPT Work 和 Codex 放在一起時,最容易讓人困惑的地方,是兩邊看起來都能「自己把事情做完」。我可以把一批資料交給 Work,讓它研究、分析,再做成網站;也可以把既有網站交給 Codex,讓它修改功能、執行程式,再把結果交回來。只看最後產出的東西,很難畫出一條乾淨的界線。
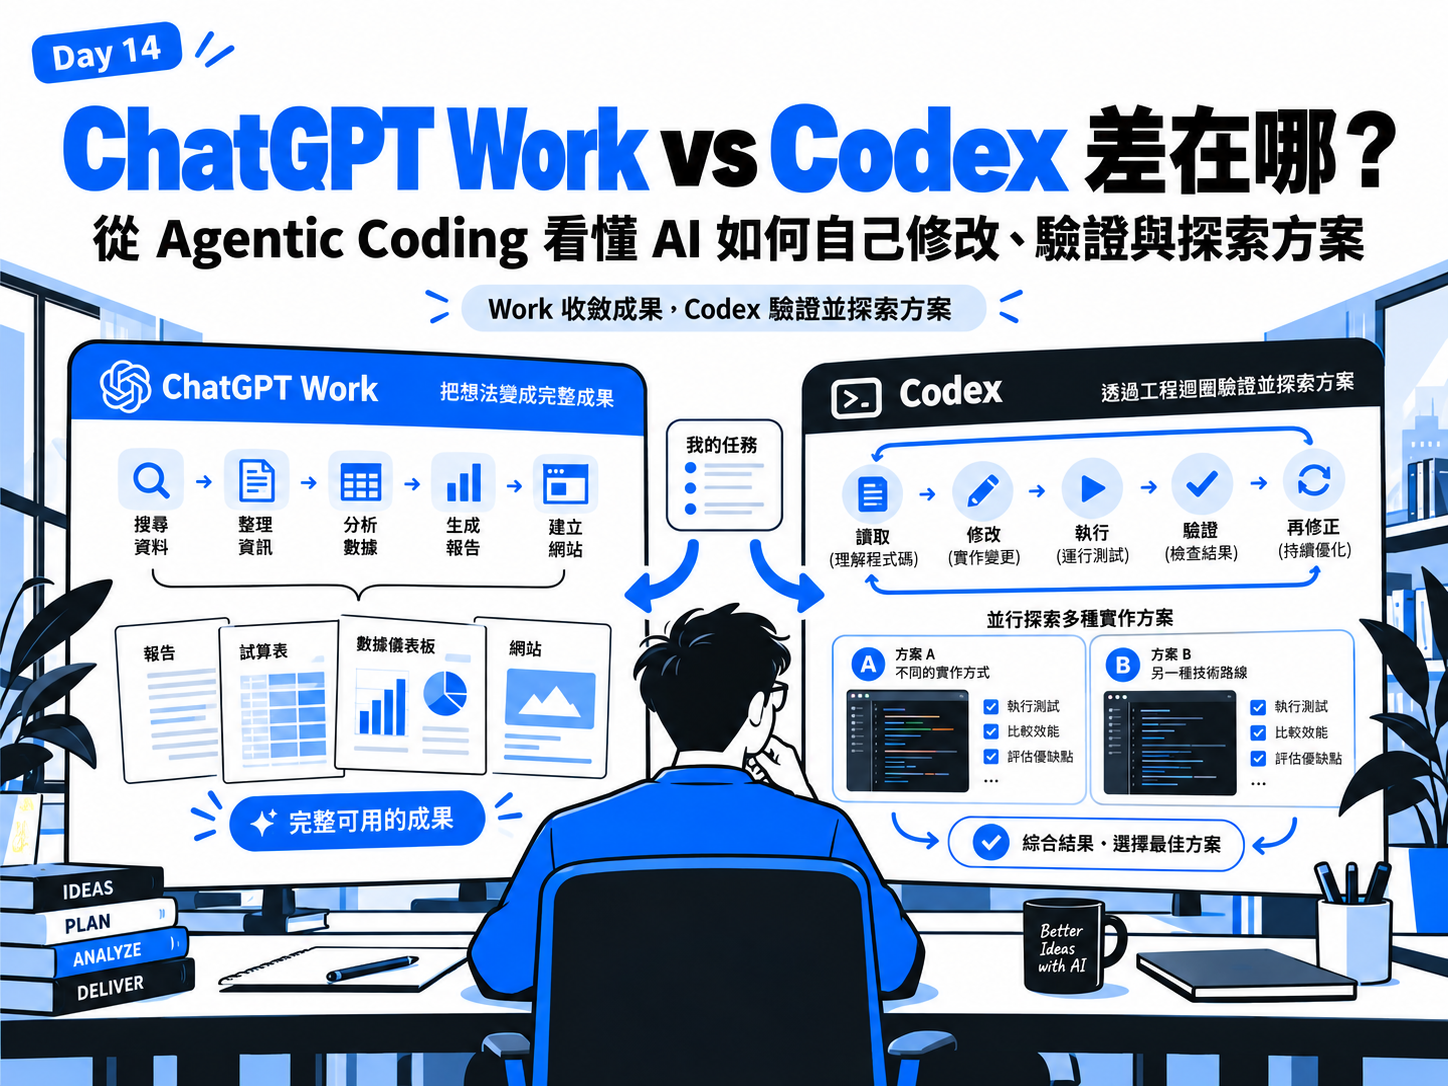
OpenAI 現在把 ChatGPT Work 定位在較長、多步驟的工作與完整交付成果;Codex 則專注在軟體開發與技術工作。前者常處理研究、文件、試算表、報告與網站,後者則會寫程式、除錯、執行測試與指令、審查變更,以及處理程式碼儲存庫。
但「Work 做成果、Codex 做軟體」還不夠精確。軟體本身也是成果。真正把兩邊拉開的,是 AI 代理(Agent)靠什麼回饋決定下一步。
Work 的工作路徑通常朝交付物收斂:先取得資料、分析、整理,再交出文件、報告或網站。Codex 面對既有軟體系統時,還多了一個工程迴圈:
理解現況 → 修改 → 執行 → 驗證 → 審查 → 再修正
程式能不能跑、測試有沒有通過、瀏覽器有沒有報錯,都可能成為下一步的輸入。這也是我現在理解兩者最穩定的方式:ChatGPT Work 圍繞任務與交付成果推進;Codex 圍繞可執行、可驗證的軟體工作迴圈推進。
這篇不打算把 Codex 所有功能走一遍。我只聚焦四件事:把既有專案交給 AI 代理、給它一項任務、看它怎麼驗證結果,再看看多個 AI 代理如何同時探索不同方案。
AI 很早以前就會補程式,也能在聊天視窗裡產生一整段 JavaScript、Python 或 HTML。真正改變的,是我們開始把更大的工作單位交出去。
自動補全(Autocomplete)時,人正在寫程式,AI 猜下一段。到了對話式程式開發(Chat Coding),AI 可以一次產生完整程式,但把程式放回專案、執行、看到錯誤、再回來追問,仍然由人把流程接起來。
程式開發代理(Coding Agent)把這條線再往前推。現在交出去的單位可以是一項 任務(Task)。人描述目標與限制,AI 代理讀取專案、修改檔案、執行工具、取得結果,再依結果決定下一步。
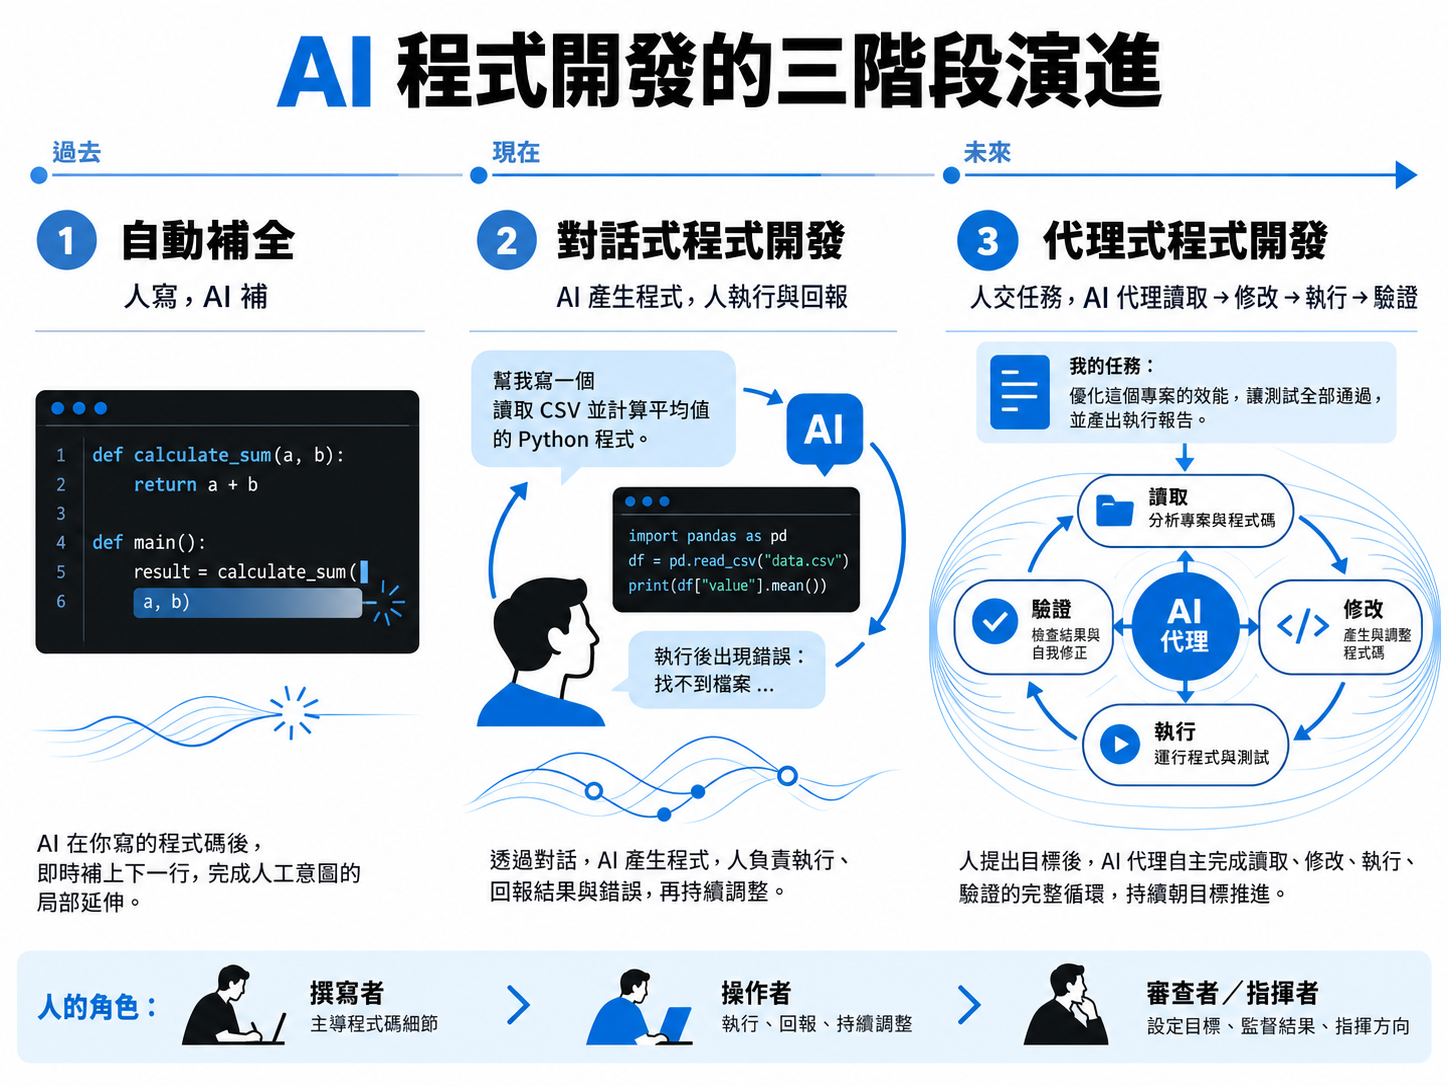
〔圖解:AI 程式開發的三階段。第一階段「自動補全」:人寫、AI 補;第二階段「對話式程式開發」:AI 產生程式,人負責貼回專案、執行與回報;第三階段「代理式程式開發(Agentic Coding)」:人交任務與限制,AI 代理在「讀取→修改→執行→驗證」循環,人負責介入調整與審查。〕
這裡最重要的變化,是「下一步怎麼走」開始交給 AI 代理。它不只產生程式碼,也能讀取終端機輸出、瀏覽器結果或測試失敗,再把這些回饋帶回下一輪修改。
人的位置也跟著改變。我不需要對每一行程式下指令,而是把注意力移到需求、限制、驗收與最後的決策。
打開 Codex 後,我先把既有的「鐵人賽流量儀表板」開進來。從這一刻開始,AI 代理面對的是一個正在運作的軟體系統,而不是一段被複製進聊天框的程式碼。
這次我想加入「文章比較」:使用者最多選兩篇文章,打開比較後,可以並排查看 Day、標題、瀏覽數、內容評分、心智模型、資訊含量與讀者摩擦力;原本的搜尋與 Day 篩選要繼續運作,手機版也要能閱讀。
我只寫需求與驗收條件。要修改哪個檔案、比較狀態放在哪裡、畫面怎麼接進既有列表,都交給 Codex 先讀專案再決定。
〔截圖:Codex 開啟鐵人賽流量儀表板,並收到「加入文章比較」任務。畫面保留專案名稱、任務內容與工作區資訊。〕
五分多鐘後,文章比較功能已經出現在本機網站。Codex 修改了 site/index.html,文章列表可以選擇最多兩篇;選滿後,其他文章停止加入,也能移除其中一篇重新選擇。桌機使用雙欄,手機切成單欄;搜尋與 Day 篩選後,已選文章仍然保留。
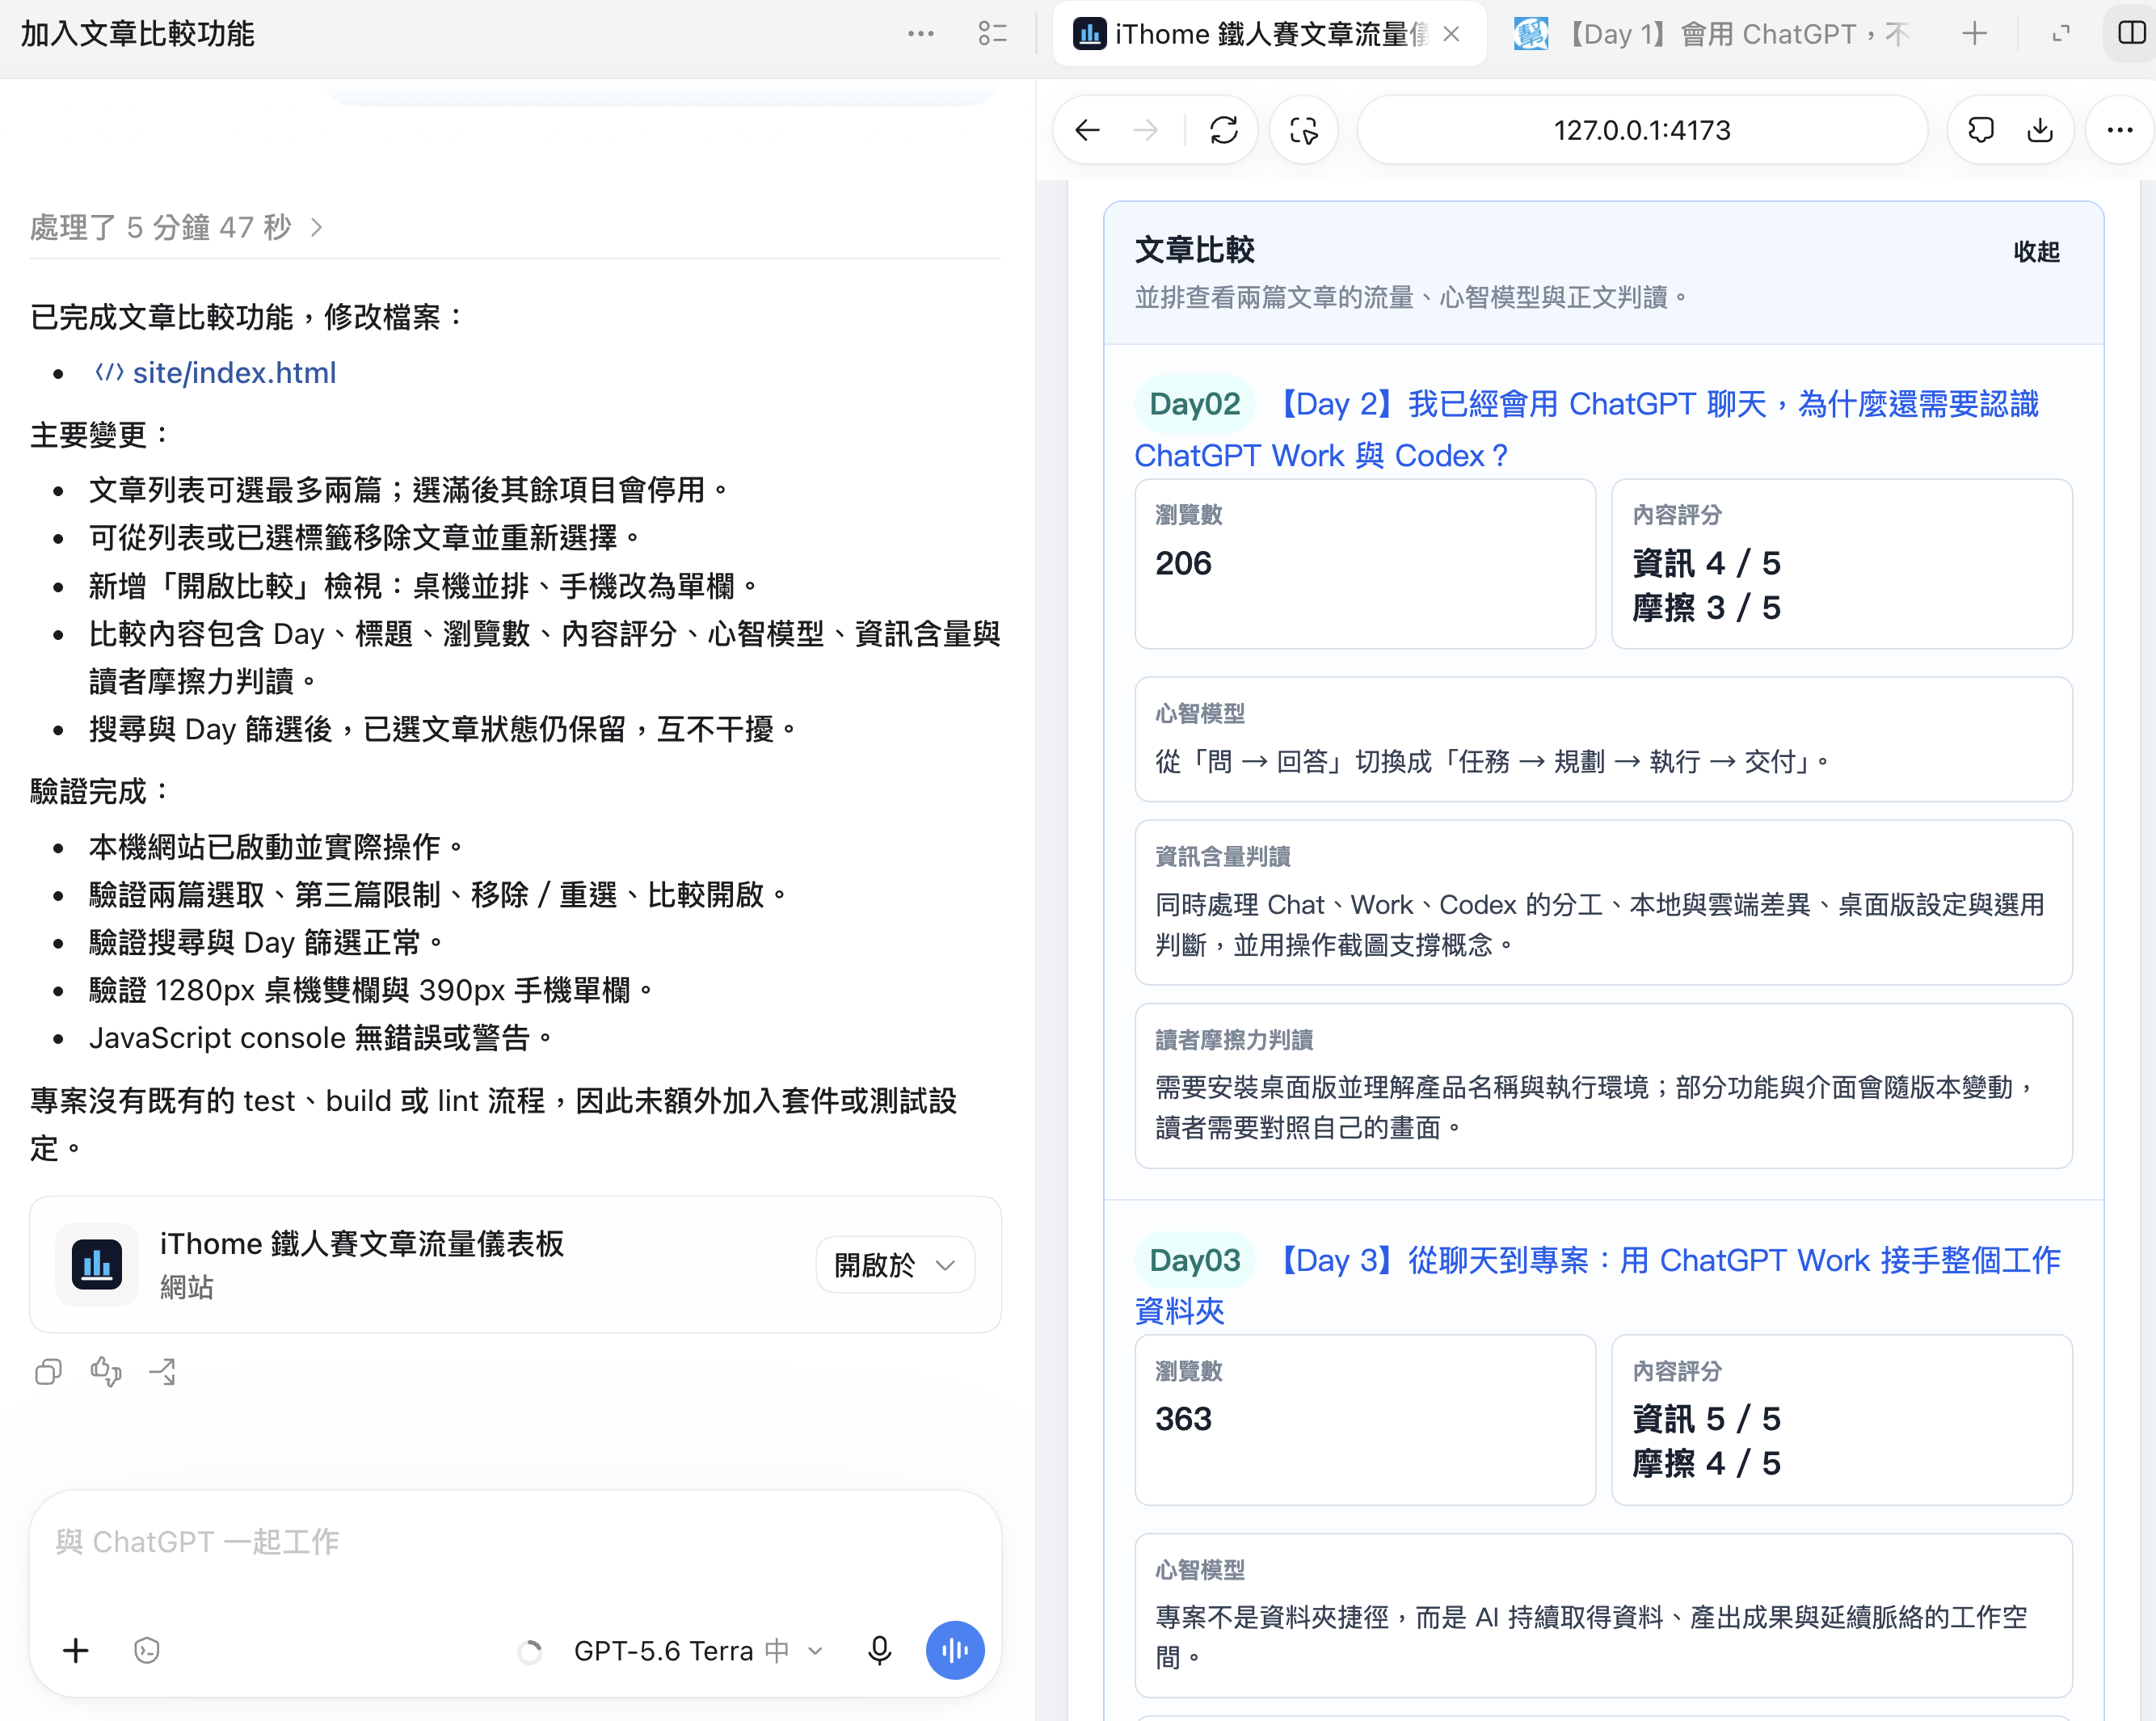
〔截圖:完成後的文章比較畫面。左側顯示 Codex 的完成回報,右側顯示兩篇文章並排比較瀏覽數、內容評分、心智模型、資訊含量與讀者摩擦力。〕
比功能本身更值得看的,是 Codex 怎麼驗證它。它實際測了兩篇選取、第三篇限制、移除與重選、比較開啟、搜尋與 Day 篩選,也檢查 1280px 桌機與 390px 手機寬度;JavaScript 主控台(console)沒有錯誤或警告。
這個專案本來沒有既有的測試(test)、建置(build)或程式碼檢查(lint)流程,所以 Codex 沒有為了看起來完整而臨時加上一套測試框架。它直接用這個網站現有的條件完成驗證。
這次工作因此形成一條很具體的工程路徑:
讀取專案 → 修改 → 啟動 → 操作 → 驗證 → 回報
驗證方式取決於系統本身。成熟的程式碼儲存庫可能跑測試或建置;這個靜態網站則依靠瀏覽器互動、響應式版面(responsive layout)、JavaScript 語法與主控台來確認結果。
文章比較做完後,我沒有立刻把這個版本當成唯一答案。我想知道,同一個功能如果有兩種合理的互動方式,Codex 能不能先把兩條路都走到可以操作,再讓我決定。
這次我的提示詞(Prompt)很短:
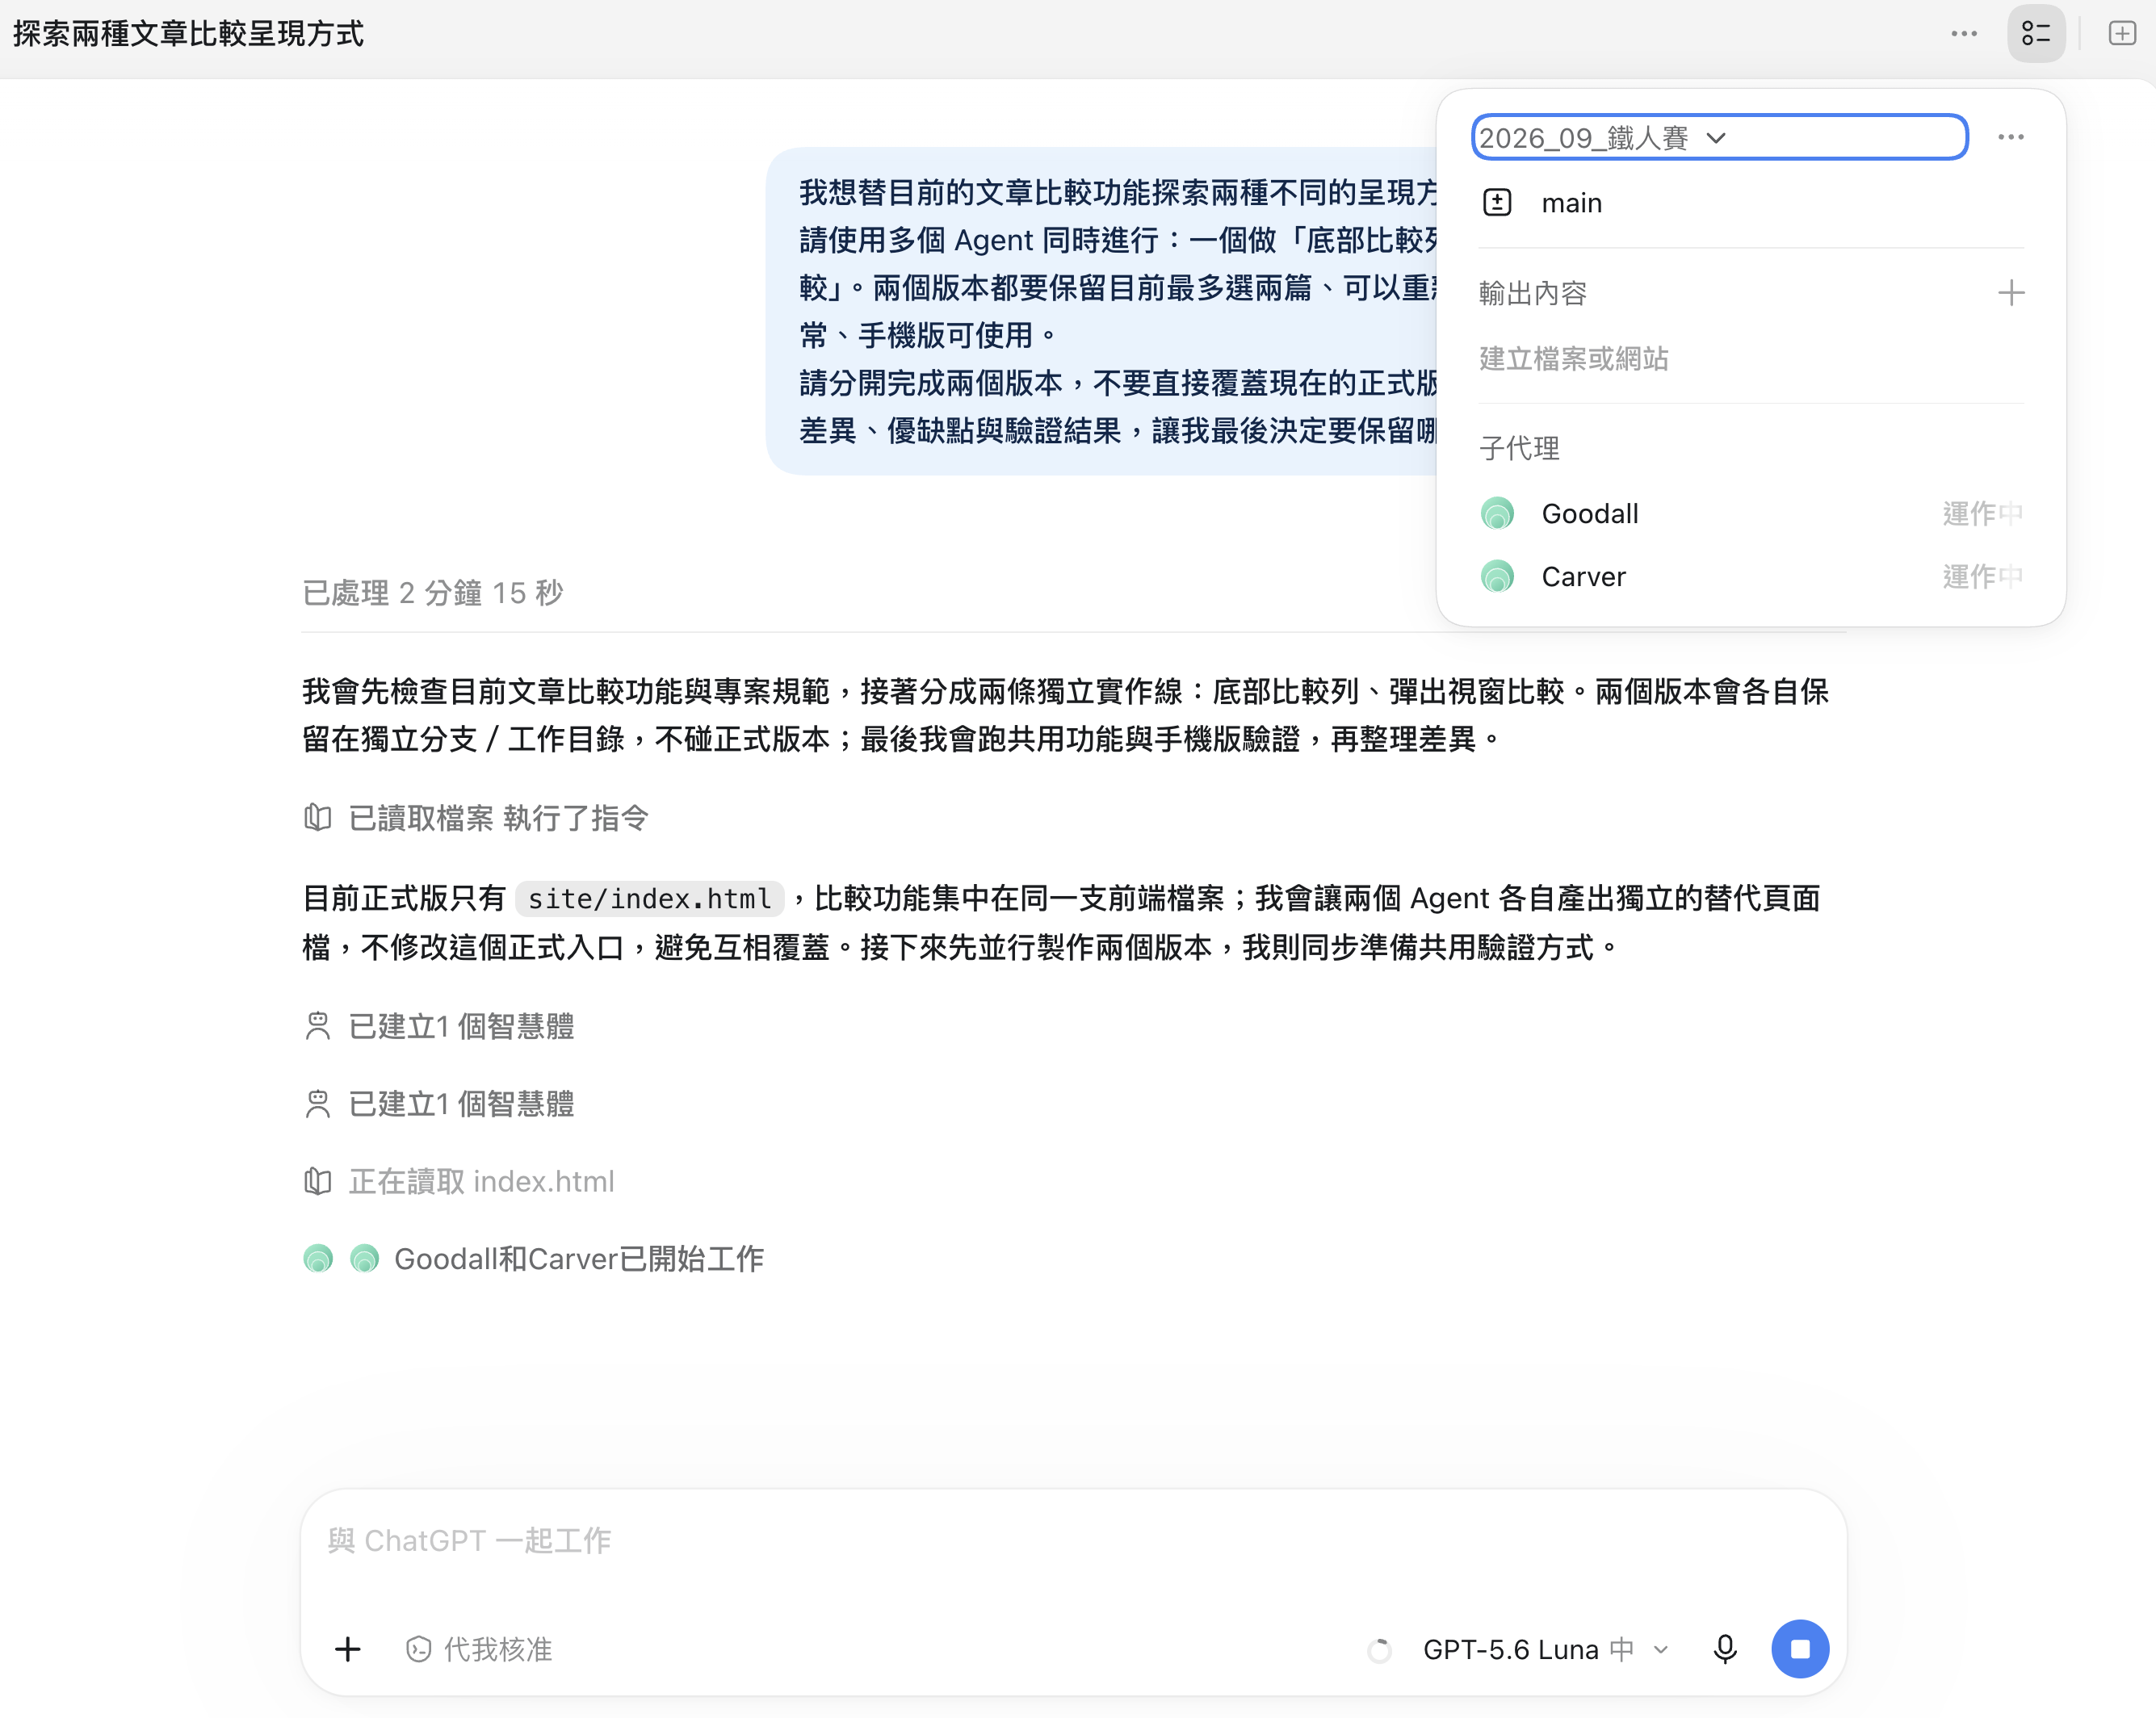
文章比較功能我想看兩種版本:一個用底部比較列,一個用彈出視窗。請用多個 AI 代理同時做,兩邊都保留現在的搜尋、Day 篩選和手機版支援。完成後把兩個版本的差異整理給我,我再決定用哪一個。
我沒有指定檔案、元件或獨立工作區(worktree)。九分多鐘後,Codex 回報兩個版本已經分開完成,而且沒有覆蓋目前的正式版本。
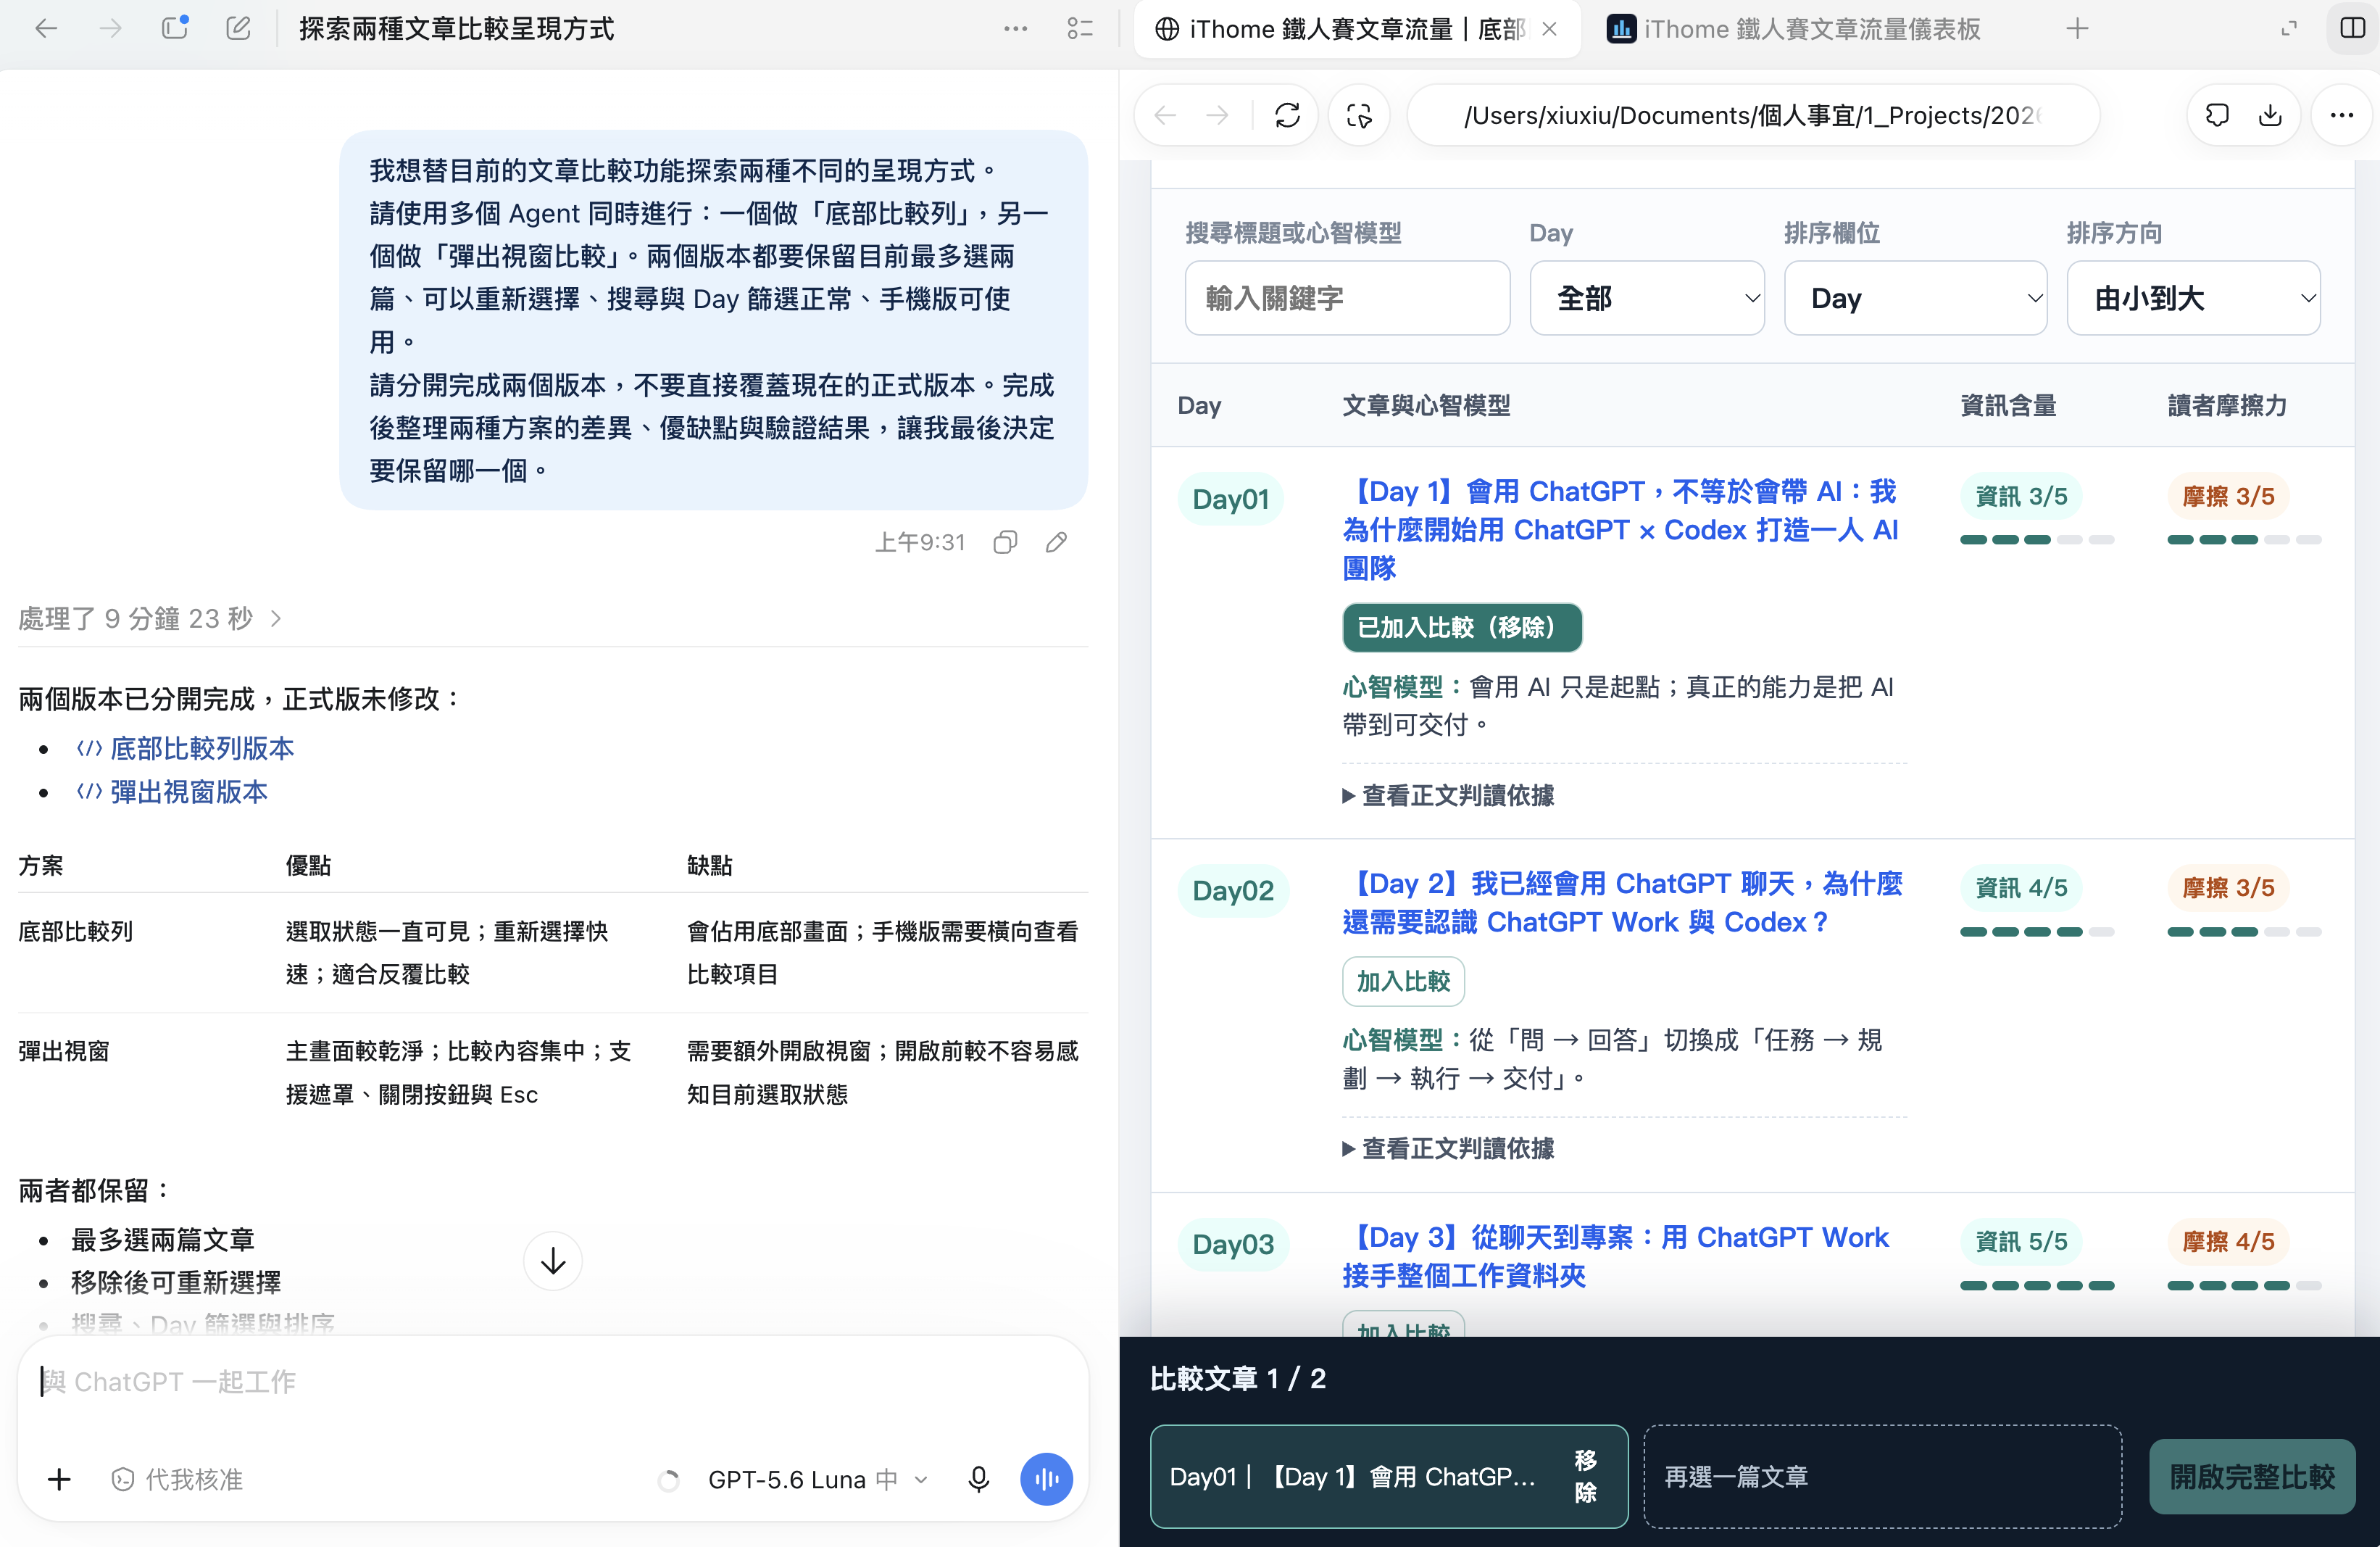
〔截圖:完整提示詞與 Codex 的完成摘要。左側可以看到一次要求兩種方案,完成後列出「底部比較列版本」與「彈出視窗版本」,右側顯示其中一個可操作版本。〕
第一個方案把已選文章固定在畫面底部。使用者選擇 Day01 後,底部比較列會持續顯示「比較文章 1 / 2」、目前選取項目與「開啟完整比較」。選取狀態一直留在視線裡,移除、重選和反覆比較都很快;代價是它長期占用底部空間,手機版可用的寬度更少。
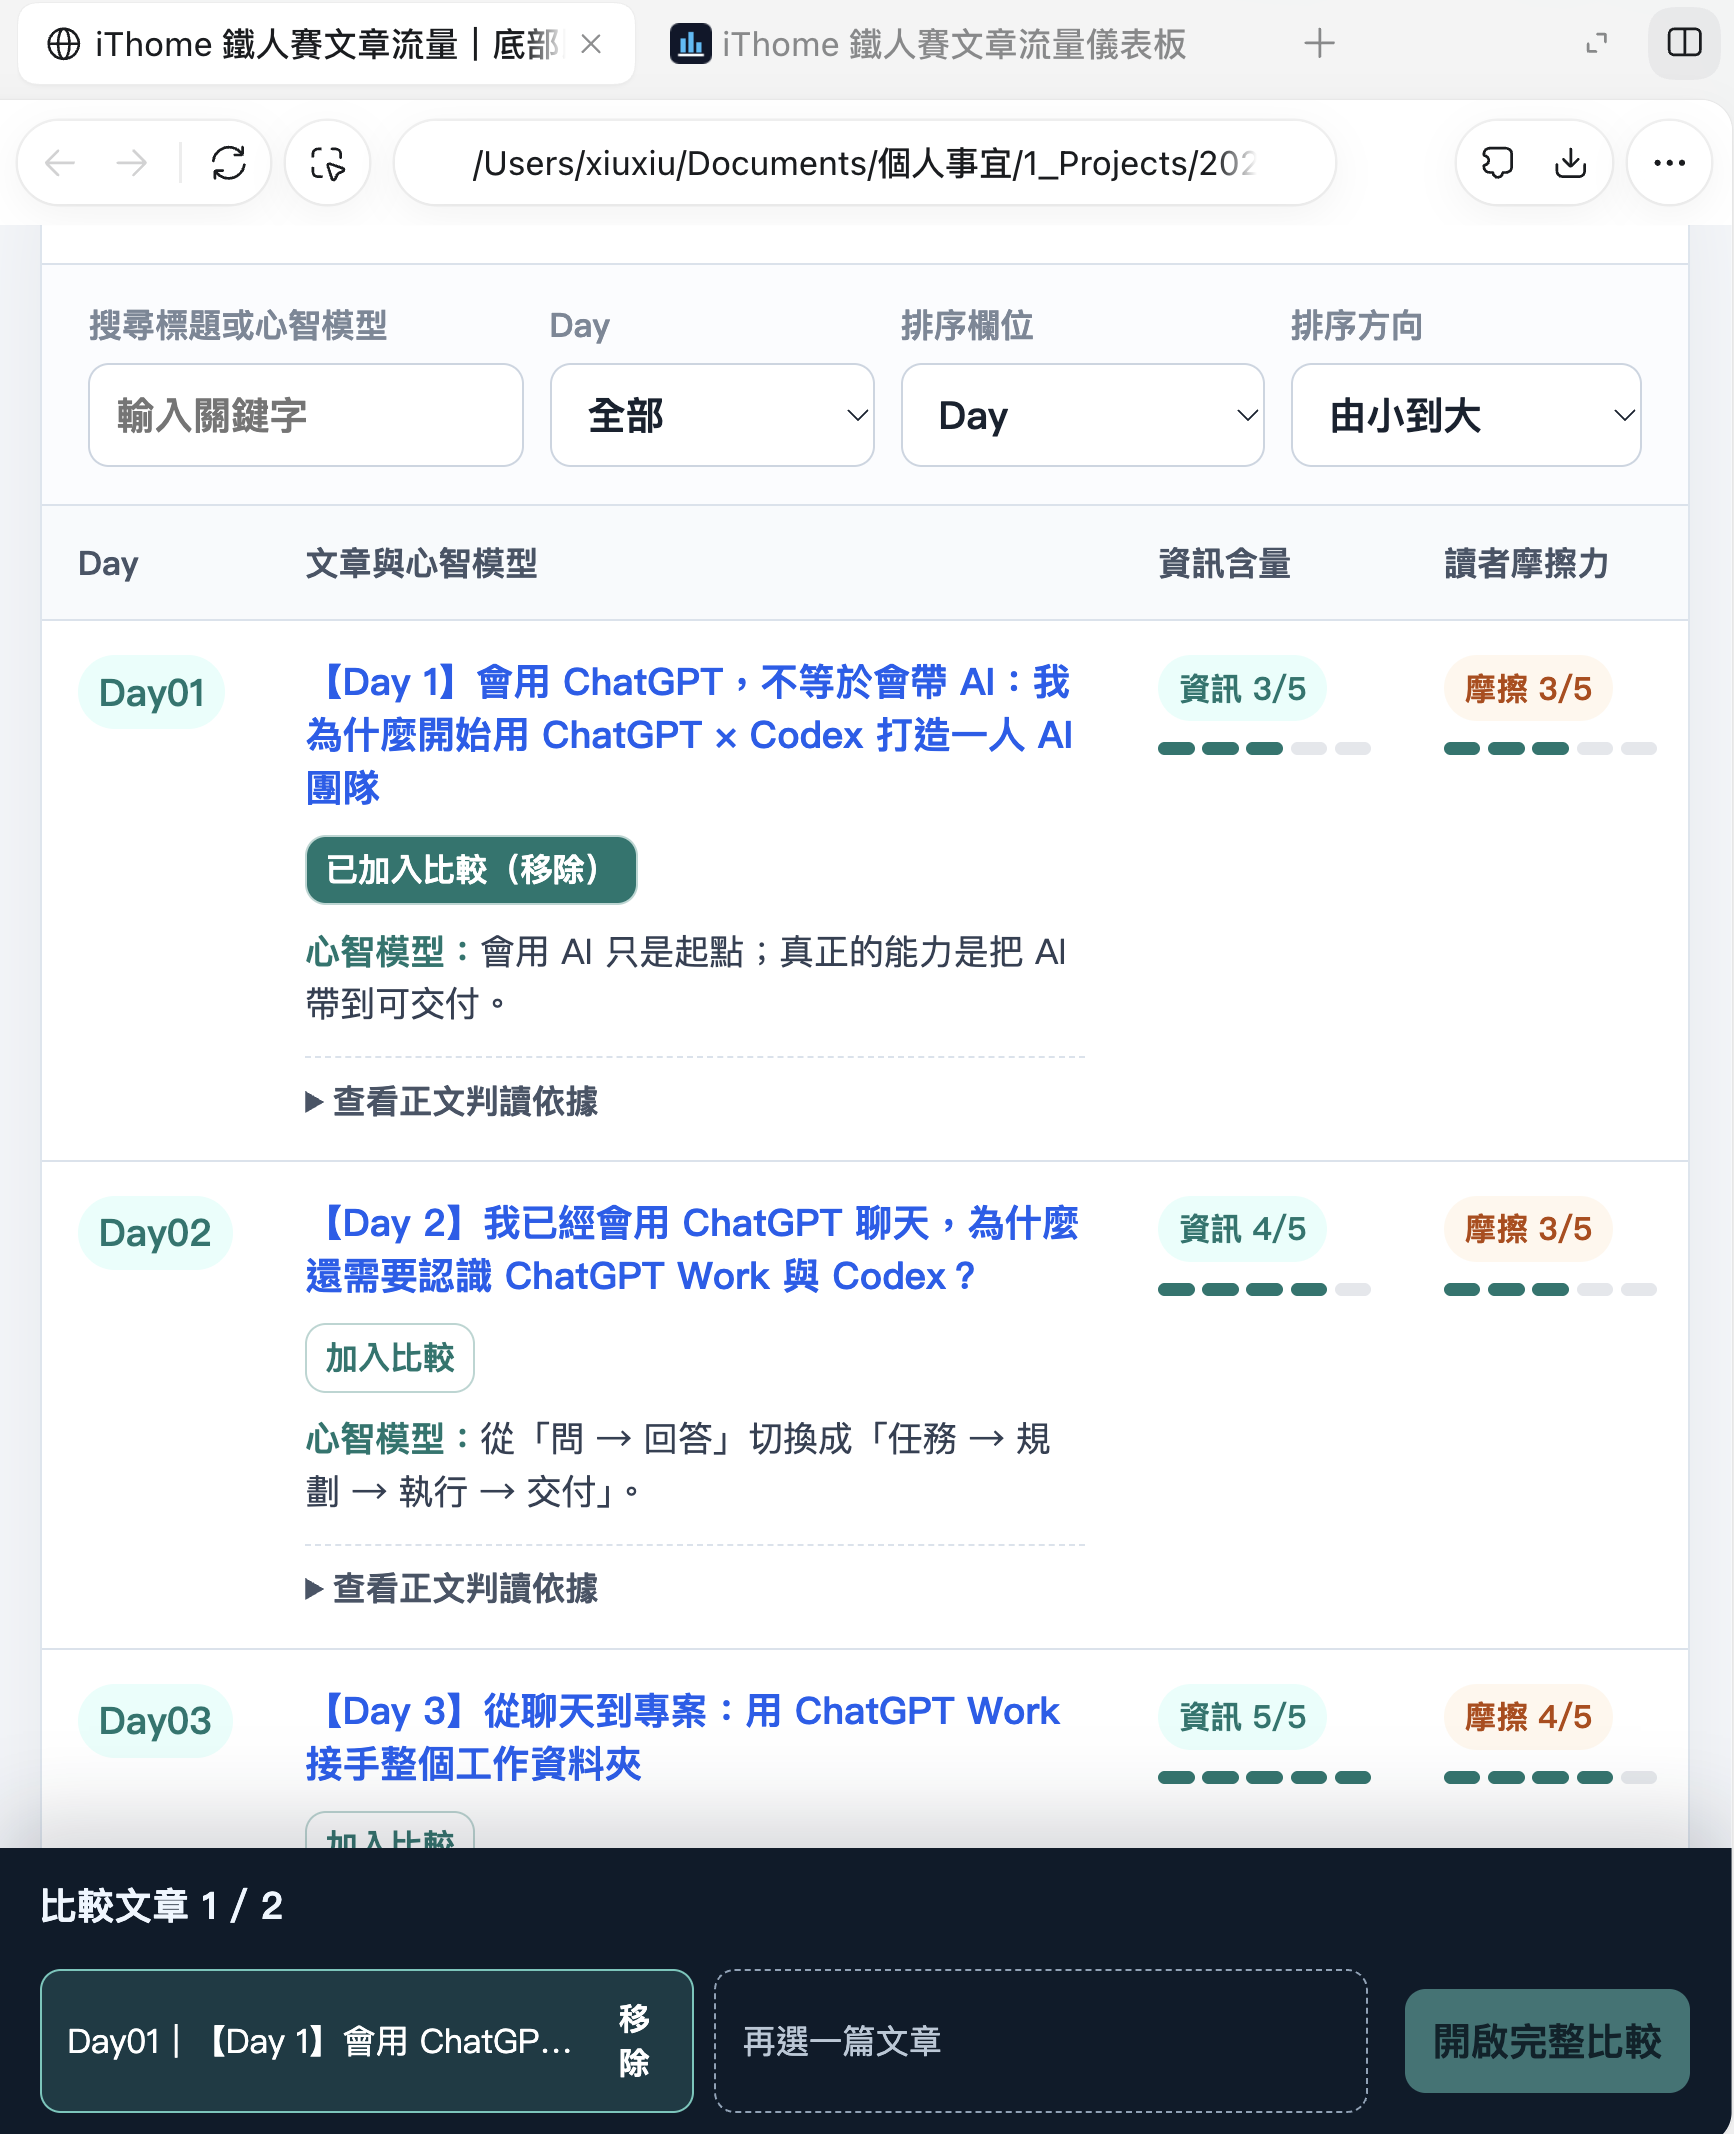
〔截圖:底部比較列(Comparison Tray)版本。畫面可看到目前已選 1 / 2 篇、移除、第二篇空位與「開啟完整比較」。〕
第二個方案把比較入口收進頁面內容。畫面只顯示已選數量與「開啟比較」,完整內容需要時再用彈出視窗呈現。主畫面得到更多空間,比較內容也集中在單一區域;相對地,使用者多了一次開啟動作,在視窗還沒打開前,已選文章也沒有底部比較列那麼醒目。
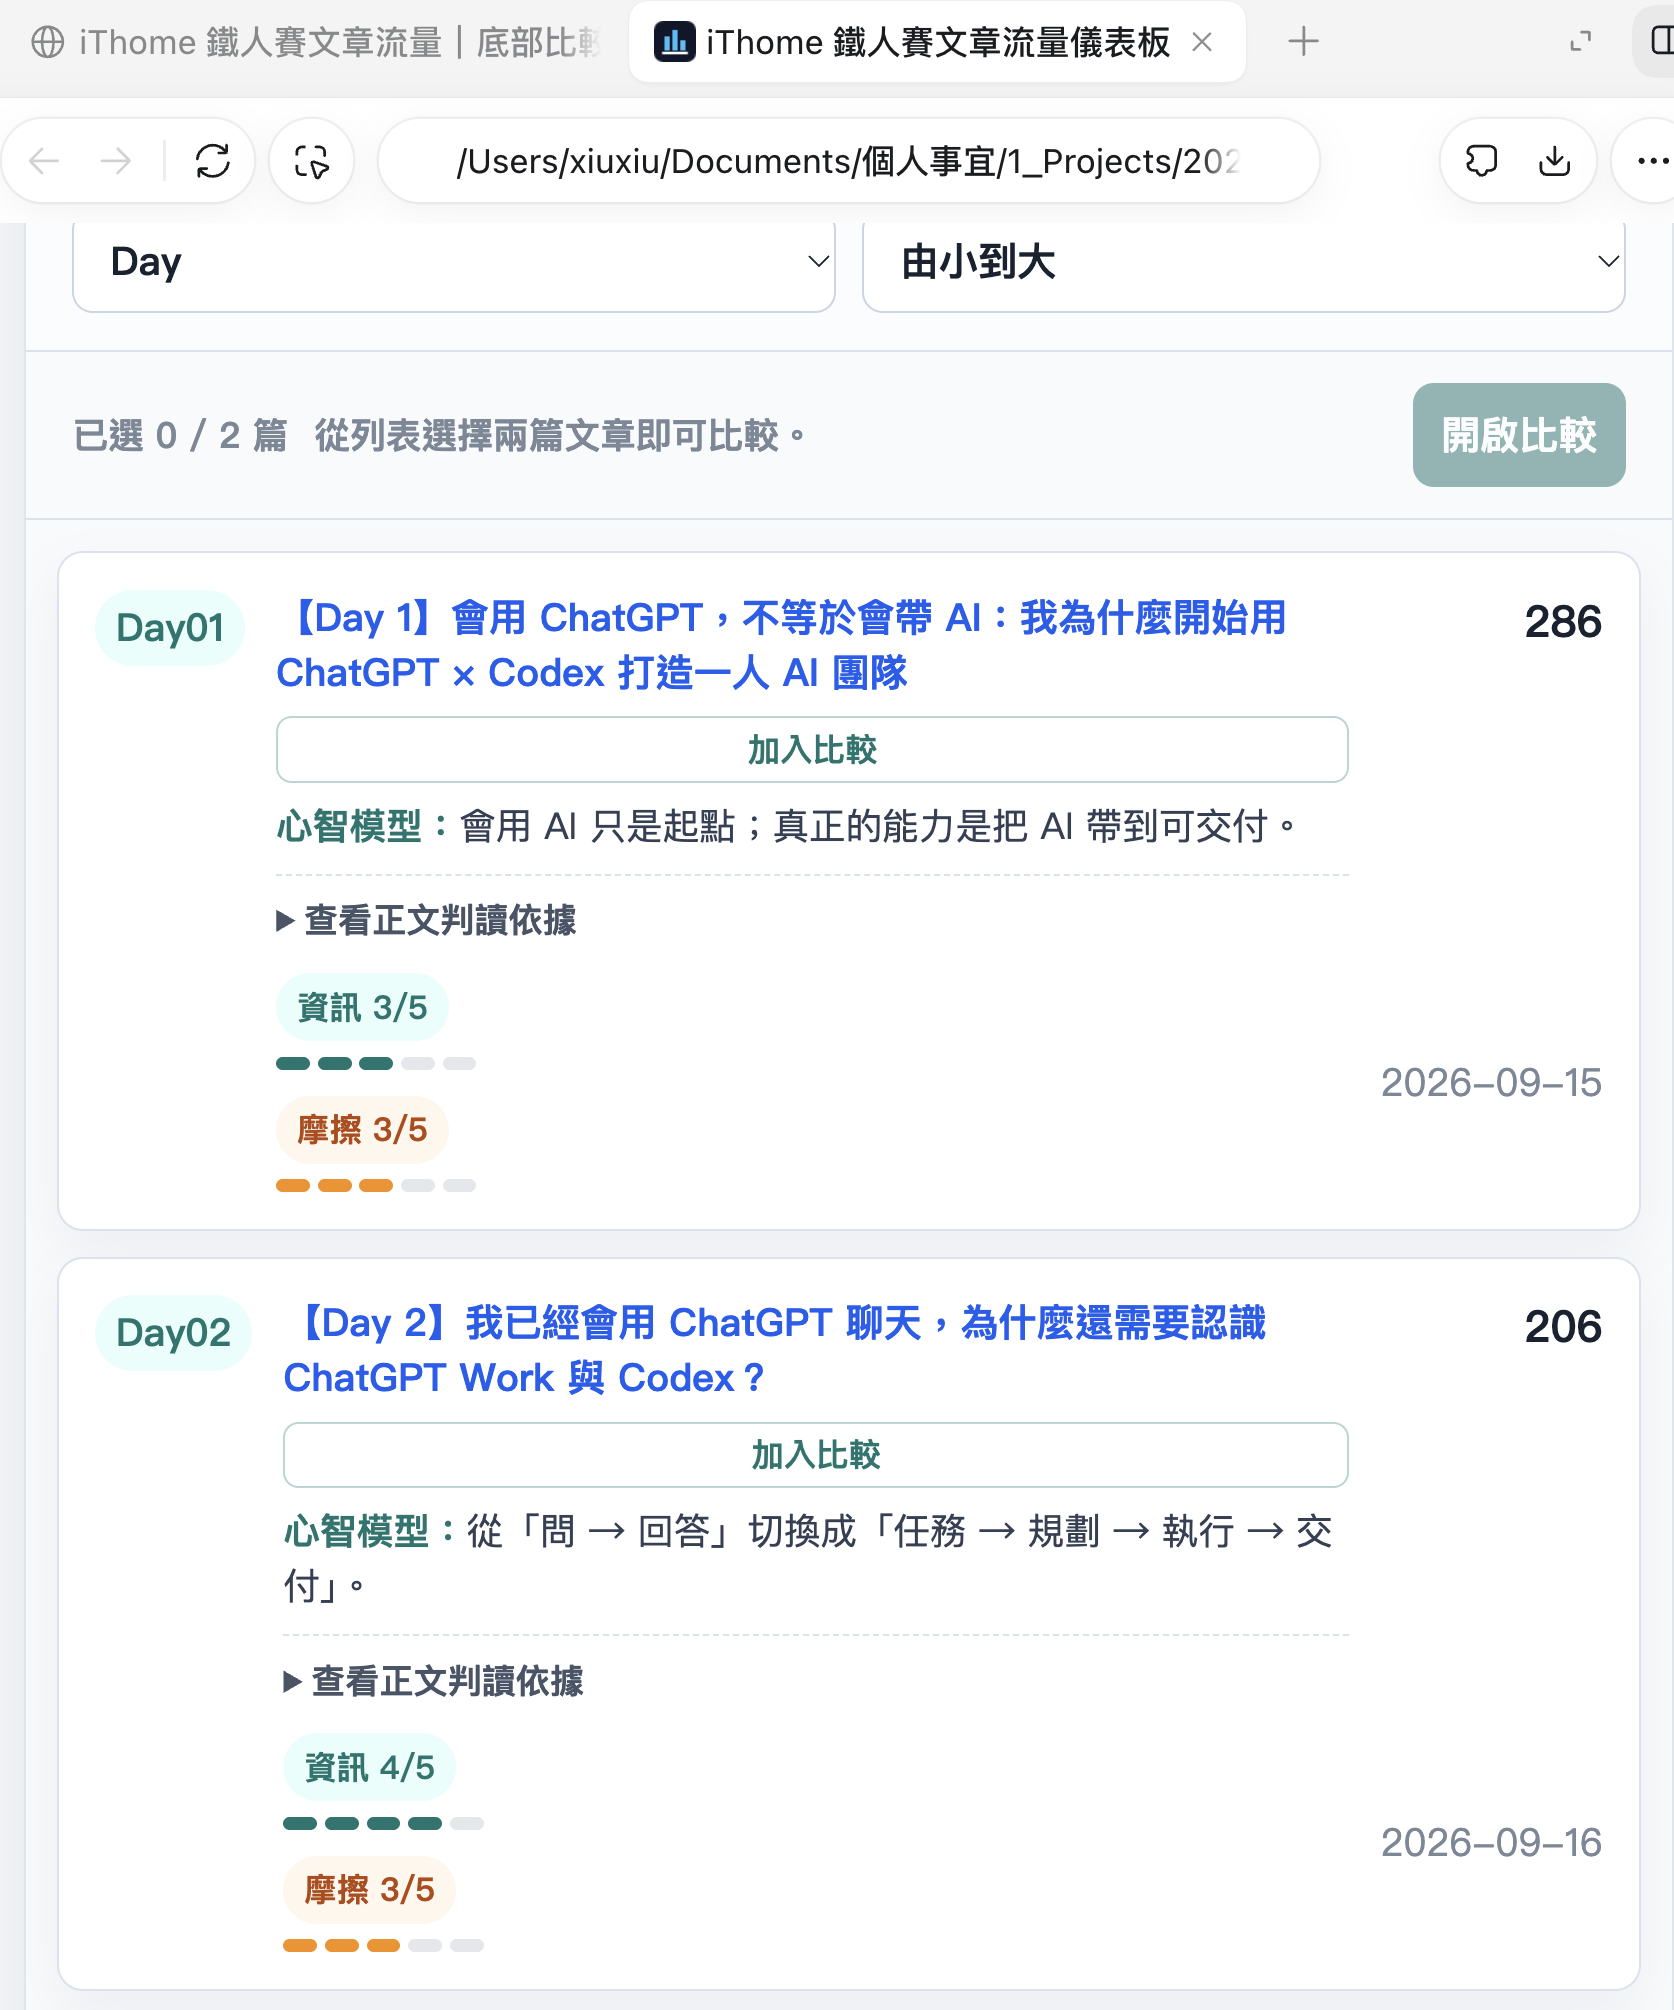
〔截圖:彈出視窗版本的文章列表。保留「已選 0 / 2 篇」、「開啟比較」與每篇文章的「加入比較」。〕
這次平行 AI 代理(Parallel Agents)的價值落在「探索」。同一個產品問題,同時得到兩個可以實際操作的版本。我最後比較的是互動成本、畫面占用與手機使用方式,再決定哪一種取捨(trade-off)適合這個儀表板。
人的工作也往上移了一層。第一個任務裡,我定義功能與驗收條件;第二個任務裡,我開始定義「哪些方向值得同時探索」,再把選擇留到結果出現之後。
委派 → 探索 → 比較 → 決策
這時,「指揮中心(Command Center)」就不再只是產品頁上的名詞。OpenAI 把 Codex 描述成支援多代理工作流程(multi-agent workflow)的代理式程式開發指揮中心;不同 AI 代理可以在分開的任務對話串中工作,並透過獨立工作區隔離同一個程式碼儲存庫上的修改。
在這次實作裡,我能直接確認的是:我用一次提示詞要求多個 AI 代理探索兩個方案,Codex 最後交回兩個分開的版本,正式版本保持原狀。這已經足以讓「指揮中心」從抽象概念變成可觀察的工作方式。
回到 ChatGPT Work 和 Codex 的比較,現在可以把差異畫得更清楚。
ChatGPT Work 接到任務後,常沿著資料、搜尋、分析與工具操作,把工作收斂成文件、試算表、報告或網站等交付成果。Codex 接到軟體任務後,則持續讀取系統狀態、修改、執行、取得回饋,再決定下一步;當問題還有多種解法時,也可以把不同方向分開探索,再把結果交回來讓人選擇。
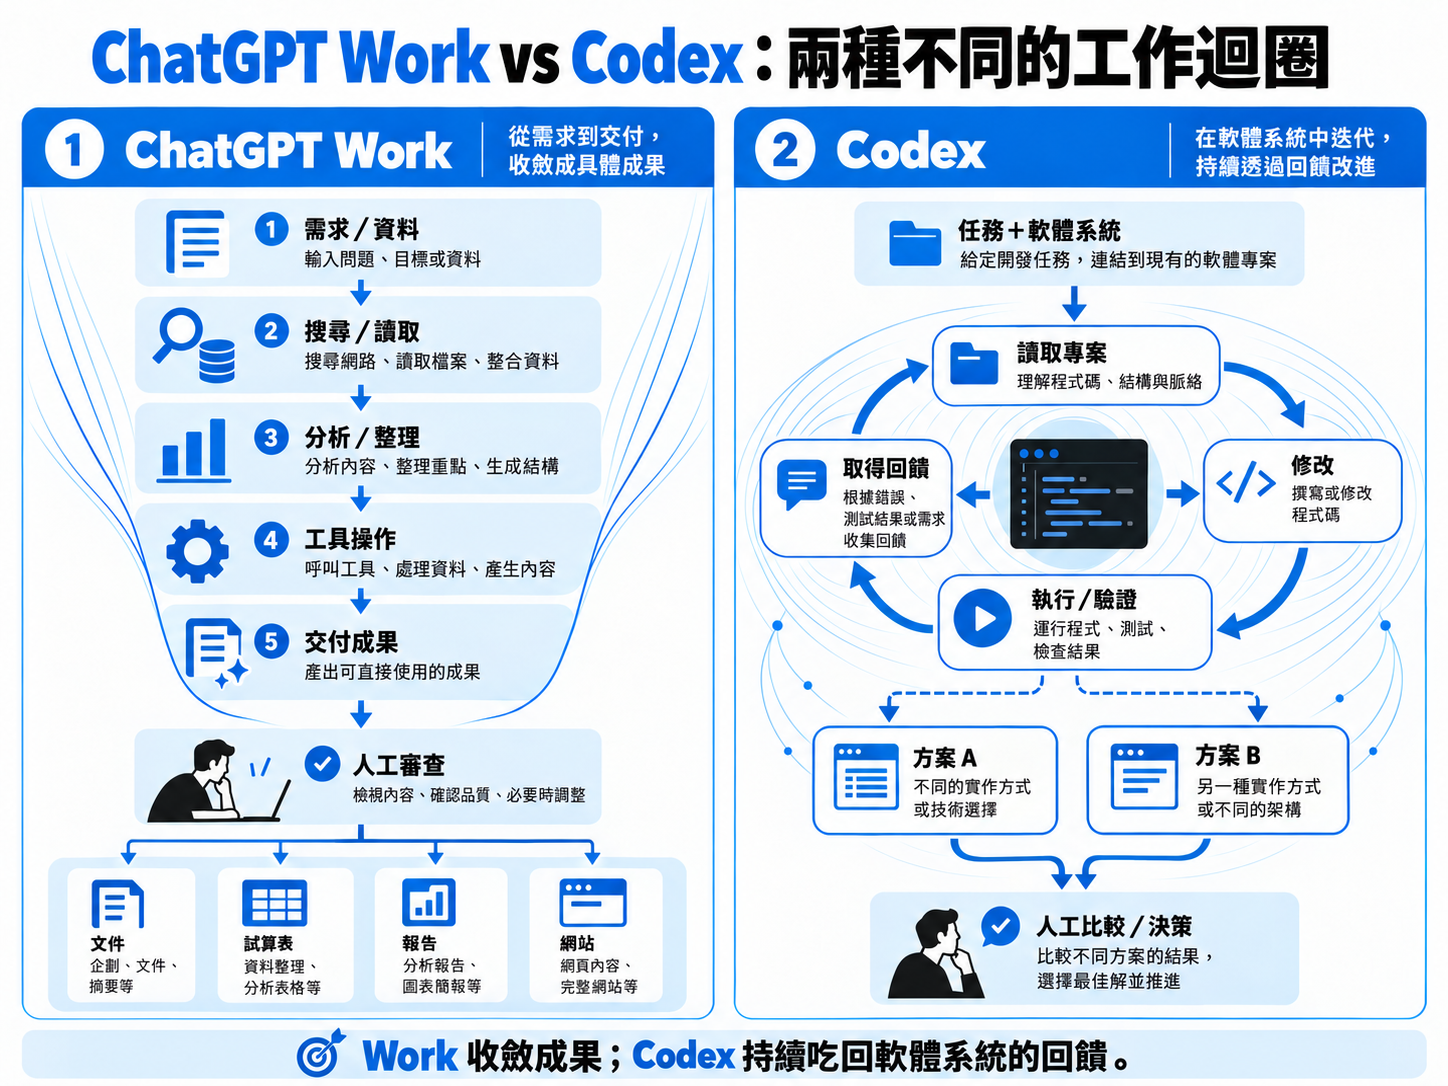
〔圖解:ChatGPT Work vs Codex 雙軌工作流。左側從「需求/資料」經搜尋、分析、工具操作,收斂到交付成果,再由人工審查。右側從「任務+軟體系統」進入讀取程式碼儲存庫、修改、執行/驗證、取得回饋;若需要探索方案,再分成 AI 代理 A/AI 代理 B,最後回到人工比較/決策。右側保留明顯的回頭箭頭,呈現軟體工程的驗證循環。〕
ChatGPT Work 圍繞任務與交付成果推進;Codex 圍繞可執行、可驗證,也能平行探索的軟體工程工作推進。
這次案例真正留下來的,也不是某一個按鈕怎麼用,而是 Codex 如何把修改、驗證、方案探索與人的決策放進同一個工作循環。人沒有從流程裡消失,只是把注意力從「每一行怎麼寫」移到「要改什麼、怎樣算完成、哪些方向值得探索,以及最後要留下哪一個」。
判斷 ChatGPT Work 與 Codex,可以先看任務主要依靠哪一種回饋推進。
當工作需要蒐集資訊、操作工具、分析資料,再收斂成一份可交付成果時,ChatGPT Work 的工作模式較容易理解;當任務存在於程式碼儲存庫之中,而且結果可以透過測試、建置、終端機、瀏覽器或實際操作反覆驗證時,Codex 的工程迴圈便開始發揮作用。如果問題還存在多種合理解法,多代理工作流程還能把不同方向分開實作,讓人先看到可以操作的結果,再決定保留哪一條路。
因此,Codex 帶來的改變不只發生在「AI 會不會寫程式」。更關鍵的是,人與 AI 協作的工作單位從逐行指示,逐漸轉向任務、限制、驗收條件與決策。AI 代理負責在軟體系統裡讀取、修改、執行與驗證;人負責定義問題、判斷取捨,以及決定最後要留下什麼。
用一句話收斂本文:ChatGPT Work 圍繞任務與交付成果推進;Codex 圍繞可執行、可驗證,並能平行探索方案的軟體工程迴圈推進。


 iThome鐵人賽
 看影片追技術