
摘要
Codex 已經能走進程式碼庫,閱讀檔案、修改程式、執行指令,再用測試確認結果。當這套能力開始進入真正的專案,我遇到的問題也跟著改變:有些決策從來沒有寫在程式碼裡。產品規則、團隊慣例、架構理由與驗收條件,往往散落在人的記憶、會議與過去的討論中。這篇從鐵人賽流量網站的一個小功能出發,追著「熱門文章到底怎麼算」這個問題往專案深處走。我把途中遇到的知識整理成 L1~L6 六層,試著回答一件更長期的事:當 AI 開始參與軟體開發,我們該怎麼把一個專案寫到足以讓下一個 Agent 接手?
前幾天整理鐵人賽流量網站時,我想到一個很小的修改。網站已經會把每篇文章做成卡片,顯示標題、瀏覽數與文章分析,我想再往前一步,在表現特別好的文章旁邊加上一個「熱門」標記。如果放在以前,我大概會直接打開元件開始寫;現在整個專案已經交給 Codex,我只需要交代一句:「幫我在文章卡片加入熱門文章標記。」
需求看起來已經很完整。Codex 找得到文章卡片,也知道瀏覽數放在哪個欄位,新增一個標籤本身幾乎沒有技術難度。真正讓工作停下來的,是程式開始之前的一個問題:什麼叫熱門?瀏覽數最高的前三篇可以算,超過一千次也可以算,甚至可以讓門檻隨著整體文章流量動態變化。三種方法都寫得成程式,也都能正常顯示一個「熱門」標籤,但它們代表的是三套不同的產品規則。
原始碼無法替 Codex 決定哪一種才對,因為答案根本還不在原始碼裡。這件事讓我重新看待前幾天一直在談的 Agentic Coding。當 Codex 的能力還停留在「幫忙寫一段程式」時,我們很自然會把注意力放在模型會不會寫、會不會除錯、能不能執行測試;能力繼續往前推之後,它開始讀取整個 repository,跨檔案修改功能,也能沿著測試結果反覆修正。這時限制它的,往往已經不是下一行程式怎麼寫,而是專案有沒有留下足夠的線索,讓它知道這行程式為什麼應該這樣寫。
一個軟體專案真正運作時,其實一直存在兩套系統。其中一套看得見:程式碼、資料庫結構、套件、API、測試都放在 repository 裡,只要取得專案就能讀到。另一套則長期存在人的腦中。團隊可能知道介面文字固定使用繁體中文,也知道某個資料夾牽涉部署流程,不適合隨便搬動;某段看起來過度複雜的程式,可能是半年前踩過一次 production 問題後留下的結果;產品經理說「活躍使用者」時,大家也知道它有一套固定定義。
這些知識很少一次寫完。人加入團隊後,會從 PR、Code Review、Slack 訊息、會議和前人的提醒裡慢慢把它們拼起來,待得夠久,很多事情甚至不再需要被說出口。Codex 沒有這段共同經驗,它能讀到什麼,就只能從什麼建立對專案的理解。於是原本只用來方便人查閱的文件,開始進入另一條工作路徑:當 Agent 會閱讀文件,再根據裡面的規則修改程式,文件裡的一句話已經可能影響下一次實作。
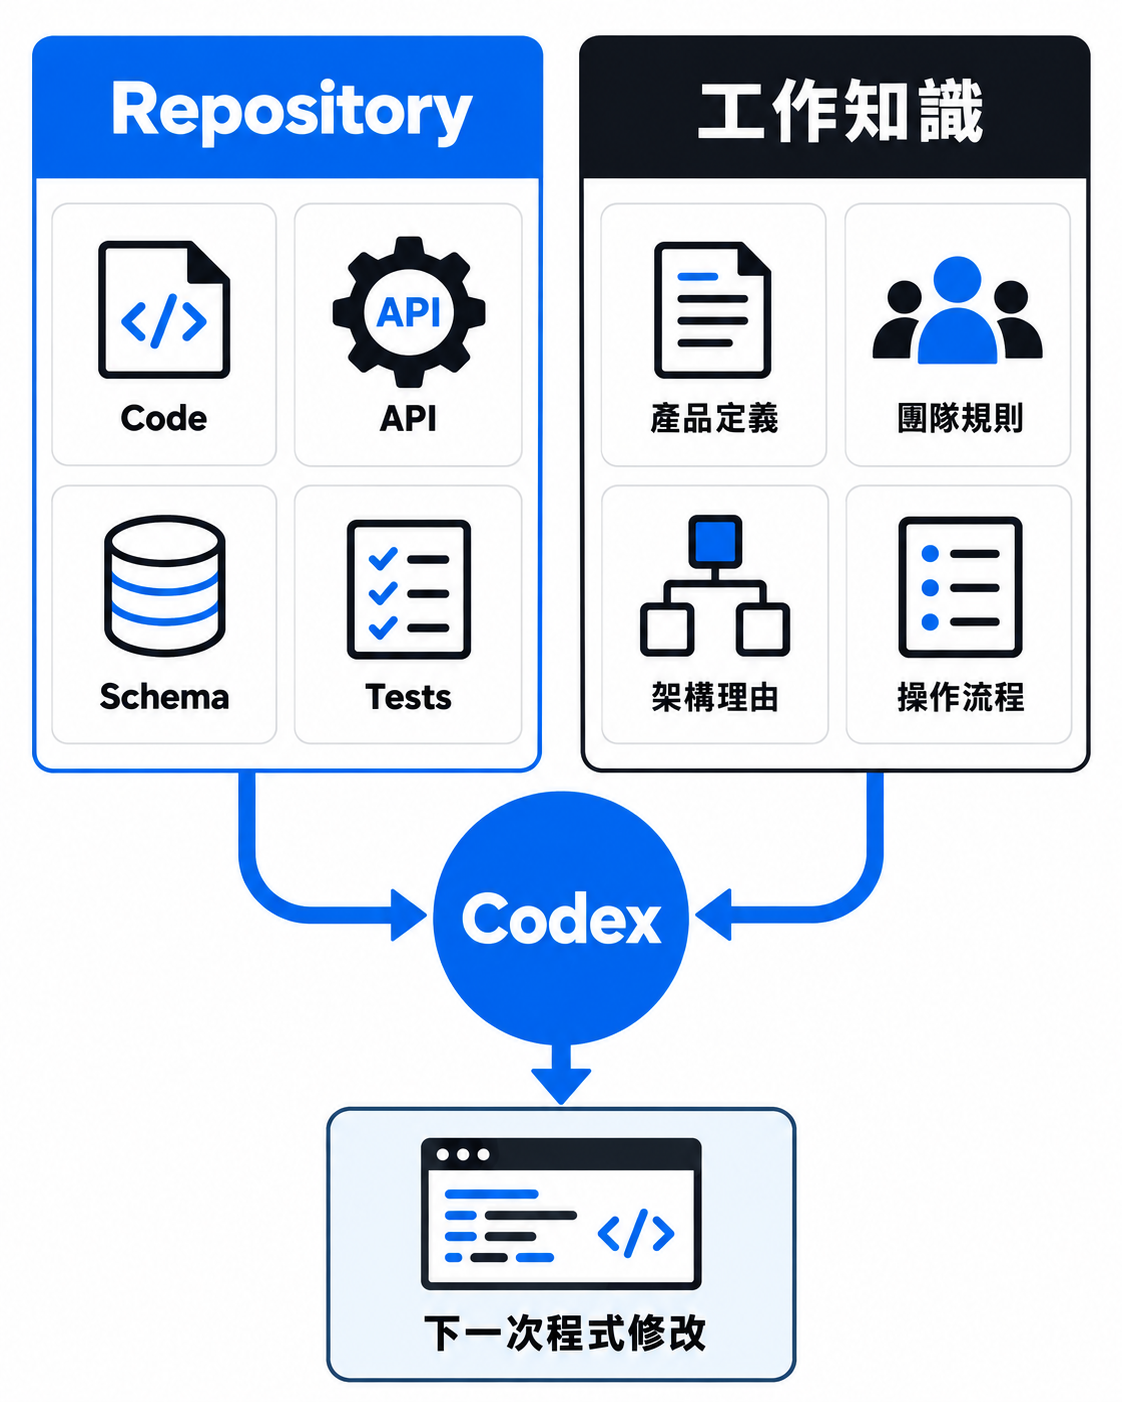
〔圖 1:程式碼之外,還有一套專案知識系統〕
Day 4 寫 AGENTS.md 時,我把它稱作 AI Agent 的「入職懶人包」。現在回頭看,這個比喻只說中了入口。真正的專案長大以後,需要保存的知識遠比一份入職文件複雜。有人需要先知道這個專案在做什麼;有人需要知道進來以後有哪些工作規矩;碰到產品邏輯時,又得知道某個詞真正代表什麼。再往下,還會遇到曾經做過的重要技術選擇、反覆執行的操作流程,以及修改完成後要用什麼方法判斷結果。
我後來試著依照「一個 Agent 進入專案後,會在什麼時候需要這些資訊」重新排列,最後得到六個層次。
| 層級 | 它保存的知識 | 典型形式 |
|---|---|---|
| L1 專案地圖 | 這是什麼專案,重要東西在哪裡 | README、ARCHITECTURE、文件索引 |
| L2 工作規則 | 在這裡工作時要遵守什麼 | AGENTS.md、路徑規則 |
| L3 領域與規格 | 功能做到什麼程度才算正確 | 產品規格、術語、API、Schema |
| L4 可重複流程 | 這類工作平常怎麼執行 | Skill、Runbook |
| L5 決策記憶 | 當初為什麼走到現在這個設計 | ADR |
| L6 可執行驗收 | 哪些條件不能被破壞 | Tests、CI、Schema、Evals |
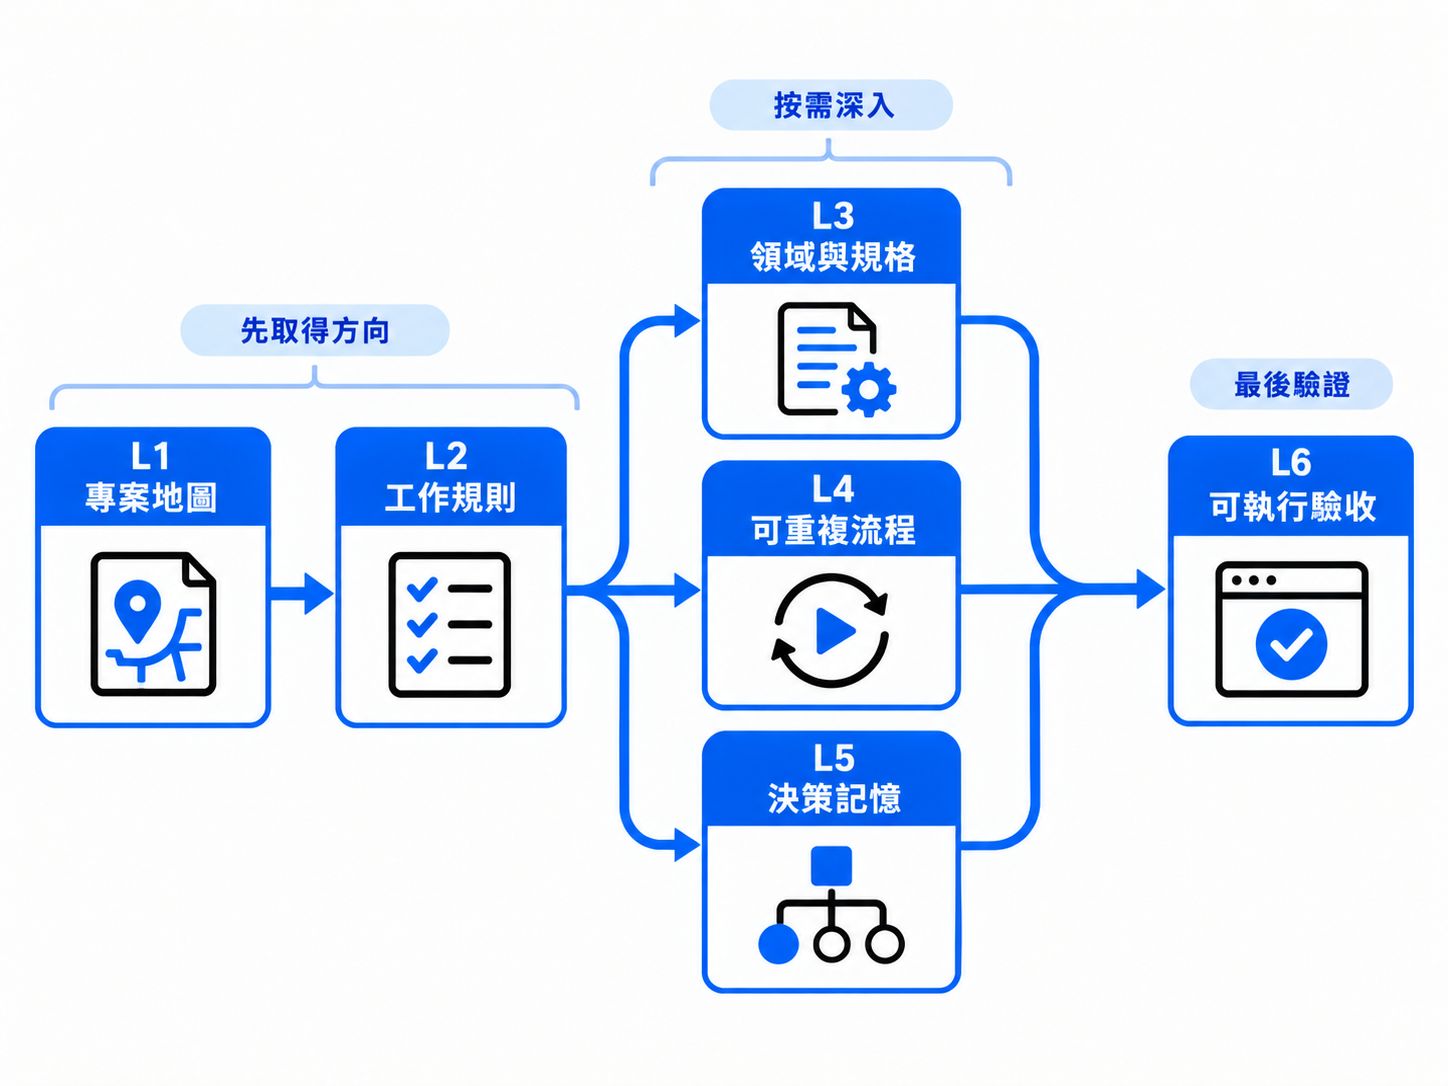
〔圖 2:Codex 如何沿著六層專案知識閱讀〕
我刻意把它稱作「六層」,而不是六個成熟度階段。專案不需要從 L1 升級到 L6,也不存在寫滿六層就比較先進這件事。這張圖更接近一張閱讀地圖:Codex 先取得方向,碰到問題後再往真正保存答案的位置走。這個區別很重要,因為如果不知道資訊應該住在哪裡,我們很容易在找到一個好用的入口之後,把所有東西都往裡面塞;AGENTS.md 就很容易走到這一步。
假設我的鐵人賽網站有這樣一份 AGENTS.md:
# Project instructions

- 所有介面文字使用繁體中文(台灣)。
- 除非任務需要,不新增套件依賴。
- 修改文章指標或排行邏輯前,先閱讀 docs/product-rules.md。
- 完成修改後,執行目前專案既有的測試與建置檢查。
這份文件沒有解釋「熱門文章」怎麼算,它只留下一條路。當 Codex 開始處理文章指標,第三條規則會把它帶到 docs/product-rules.md,到了這裡,才會真正看到產品定義:
## 熱門文章

熱門文章以目前已發布文章的瀏覽數中位數作為基準。

當單篇文章瀏覽數 >= 全部文章瀏覽數中位數的 1.5 倍時,
顯示「熱門」標記。
同一個需求因此穿過了兩種完全不同的知識。AGENTS.md 告訴 Codex 怎麼工作,product-rules.md 告訴它什麼結果才符合產品定義。這個區別看起來很細,卻決定了專案變大之後還能不能維持閱讀秩序。如果我把熱門文章的完整算法直接塞進 AGENTS.md,今天修改文章卡片確實很方便;下次只是調整導覽列,Codex 進入專案時仍然得把這套算法一起帶進上下文。規則越積越多,入口文件就會逐漸長成另一份大型規格書。
我真正希望留下的是一張地圖。入口只需要指出方向,詳細知識待在最接近它用途的位置。L1 和 L2 因此適合保持短,它們先建立方向感,告訴 Agent 這是什麼專案、在哪裡工作、遇到某類問題該去哪裡找答案;碰到功能定義,再進入 L3。繼續往下時,文件的角色又會改變。
例如我每次發布鐵人賽文章,都要抓取最新數據、更新資料、重新產生網站,再檢查結果。當這套動作重複出現,我就可能把它整理成 Skill 或 Runbook。這類文件保存的已經不是一項產品定義,而是一條可以再次執行的工作流程,放在 L4 比較合理。有些知識則來自時間。專案做久之後,後來的人會看到一些很難理解的選擇:為什麼資料存放方式這麼繞?為什麼兩個看似可以合併的模組刻意分開?當初是不是沒有想到更簡單的方法?
如果答案只存在半年前某場會議裡,新的工程師和 Codex 都可能重新走一次舊路。這時 ADR(Architecture Decision Record,架構決策紀錄)才有價值。它保存的不只是最後採用了什麼方案,也留下當時面對哪些限制、評估過哪些方向,以及這個決定為什麼值得延續,這些內容構成 L5 的「決策記憶」。
「熱門文章採用中位數 1.5 倍」顯然不需要走到這裡。這條規則修改成本低,也沒有留下重大架構後果,一份產品規格已經足夠。六層開始變得有用的地方,正在這種判斷裡。它不會逼我替每一個需求多建立五份文件,而是讓新的知識出現時,我可以先判斷:這件事究竟希望下一個人知道什麼?知道內容的用途,才知道它該住在哪裡。
這樣做還帶來一個很實際的結果:專案文件不需要全部常駐在 Context 裡。常用、短小、影響所有工作的規則留在入口;高度專門的內容待在自己的文件,需要時才被讀取。當 repository 開始累積大量知識時,這種閱讀順序也能避免每個任務一開始就吞下與自己無關的資訊。文件因此慢慢形成一條路徑,而不是一座倉庫。
做到這裡,「熱門」已經有了清楚的產品定義:當單篇文章瀏覽數大於或等於所有文章瀏覽數中位數的 1.5 倍,就顯示熱門標記。這句話對人已經夠清楚,對軟體系統還可以再往前一步。假設目前所有文章的瀏覽數中位數是 100,149 不應該出現熱門標記,150 應該出現;某天重新設計文章卡片時,修改 CSS 或元件結構也不應該順手改掉這條判斷。這些條件可以直接進入測試。
median = 100

views = 149 → false
views = 150 → true
到了這一步,專案對「熱門」的理解第一次跨過一條界線。前面的文件都在描述知識,L6 開始讓其中一部分知識可以被執行。Codex 修改完程式後,不必靠一句「我認為已經符合需求」結束工作;測試會重新跑過產品規則裡最重要的邊界。如果新的實作讓 149 也被判定成熱門,系統會直接失敗。
這讓我開始理解文件與測試之間的關係。一條規則最早可能只是團隊口頭上的共識,接著被寫進產品文件,成為可以被人與 Agent 閱讀的定義;當其中一部分再被轉成測試,它開始具備另一種力量:未來的修改可以被這條規則拒絕。知識不再只告訴開發者以前怎麼想,它開始參與之後的開發。
回頭看這次「熱門文章」的需求,其實只用了六層裡的三層。L2 的 AGENTS.md 告訴 Codex 去哪裡找文章指標的規則,L3 的 product-rules.md 定義什麼叫熱門,L6 的測試守住 1.5 倍的邊界。
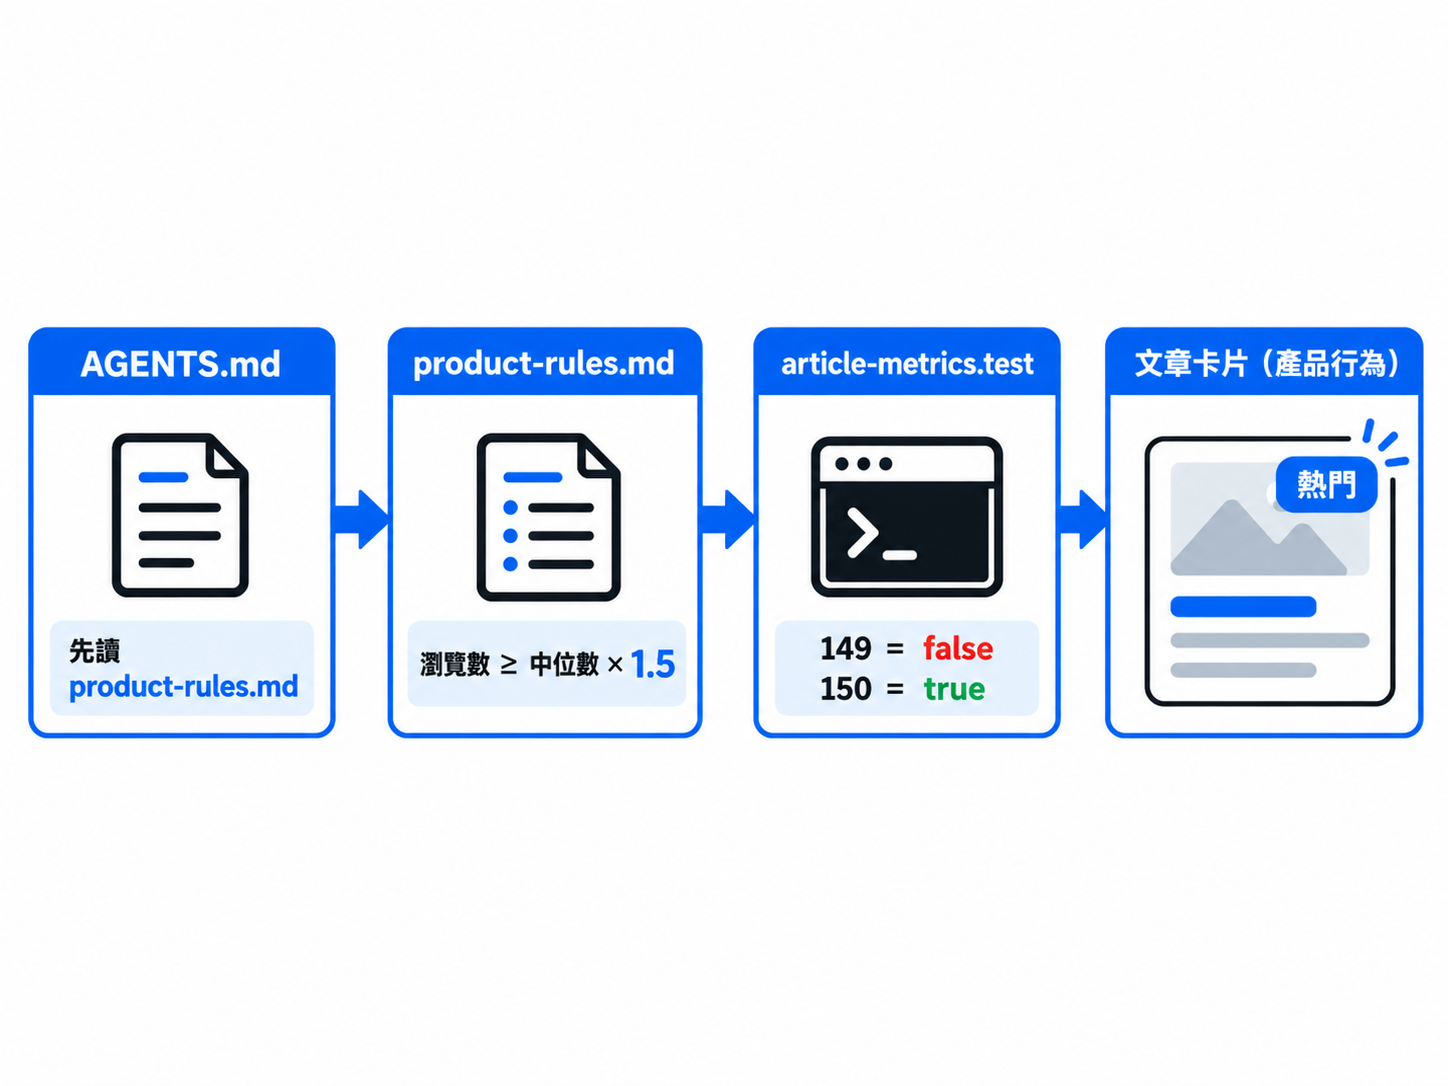
〔圖 3:一條「熱門文章」規則如何穿過三層〕
最後的檔案結構很小:
AGENTS.md

docs/
└── product-rules.md

tests/
└── article-metrics.test.*
這裡沒有 Skill,也沒有 ADR,因為這個功能沒有需要反覆執行的特殊工作流程,也沒有產生值得保存多年的架構決策。建立更多文件不會讓專案變得更完整,只會增加下一次要維護的東西。到這裡,我反而更確定六層模型真正想解決的問題:它關心的從來不是一個專案應該有幾份文件,而是知識應該被留下在哪裡,下一次工作才找得到。
把這些東西放進 repository 之後,我再次回到一開始的任務。
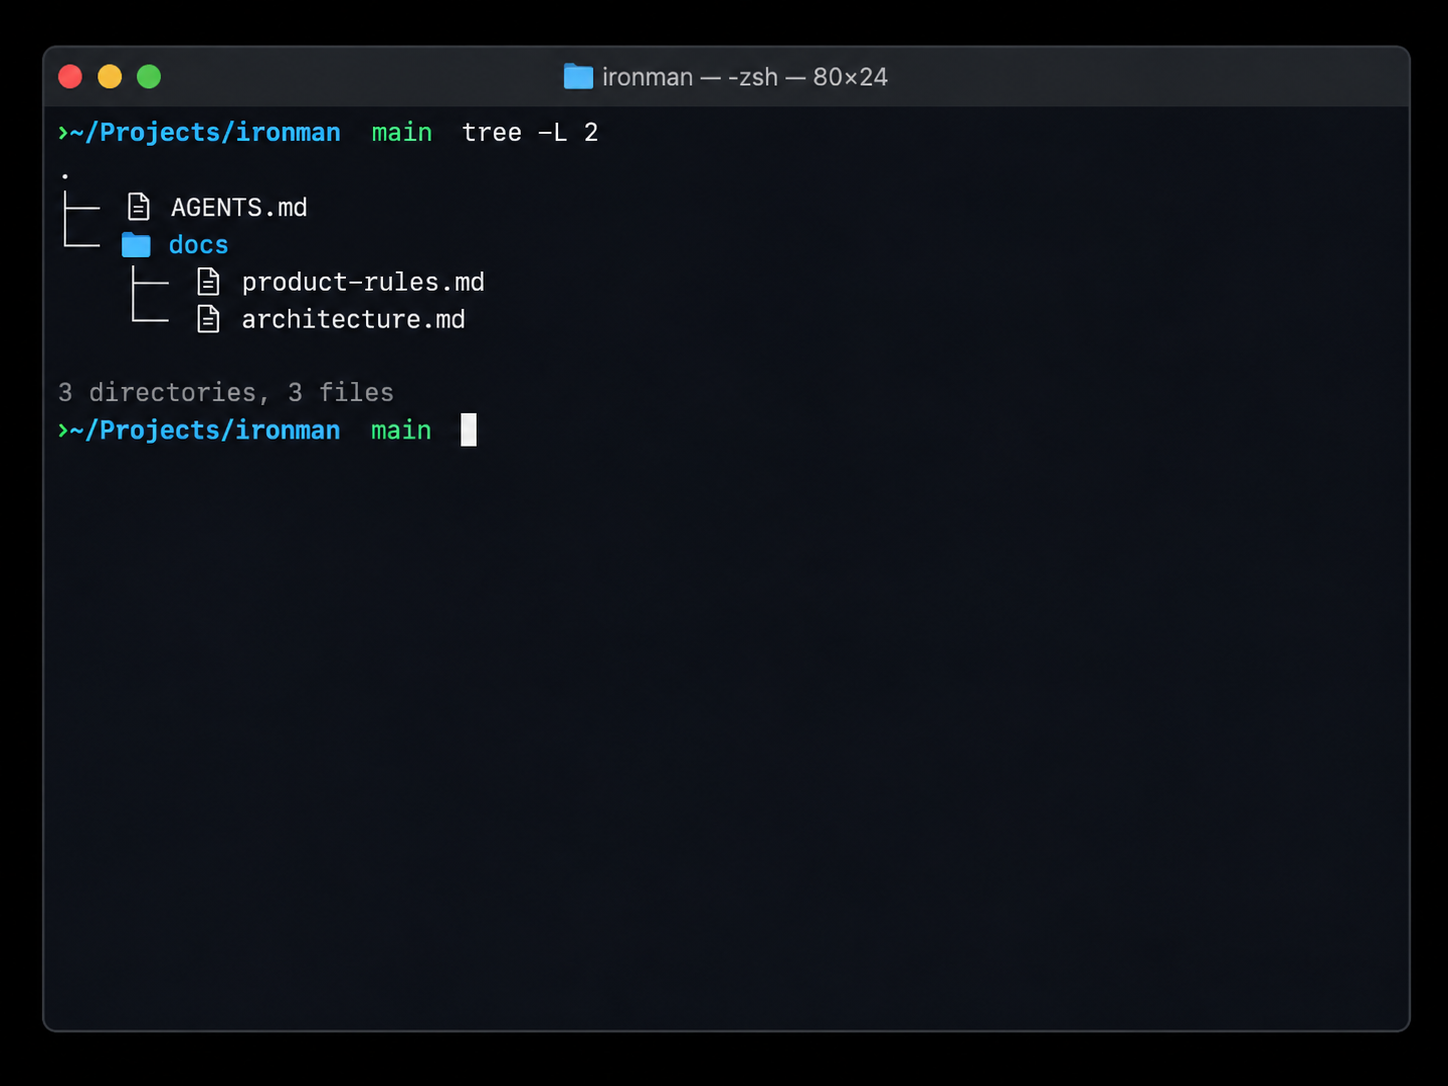
〔圖 4:專案檔案樹〕
這次交給 Codex 的 Prompt 仍然很短:
請在目前的鐵人賽文章卡片加入「熱門文章」標記。

請沿用現有專案的設計與程式結構,
完成後檢查畫面,並執行既有測試。
我沒有把熱門文章的演算法再貼一次,也沒有重新說明專案的語言、檔案結構或驗收方式,因為這些內容已經存在工作環境裡。Codex 進入專案後,可以先讀到 AGENTS.md,沿著裡面的指示找到產品規格,再根據規格修改文章指標,最後執行測試確認結果。
這個案例很小,小到甚至不需要一個複雜的架構,也正因為如此,我才比較清楚看見其中的變化。過去使用 ChatGPT,我一直練習怎麼把更多背景寫進 Prompt:任務是什麼、有哪些限制、輸出格式如何、有哪些事情不能做。每一次新的對話,都像重新替一位陌生協作者介紹工作。Codex 開始進入 repository 之後,有些資訊逐漸可以離開 Prompt:產品定義留在產品文件,工作的普遍規則留在 AGENTS.md,重複流程可以整理成 Skill,重要技術選擇留下 ADR,能被程式判定的底線則交給測試。
它們各自待在最接近用途的位置,再由專案本身提供閱讀路徑。這時 Prompt 能變短,並不是因為工作變簡單了,而是原本塞在一段對話裡的背景知識,開始被移回一個可以長期保存、反覆使用的地方。
Day 4 寫下 AGENTS.md 時,我還把問題想成「怎麼讓 Agent 快速認識一個專案」。做到這裡,問題已經往前走了一層:我要整理的其實是整個工作環境。當新的 Agent 進來,它先知道自己站在哪裡;碰到產品功能,可以找到規格;碰到重要設計,可以追到過去留下的理由;修改完成後,專案本身還能告訴它哪些條件已經被破壞。
這也是我現在理解「文件正在變成 AI 時代的新原始碼」的方式。文件仍然不是程式碼,它不會因為寫進 Markdown 就自己執行;但當 Codex 會閱讀這些文件、依照內容選擇行動,再把決策寫回程式碼時,文件已經進入軟體產生的因果鏈。它會影響 Agent 找哪一份檔案、採用哪一條產品規則、是否敢動某個架構,最後也會影響下一行程式碼怎麼被寫出來。
以前我們花很多力氣,把眼前的問題說清楚。
接下來還有另一種工程工作需要練習:把專案留下來的工作知識,寫到足以讓下一個 Agent 繼續往前。


 iThome鐵人賽
 看影片追技術