
摘要
當 ChatGPT 從聊天工具變成 AI 代理,一則提示詞已經很難代表一次工作。Work 與 Codex 可以在背後讀取上下文、搜尋資料、操作工具、推理,再依結果決定下一步;同樣一句要求,最後可能展開成完全不同規模的工作流程。這也是為什麼使用量不能只靠「今天問了幾次」估算。本文從一次每週使用額度歸零的經驗出發,拆開「使用額度、點數、詞元」三個容易混在一起的概念,再把 AI 用量重新理解成一筆「認知資源預算」:困難的工作可以多花,沒有邊界的探索則應該及早停下來。
最讓我焦慮的,其實不是使用量顯示 0%,而是那一刻,我曉得怎麼消耗量這麼大。
之前初次跟 AI 聊天時,明明沒有跟 ChatGPT 聊上幾百輪。有些工作,我甚至只下了一兩個 Prompt:幫我查資料、讀幾份文件、整理一下結果。
結果某次工作做到一半,我準備叫它繼續,直接沒了。
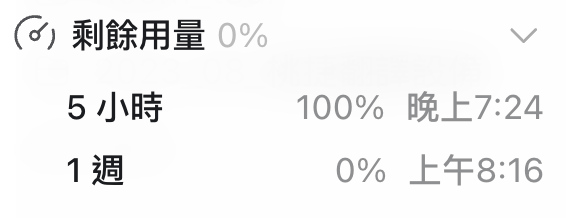
〔截圖 1:ChatGPT 使用量頁面,5 小時使用量剩餘 100%,但每週使用上限剩餘 0%,並顯示下一次重置時間〕
你以為自己只問了一次,Agent 可能已經工作很久了。
所以這篇我解決當時真正想知道的三件事:
我也會拿同一個研究任務做一次對照:一邊讓 AI 代理自由探索,一邊先限制第一輪的搜尋邊界,看看兩條工作路徑到底會差多少。
以前聊天時,我很容易用「今天問了幾次」估計自己用了多少 ChatGPT。到了 Work、Codex,這個算法開始失效。
同樣是一個提示詞,「幫我把這段文字改順」和「讀完這些資料、找官方來源、比較不同說法,再整理成一篇文章」,背後的工作量差很多。後者需要帶著更多前文往下做,也可能要判斷、搜尋、開網頁、讀檔案,找到資料後再繼續下一步。
OpenAI 在官方文件裡會把這些因素分成上下文(context)、推理強度(reasoning)、工具(tools) 等概念。對第一次碰到使用量限制的人,我覺得先不用急著背名詞。把它翻成日常語言,其實就是三件事:AI 這次要記住多少東西、這一題需要想多深、以及它為了完成任務還要出去跑多少步。
像我前幾天研究鐵人賽主題,看起來可能只下了一句「幫我查這個題目」。Work 真正做的事情卻可能是搜尋、打開來源、讀內容、比對,再根據前面找到的東西繼續查。最後我拿到的可能只有兩頁整理,前面其實已經跑過一串工作。
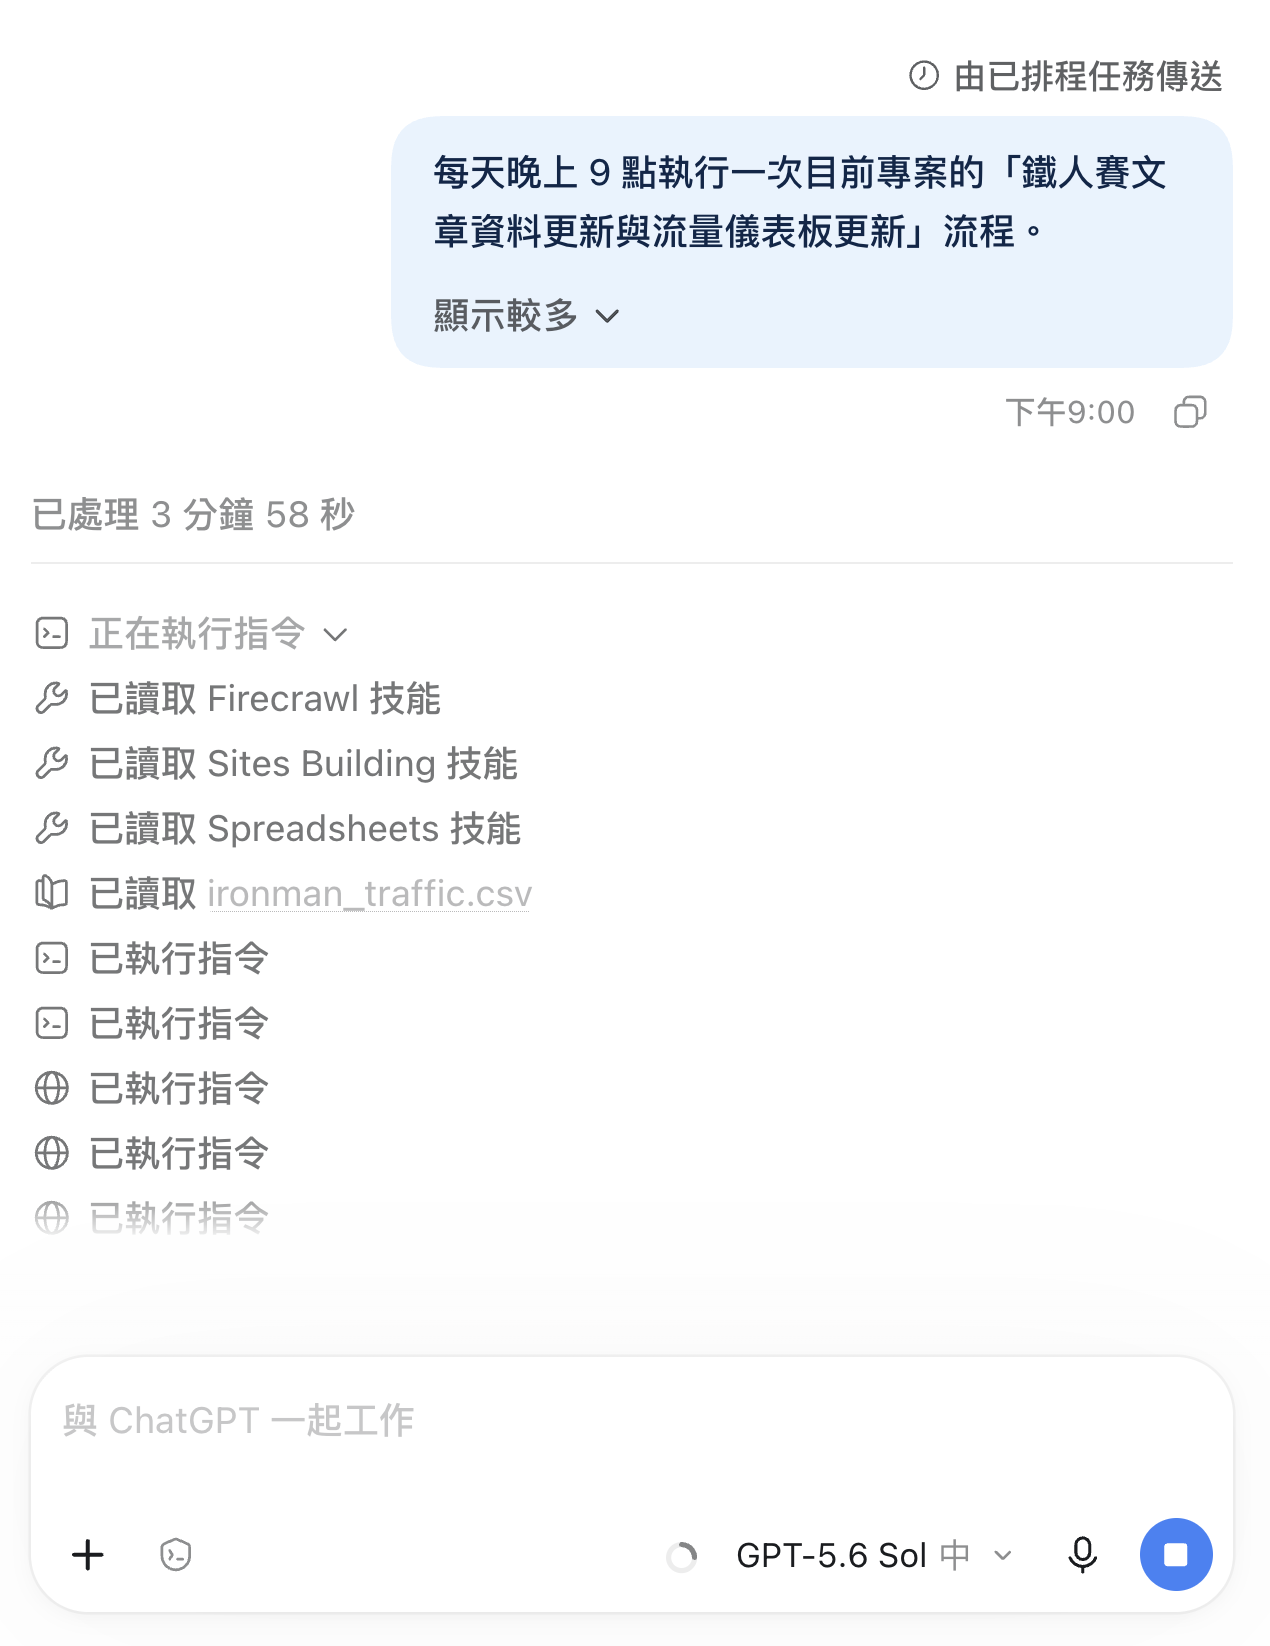
〔截圖 2:實際展開一次 ChatGPT Work/AI 代理任務的執行紀錄,可以看到搜尋、讀取、工具操作與耗時等步驟。〕
所以我現在比較少看提示詞的數量,而會看「這句話裡到底包了多少工作」。研究、篩選、比較、規劃、寫作,如果全部塞在同一個要求裡,它仍然只顯示成一則訊息,但對 Agent 來說已經是一段很長的工作流程。
還有一點要先釐清:使用量頁面的百分比不是「剩餘詞元 數」。依 OpenAI 目前的說明,部分方案中的 Work、Codex 等 Agent 功能會共用額度或點數池,而實際用量又會受到模型、任務複雜度、上下文、推理、速度與工具等因素影響。API 裡可以明確計算的詞元,則是另一套使用與計價概念。
知道這件事之後,我反而不太執著一句提示詞 到底用了幾個詞元。比較重要的是,我交出去的工作有多大。
如果只是統一二十個文章標題的格式,我希望 AI 趕快做完。要是碰到難重現的 Bug、架構取捨,或需要讀很多來源才能判斷的研究,我反而不希望它為了省資源草草回答。
差別在工作的難度,也在錯了之後要付出多少成本。
| 工作類型 | 例如 | 我比較在意什麼 | 使用方式 |
|---|---|---|---|
| 簡單執行 | 改格式、整理欄位、文字轉換 | 快速完成 | 不需要刻意拉高推理 |
| 整理分析 | 比較文件、整理資料、找差異 | 不漏重要資訊 | 給足必要背景,同時限制範圍 |
| 深度推理 | Debug、系統架構、策略判斷 | 判斷品質 | 願意讓模型多想一點 |
| 長時間 Agent 工作 | 研究、跨檔案修改、完成一個專案 | 不要做到後面失控 | 分階段、設停止點 |
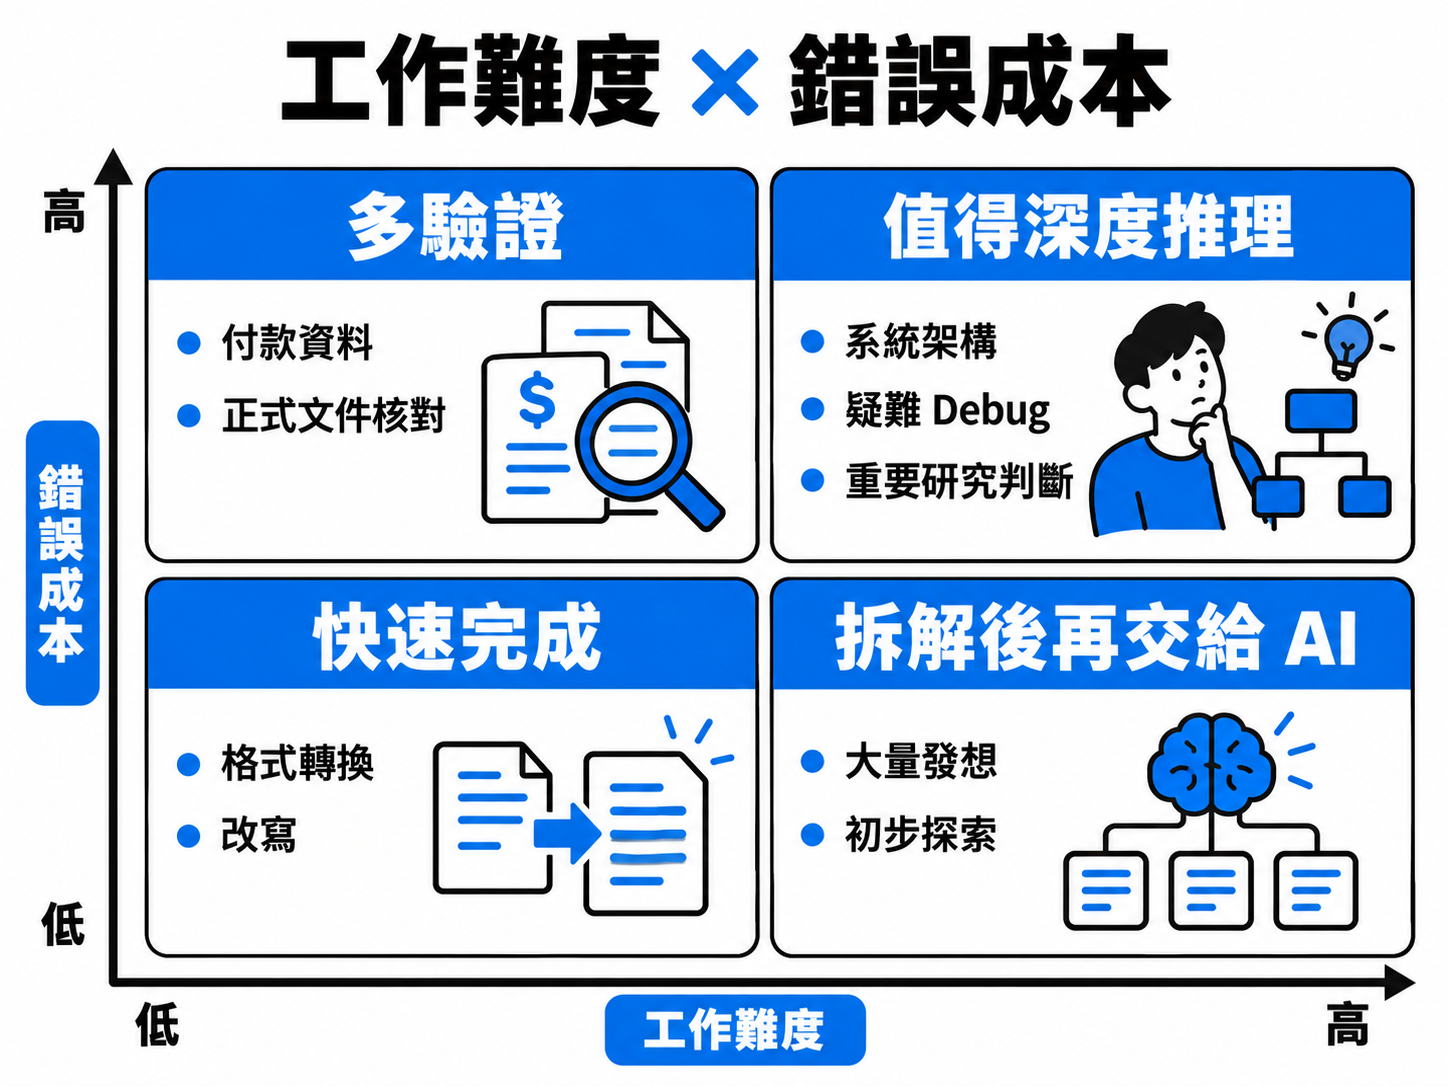
〔圖 3:工作難度 × 錯誤成本 2×2 象限圖。橫軸為「工作難度:低 → 高」,縱軸為「錯誤成本:低 → 高」〕
看到這張表時,我才比較能說清楚自己現在怎麼看詞元。
我會把它當成一筆認知資源預算。
這不是詞元 的技術定義,而是我目前安排 AI 工作的一個方法。簡單工作不用動員太多資源;真的需要判斷的工作,就讓模型多花一點時間。我要避免的,是 AI 不知道我要什麼,只好反覆理解、到處搜尋,最後把資源花在沒有增加多少資訊的地方。
從這個角度看,「省詞元」反而不是最準確的目標。我真正想控制的是:這份工作值得多少 AI 的力氣。
把詞元 當成認知資源預算後,我目前最想養成五個習慣。
| 做法 | 原本容易發生什麼 | 我現在會怎麼做 |
|---|---|---|
| 先圈出任務範圍 | 「幫我檢查整個專案」讓 Agent 自己決定一路查到哪裡 | 指定目錄、目標與停止條件 |
| 長任務分階段 | 研究、分析、寫作一路堆在同一段工作裡 | 一個階段做完,留下必要結果再進下一段 |
| 先限制探索來源 | 一開始就把整個網路交給 Agent 搜 | 先查最有價值的來源,不足再放寬 |
| 按工作難度選推理 | 簡單工作也使用最高推理強度 | 容易檢查的工作求快,難題才多給推理資源 |
| 沒有新資訊就停 | 搜尋、失敗、換方法,再回到類似結果 | 設停止條件,整理目前卡點後再決定下一步 |
這五招裡,我最想先實測的是「限制探索來源」,因為它很容易做出 A/B 差異。
A 組只寫:
幫我研究 ChatGPT Work 的使用量機制。
B 組則把第一輪範圍寫清楚:
第一輪只查 OpenAI Help Center 與官方開發者文件,先回答使用量受哪些因素影響,以及 Work、Codex 的額度關係。官方資料回答不了的部分先列出缺口,不要立刻擴大搜尋範圍。
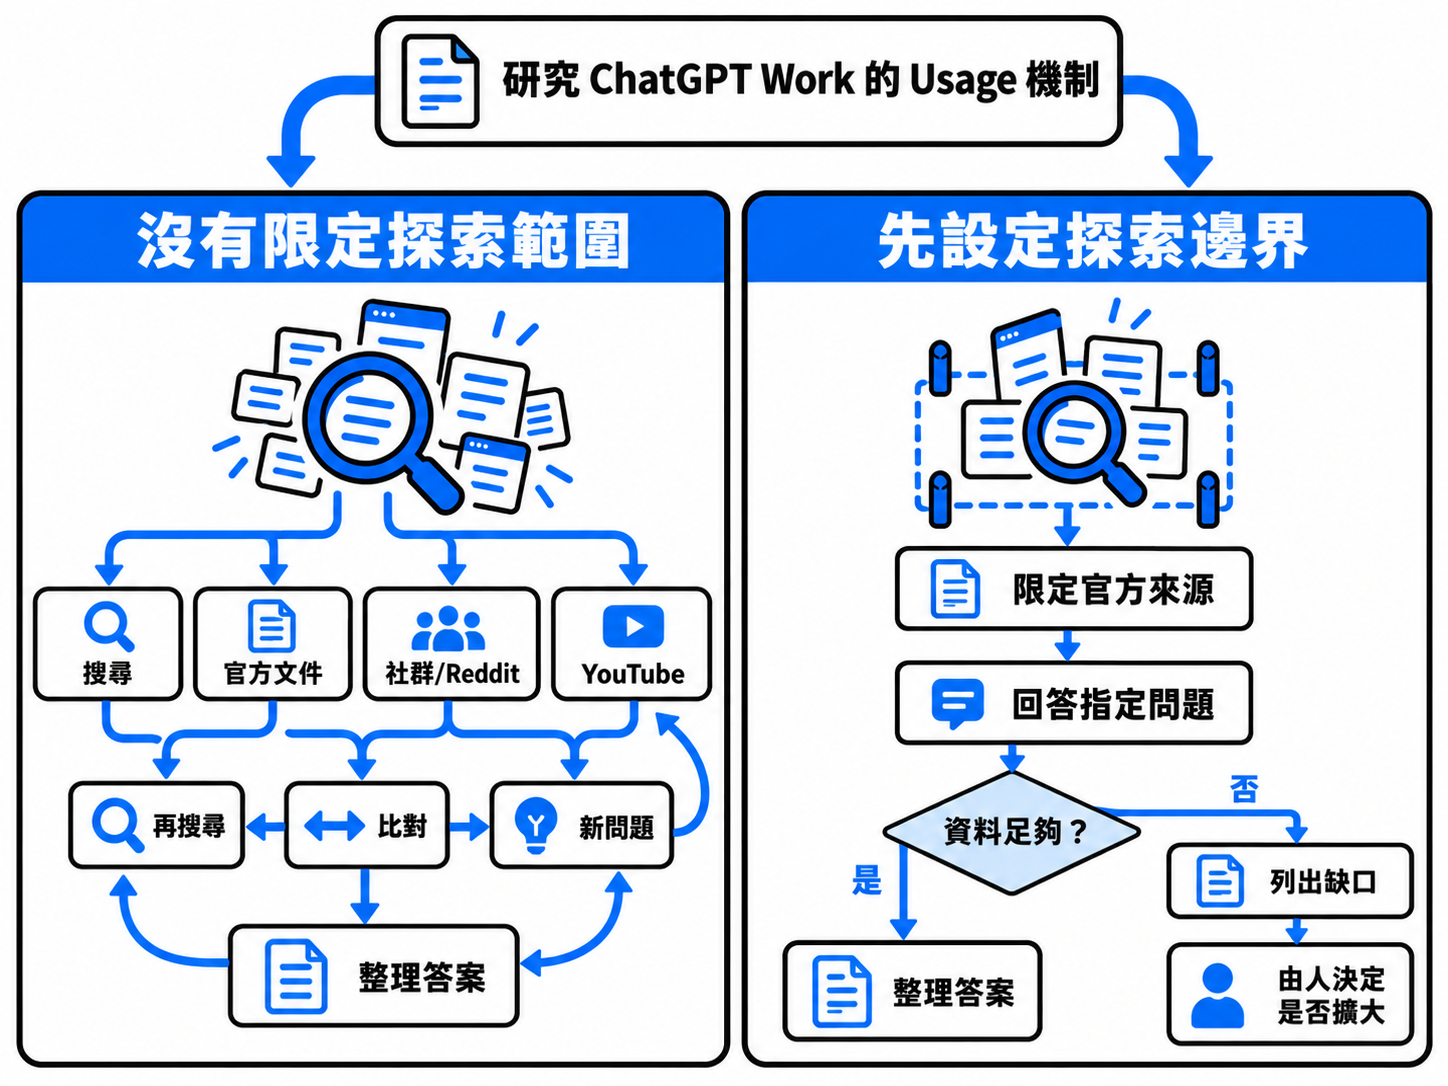
〔圖 4:自由探索 vs. 限定第一輪的雙軌工作路徑圖。左側讓 Agent 自行擴張搜尋範圍,呈現較多分岔、重新搜尋與回頭路;右側先限定官方來源與指定問題,遇到資料缺口時先回到人決定是否擴大。核心不是證明「一定比較省詞元」,而是希望讀者關注:設定邊界後,「是否繼續探索」的決策重新回到人手上。〕
兩組都使用相同模型、相同題目,從新的工作階段開始。我會記錄完成時間、搜尋輪數、打開多少來源,以及前後使用量的變化。這組測試不能證明「限制來源一定省下多少詞元」,但能把抽象的概念變成一段看得見的工作流程:Agent 少走了哪些路,最後的答案有沒有因此變差。
另外四招就不一定全部硬做 A/B。像長任務分階段,比較適合畫成「一路做到尾」和「研究 → 收斂 → 寫作」兩條工作軌跡;推理強度則必須連答案品質一起比較,單看使用量沒有意義。
剛看到每週使用量 0% 時,我第一個反應確實是:以後是不是該省一點?現在我比較少這樣想。而是每次把工作丟出去前,多問一句:這件事,我準備讓 AI 花多少力氣來做?
如果今天遇到一個難解的 Bug、重要的研究問題,或錯一次會浪費更多時間的工作,多花一些資源很合理。真正讓我介意的,是 Agent 不知道邊界在哪裡,只能自己一直找;工作做到一半沒有停損點,只好繼續試;本來只需要一小塊資料,最後卻讀了一大圈。
我現在會把詞元 想成一筆認知資源預算。該花的地方就花,剩下的,盡量不要讓 AI 做白工。


 iThome鐵人賽
 看影片追技術