
Day 13 在 LifeSnaps 標出了缺值,卻無法從靜態匯出檔知道某一天是沒戴、量測失敗,還是資料晚了兩天才同步;也沒有「這幾天發生了什麼」的事件標籤。接下來要做個人 baseline 與偏離偵測,如果連答案都不知道,就只能展示曲線,無法檢查偵測器究竟抓對了什麼。
今天先自己設定一個人的日常波動、緩慢漂移與短期事件,再產生量測噪音、缺值和抵達時間。產生器同時交出下游可見的觀測資料與分開保存的真值標籤,讓後續可以問具體的問題:同一個事件有多容易被日間變異淹沒?在資料尚未到齊的當下,系統實際看見了什麼?這些數字都是情境設定與程式輸出,不代表真實裝置或生理反應。
產生器每次輸出兩份東西:觀測表(下游看得到的)與標籤表(產生時記下的答案)。兩份表鍵相同但分開存,避免評測時把標籤當特徵用。
合成資料驗證的是管線有沒有做到它宣稱的事,不是生理:「睡不夠隔天靜止心率上升多少」只是一個設定。
fill_value)。事件標籤記起訖日、影響的指標、恢復期與注入的幅度,並能攤成逐日表給 Day 17 用。標籤只有 0/1 的話,評測分不出「偵測器太弱」與「事件本來就看不出來」。漂移和事件也要分開標,否則慢慢上升的靜止心率會被當成一個很長的事件。事件期可以提高沒戴機率(Day 13 的 MNAR),這個設定要能關掉。
除了量測的當地日期,資料還有第二條時間軸:它什麼時候到。在時間 T 只看得到抵達時間 ≤ T 的列,所以同一個缺口在不同 T 看答案不同,missing_kind 要跟著 T 一起記。產生器要能區分三種看起來一樣的空白:
| 真實情況 | 當下(T 時)的觀測 | 事後的觀測 |
|---|---|---|
| 沒戴或沒量到 | 沒有列或值空 | 仍然空 |
| 量到但延遲抵達 | 沒有列 | 有值 |
| 量到但始終沒到 | 沒有列 | 仍然空 |
只看觀測表,第一與第三列永遠分不開(所以 D-054 不在 LifeSnaps 上推論同步失敗);合成資料有標籤表,sync_failure 才第一次有真值可對。
同一個設定檔加同一個 seed,要產生逐位元相同的觀測表與標籤表;標準情境凍結成 fixture,Day 15–28 共用。另外要留一組調參時沒看過的 seed:同一批情境上調門檻又報 precision,數字只會好看。
全部是自製合成資料,沒有真實資料。七個標準情境各是一個 YAML(data/synthetic/day14/scenarios/),每檔有自己的 seed:
| 情境 | 人 × 天 | 考的是什麼 |
|---|---|---|
baseline_only |
1 × 60 | 沒有事件,應該什麼都不報 |
two_people_same_value |
2 × 60 | 同一個 rmssd 值,對 p01 偏低、對 p02 平常 |
drift_vs_event |
1 × 60 | RHR 每天漂移 +0.05 bpm,加一個 3 天事件 |
sleep_debt |
1 × 60 | 連續 4 天睡眠少 90 分鐘 |
suspected_illness |
1 × 60 | 5 天 RHR +5、rmssd −12、步數 −4000,事件期更常沒戴 |
mostly_missing |
1 × 30 | 一半的日子沒戴,預期答案是「不下結論」 |
sync_delay |
1 × 60 | 延遲、始終沒到、步數部分同步 |
四個核心函式依 D-060 由 agent 代寫,主要的實作選擇:
day_sd;事件期加 delta,恢復期線性回到 0。available_at,夜間指標是 D 的 07:00,步數是 D+1 00:00。延遲從這裡起算,所以步數隔天才完整不算延遲。observed_as_of 只取 arrival_time <= T 的紀錄,同格取最新 revision,欄名和 LifeSnaps 日表相同,Day 12、13 的函式可以直接接。每一層、每一個人各用一條隨機串流,由同一個 seed 衍生,這樣兩次實驗才是「只差一個變因」:
def stream(seed: int, layer: str, person_index: int) -> np.random.Generator:
    ss = np.random.SeedSequence([seed, LAYERS.index(layer), person_index])
    return np.random.Generator(np.random.PCG64(ss))
改缺值比例只會改 observe 那條串流抽到的數,真值不動;在情境尾端加一個人,前面的人也不變(test_truth_adding_person_keeps_first)。逐位元可重現只承諾在 uv.lock 鎖定的環境:Generator 的分布方法跨 numpy 版本不保證相同。
| 原本以為 | 實際發現 |
|---|---|
| 以為 D 當天早上能看到大部分當天資料,延遲只影響少數格。 | D 當地 09:00 查 sync_delay 的 D,只看到最終 220 格的 57.3%;D+1 79.5%、D+2 89.1%、D+7 才 100%。當天步數最早 D+1 00:00 才完整,09:00 看不到。 |
| 以為固定每天 09:00 查詢,就足以觀察部分同步的值如何被完整值取代。 | 09:00 查詢時,部分同步的 4 筆步數「值被改寫」是 0:部分值在 D 晚上 18–20 時才到,完整值在 D+1 凌晨到,兩次都錯過。改在 21:00 查,D+1 起 4 格的值被改寫。 |
| 以為事件只要有明確的注入幅度,就能從日常波動中辨認出來。 | 注入幅度 ÷ 日間 SD 從 0.75 到 3.57。sleep_debt 的 rmssd −6 ms(0.75 SD),事件外 54 天有 11 天光靠日間變異就偏到同樣程度。 |
| 以為 RHR 高出 baseline 約 4 bpm,就能對上設定的事件。 | drift_vs_event 的 RHR 事件是 +4 bpm,事件期三天的真值卻比 baseline 高 6.9–9.2 bpm;沒有標籤的 2026-02-25 也高 6.1 bpm。 |
| 以為把事件期間的沒戴機率設成三倍,短短幾天也能看到接近三倍的比例。 | suspected_illness 的事件與恢復期 8 天中 2 天沒戴,其餘 52 天中 3 天,方向對但天數少。沒戴的其中一天是事件最後一天,步數真值 312 步是整段最低。 |
以為分成真值、觀測與抵達三層後,固定 seed 還不一定能讓整套資料一致重現。 |
七個情境 validate_dataset 全部通過;同一 seed 重產,觀測表與標籤表逐位元相同。 |
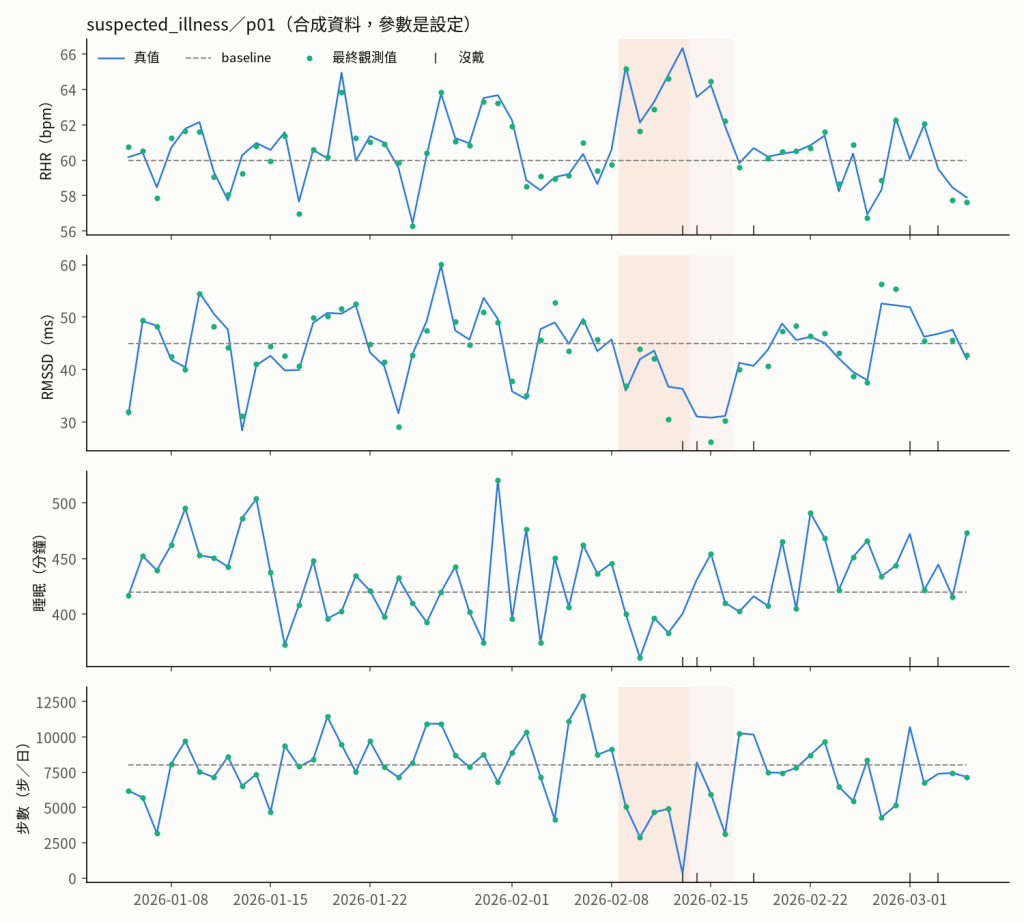
藍線是真值,灰虛線是 baseline,綠點是最終觀測值;深色底是事件期,淺色底是恢復期,底部刻線是沒戴的日子
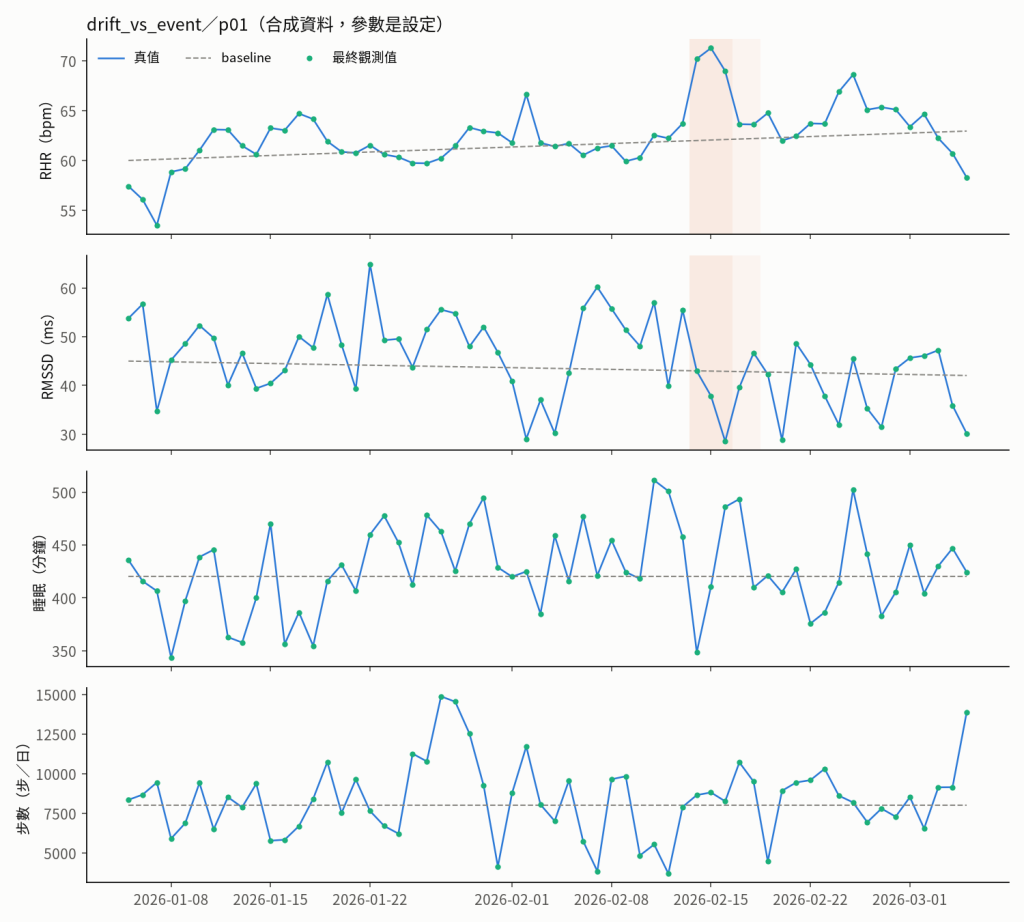
RHR 的 baseline 60 天漂移約 +3 bpm,2026-02-14–16 的事件另加 +4;02-24–25 的上升沒有標籤,來自日間變異
seed 的七個小情境;suspected_illness 的事件與恢復期合計只有 8 天。這段時間的 2/8 天沒戴不能用來估計真實沒戴率,也不足以驗證「機率乘 3」是否穩定;要評估偵測器,還需要多個未參與調參的 seed 與事件幅度。rmssd 的相關,也沒有星期效應。未來偵測器若沿用相同假設,即使在這裡得高分,也可能只是在解出自己設的題目。合成資料給評測已知答案,但只有「有沒有事件」不夠。
第一,標籤要帶幅度。Day 17 的 recall 要按 |delta|/day_sd 分層報,否則抓不到 0.75 SD 事件的偵測器,和真的壞掉的偵測器分數一樣。
第二,答案跟查詢時間綁在一起。Day 21、26 的評測要把查詢時間 T 寫進情境,系統每次輸出要記下它用的 as-of 快照。事後拿補齊的資料重評當時的建議,量到的不是那次輸出的 faithfulness。
第三,「不知道」也要有標準答案。mostly_missing 的預期答案是不下結論;sync_delay 始終沒到的格和沒戴一樣是空的,只有標籤表分得開。評測要能判定系統在該說不知道時說了不知道。


 iThome鐵人賽
 看影片追技術