

Day 16 已能為每個目標日輸出 personal baseline 的 center、scale 與資料狀態。下一個問題是:今天的值離自己的平常多遠,才值得標成偏離?同一個 RMSSD 對不同人意義不同;Day 14 的合成情境也顯示,日間變異可能與事件幅度相當。看到差距就報,會把普通波動當成事件;門檻太嚴,又會漏掉短期變化。
今天以 Day 16 的 baseline 為起點,比較標準化偏差與 IQR 等簡單規則,把逐日判定整理成可追溯的 deviation event。合成資料有注入事件標籤,可以算 precision 與 recall;LifeSnaps 沒有事件真值,只能看規則在實際缺值與波動下報出什麼。要辨識的是「量到的值相對基準有變化」,不是判斷生病或睡眠不足。
對目標日 t,標準化偏差 zₜ = (xₜ − centerₜ) / scaleₜ:正負號是方向,絕對值是相對自身波動尺度的距離。Day 16 的視窗只含 t 之前的資料,今天的值不會先把 baseline 拉向自己。scale 是過去觀測的 SD 或 scaled MAD;zₜ 是偵測分數,不是事件機率,固定門檻也不是醫學界線。
另一種做法是在同一個歷史視窗內,用 Q1、Q3 與 IQR(Q3 − Q1)建立上下界。它不必除以 SD,但端點由有限的觀測決定;21 天視窗最少只要 14 筆,估計可能不穩。兩種方法的視窗、缺值處理與門檻都要先固定,不能看到事件標籤後再調。
逐日分數不等於事件。先訂好超過門檻的日子怎麼合併成一段,再讓每個 deviation event 記下人、指標、起訖日、方向、最大偏離分數、觀測值、所用 center/scale、baseline rule_version,以及有效觀測與凍結狀態。這是今天要檢查的輸出契約;本次先固定合併規則,還不知道合適的連續天數與合併間隔。
當天缺值、品質不足,或 baseline 是 insufficient/not_yet 時,結果是無法判定,不是「正常」。stable 也不保證新鮮:視窗湊不滿時,builder 沿用舊的中心與尺度,並標出 frozen_from 與凍結天數,多久算過時還沒定。事件輸出要保留這些資訊,之後才能檢查舊 baseline 是否造成誤報或漏報。
合成資料把觀測與注入標籤分開保存,可以先定匹配口徑,再算 precision = TP/(TP + FP)、recall = TP/(TP + FN)。逐日命中與整段事件命中是兩個問題;恢復期算不算正例、相鄰警報怎麼合併、缺值日進不進分母,都要先固定並分開報告,否則同一批輸出會得到不同分數。
recall 還要按注入幅度相對日間波動分層看:sleep_debt 把 RMSSD 下降設為 6 ms、日間 SD 8 ms,只有 0.75 個設定 SD,這是情境參數,不是睡眠不足的實際效果。合成資料的分數只表示規則在這些設定下抓到已知注入,不能外推成真實健康事件的準確率。
baseline_only(沒有事件)量誤報;四個事件情境中注入事件的(人,指標)共 10 個面板,幅度 0.75–3.57 個設定日間 SD(情境設定,不是實測)。rmssd,46 個(id, 輪)、2412 個目標日,沒有事件標籤。iqr 以同一視窗的 Q1 − m·IQR、Q3 + m·IQR 為界線(分位數用 linear;凍結日沿用 frozen_from 的視窗),score 是 (x − (Q1 + Q3)/2) / IQR,和 z 不是同一把尺,peak_score 不能跨方法比較。z_mean_sd 3.0(每 100 個可判定非事件日約 1.2 次)的點:z_median_mad 3.5、iqr 2.0。min_run = 1、max_gap = 0,連續的標旗日合成一段、單日也保留;事件命中=與注入事件有日期重疊。程式在 src/wearable_ai/anomaly/:
cfg = DeviationConfig(method="z", threshold=3.0, min_run=1, max_gap=0)   # direction 預設兩側
base = build_baselines(observed, dates=targets, config=BaselineConfig(stat="mean_sd"))
daily = flag_days(observed, base, cfg)         # 每日:score、lower/upper、decidable、reason、frozen、flag
events = merge_flags(daily, cfg, person_id="p01", metric="rmssd")   # 起訖日、方向,以及 peak 日的分數與 center/scale
文字輸出的第一行是設定快照(deviation-v2 只記版本,還原不出門檻),原始結果旁另存 .snapshot.json,表格從原始結果重算。
| 原本以為 | 實際發現 |
|---|---|
| 我以為 z = 3 與 IQR 1.5 都是抓明顯離群值的常用起點,換方法誤報會有差,但不至於差到數倍。 | 100 個校準 seed、A 組,每 100 個可判定非事件日的誤報(resting_hr/rmssd):z_mean_sd 1.135/1.267、z_median_mad 2.360/2.332、iqr 4.272/3.974。兩種 z 方法同用 3,誤報仍差約 2 倍;iqr 1.5 約 3.1–3.8 倍。 |
| 我以為用 100 個 seed 校準到接近後,換一批 seed,三個方法仍會落在差不多的範圍。 | 換到評估 seed,resting_hr 的 iqr 2.0 從 1.344 升到 2.142、z_median_mad 3.5 從 0.986 升到 1.517,z_mean_sd 3.0 是 1.135 → 1.101;rmssd 三點 1.137–1.486。校準出來的「接近」,換一批 seed 不一定還在。 |
| 我以為 0.75 SD 會被日常波動蓋過,但到 3.57 SD,應該能抓到多數事件日,不只是碰到一天。 | A 組、指定門檻:sleep_debt(0.75、1.00 SD)逐日 recall 0.019–0.031、事件命中率 0.05–0.08;two_people_same_value rmssd(3.57 SD)逐日 recall 0.351–0.520、命中率 0.73–0.87。 |
| 我以為視窗裡留著事件日,主要是讓偏離分數稍微縮小;排除它們能改善 recall,但不至於讓 baseline 大量凍結。 | 依標籤排除事件的 C 組,30 格(10 面板 × 3 方法)的逐日 recall 全部高於 A(上例 z_mean_sd 0.351 → 0.740);但 C 在 suspected_illness 的凍結比例 0.439–0.514(A 是 0):視窗湊不滿 14 筆,只能沿用舊值。 |
| 我以為排除自己已標旗的日子,不用標籤也能救回一些漏報,誤報代價應該有限。 | B 組 30 格的 recall 都高於 A(上例 0.707),6 格不低於 C;但自己非事件日的誤報 30 格都較高(中位數 1.48 倍)。判準下 z_mean_sd 4 個面板領先、另兩個方法 0 個,但格點太粗,z_mean_sd 實際都是同門檻比較。 |
| 我以為 LifeSnaps 的波動與缺值會讓警報比合成無事件情境多,但三個方法抓到的日子應該大致重疊,凍結分桶也看得出差別。 | 2412 個目標日只有 966 天(40.0%)可判定;標旗率 2.9%–4.8%,三個方法標旗日的 Jaccard 0.34–0.48。可判定的凍結日只有 64 天,看不出差別。這是警報量,不是誤報率。 |
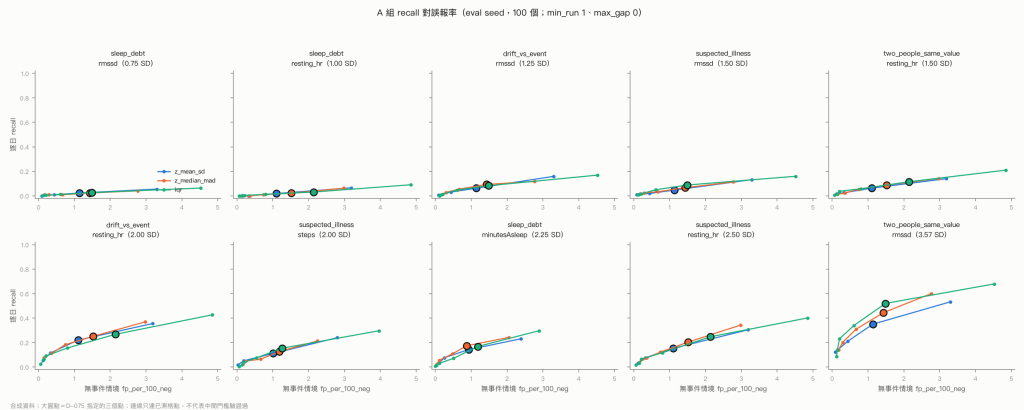
A 組 10 個面板的逐日 recall 對無事件誤報率(合成資料,每點 100 個評估 seed);大圓點是三個指定門檻,連線不代表中間的門檻驗證過
比較只涵蓋 21 天視窗、至少 14 筆與已測門檻。門檻只在 A 組的 resting_hr、rmssd 校準,換到評估 seed 已不再同樣接近;B 沒有獨立校準,recall 增加也伴隨誤報增加;四個領先面板實際是同門檻比較,不能據此說 B 在相同誤報率下優於 A。C 用了標籤,凍結日也較多,只能當對照。逐日 recall 只算可判定事件日、恢復期不計、日期重疊就算命中,不代表完整捕捉事件起訖或多數事件日。
合成資料的日間變異是高斯 AR(1),事件幅度與恢復方式都是設定值;每個面板每個 seed 只有一個事件,100 個 seed 不代表真實事件的多樣性。同一序列內的日子相關,逐日算的 Wilson 區間偏窄,點估計接近不等於統計等效。LifeSnaps 只看 rmssd,僅 40.0% 目標日可判定,警報率無法代表其餘日子;可判定凍結日只有 64 天,又沒有事件標籤,無法判斷凍結是否增加誤報,也無法驗證合成結果能否外推到真實健康事件。
偏離偵測是 LLM 之前最後一層 deterministic 判斷,交出去的不能只有一個 flag。
第一,門檻不能單獨傳遞。初始的 z = 3、IQR 1.5 在三個方法上的誤報率最多差約 3.8 倍,校準好的點換一批 seed 又會漂移。下游說「這很少見」,要引用這組設定量到的誤報率,而不是門檻的字面意思。
第二,「無法判定」是一種答案。LifeSnaps 有 60% 的目標日因缺值、歷史不夠或還沒穩定而無法判定;feature contract 若把它們寫成 flag = False,LLM 就會把「沒資料」說成「一切正常」。
第三,事件日進不進 baseline 是產品策略:全部納入會讓持續偏離被吸收,排除已標旗日會提高誤報。Day 19 的 feature contract 要把這個選擇寫成欄位。
最後,門檻與判準先寫下、評估 seed 只用一次、原始結果存檔再重算,和之後評測 prompt 時不在測試集上調是同一件事。


 iThome鐵人賽
 看影片追技術