
Day 15 把 personal baseline 當成估計問題:多收幾筆有效觀測後,mean 和 SD 還會不會明顯改變?結果有個設計上的盲點:當時要求連續兩次通過檢查,最早只能在第 28 筆判定「暫時穩定」,許多答案正好落在這個下限。這不能告訴我更少的歷史是否也會符合規則,更不能把 28 筆直接寫成所有人的最低需求。
今天把檢查點提前到第 7 筆,之後每增加 7 筆再檢查一次,仍要求連續兩次符合;參照尺度維持由前 14 筆估計。這樣最早可在第 21 筆判定,再觀察答案是否又堆在下限。接著把 baseline window、minimum observations 和統計量選擇做成可設定、可版本化的 baseline builder,輸出中心、波動範圍、有效觀測數、經過的日曆天數、狀態與判準版本。合成資料有已知事件標籤,可用來比較 mean/SD 與 median/MAD 遇到事件污染時的反應;LifeSnaps 則用來檢查真實每日資料的缺值與可用性,不能替它補上不存在的事件真值。
「最近 28 個日曆天」與「最近 28 筆有效觀測」在有缺值時不一定涵蓋同一段時間。Day 12 已看到,先丟掉空值再用固定筆數的 rolling window,可能把更早的日子拉進來;只用日曆視窗也不保證裡面有足夠資料。因此 builder 要分開接收視窗長度與最小有效觀測數,並回報實際用到幾筆、橫跨幾個日曆天。視窗只能看估計當下已可用的過去資料,也不能跨使用者或研究輪次;要拿來比較的那一天也不能算進自己的 baseline,否則 Day 17 算偏離時,當天的值會把中心拉向自己,偏離被低估。這些規則若藏在程式常數裡,換一次門檻,舊的 baseline 就無法按原口徑重現。
最小有效觀測數也不能直接從 Day 15 的第 28 筆抄過來。那是舊檢查點設計允許的最早答案;Day 16 先依 D-065 在第 7、14、21 筆等位置重跑,看看較早的判定點是否仍是結果的下限。即使得到新的 n*,它也只回答「在這套資料與相鄰變動規則下何時看起來穩定」,不是已驗證的生理門檻,更不是估計誤差已足夠小的證明。
這個 n* 還有兩個口徑限制。第一,Day 15 與 Day 16 的檢查點都用「最初 n 筆」,問的是從零開始累積到第幾筆會穩;builder 用的是「最近一段」的滑動視窗,視窗會滑過事件、缺值與季節漂移,同樣的筆數不保證同樣穩。第二,判準是對 mean 和 SD 的相鄰變動做的;換成 median/MAD,同樣的筆數下估計抖動不同(見下節),n* 不能直接沿用。
Day 15 用 mean 和 sample SD,方便對照合成情境設定的中心與日間波動;代價是少數極端值也會拉動兩者。另一組選擇是 median 和 MAD:先取中位數,再取各觀測值離中位數距離的中位數。它們對少數極端值較不敏感,但 MAD 與 SD 不是可直接互換的數值;若用常見的 1.4826 倍把 MAD 對到 SD 尺度,這個校正依賴常態分布假設。Rousseeuw 與 Hubert 的方法回顧提供這組 robust statistics 的依據,不代表它們已在 Fitbit 夜間 RMSSD 上通過驗證。
Robustness 有代價。資料沒有污染、接近常態時,MAD 的 Gaussian efficiency 只有約 37%(Rousseeuw 與 Croux),n = 7–28 的小樣本也只有 0.37–0.40(Akinshin 的模擬,我用固定 seed 重跑,數字一致):大約要 2.5 倍以上的觀測,MAD 才和 SD 一樣穩。所以在乾淨資料上改用 MAD,n* 可能反而往後延。
它擋得住的也有範圍。median 與 MAD 能承受接近一半的污染,最擅長的是零星、遠離中心的值;今天的合成事件卻是連續多天的中等偏移。suspected_illness 是 5 天事件加 3 天恢復,rmssd 下降 12 ms,約是日間 SD(8 ms)的 1.5 倍;最多 8 天在 28 天視窗裡約占 29%,median 不會崩潰但仍會被拉動,在 14 天視窗裡則超過一半。median/MAD 是否比 mean/SD 好,要看事件長度與視窗長度的比例,不是換了統計量就解決。
分位數可直接描述「過去觀測有多少落在某段範圍」,但範圍端點也會隨樣本數與事件混入而變。比較 mean/SD、median/MAD 與分位數時,要說清楚各自估的是什麼,而不是把不同方法給出的範圍當成同一個答案。合成資料可用預先知道的事件標籤,比較納入與隔離事件後估計如何變;LifeSnaps 沒有這種真值,不能為了讓 baseline 好看而事後刪掉偏離日。
一個中心值如果沒有視窗、有效筆數、波動範圍與狀態,下游無法知道它建立在多少證據上。insufficient 表示連判準所需的起始尺度都無法估計;not_yet 表示已有尺度,但還沒到可判定點,或檢查後仍未符合規則;stable 只表示通過當前版本的暫時穩定判準。這些狀態不能由 LLM 看見一個數字後自行猜測,應由 builder 按明確參數產生,並連同判準版本輸出。Day 16 先處理「多收資料後還會不會變」;「估得多準」需要另外定義精度判準,不能混成同一個 stable 標籤。
有兩件事 builder 必須明寫,不能留給下游猜。一是「波動範圍」怎麼算:mean ± k·SD、median ± k·scaled MAD 或某組分位數,k 或分位數是多少;不寫清楚,下游無法知道「超出範圍」代表什麼。二是狀態會不會退回:Day 15 只從頭累積一次,判定為 stable 就結束;滑動視窗滑過事件或長段缺值後,同一個人可能從 stable 變回 not_yet,這條規則也要跟著判準版本一起記錄。
two_people_same_value(seed 1406–1605)。builder 用 Day 14 的 suspected_illness:p01 的 rmssd 設定中心 45 ms、日間 SD 8 ms,第 35–39 天下降 12 ms,第 40–42 天恢復,另有 5% 沒戴(事件期放大三倍)與 5% 量測失敗;seed 1403–1602 共 200 組。數字都是情境設定,不是實測。rmssd 非空的列,46 個 (id, 輪),沒有事件標籤。BaselineConfig;每一列輸出只帶統計量 stat 和人工指定的判準版本 rule_version(本版 baseline-v1),完整設定要另外保存(as_dict())。insufficient;判準還沒成立是 not_yet;成立之後是 stable。成立後視窗湊不滿 14 筆,或尺度為 0(例如數值全部相同),本版不退回 not_yet,而是凍結:沿用最後一個湊滿的視窗,並標出凍結自哪天、已經幾天。window_observations、estimate_center_scale、resolve_status 三個核心函式在 src/wearable_ai/baseline/builder.py;呼叫端只給有效觀測與設定:
config = BaselineConfig(window_days=21, min_obs=14, k_range=2.0)   # stat 預設 "mean_sd"
out = build_baselines(series, dates=["2026-02-17"], config=config)   # series: date, value(ms)
out[["status", "center", "scale", "low", "high", "n_obs", "frozen", "frozen_from", "rule_version"]]
預設統計量維持 mean/SD,median/MAD 是可設定的對照。dates 只給一天時,builder 內部仍從第一筆觀測逐日算到那天再篩選,因為凍結要知道之前每一天的視窗;外部 code review 抓到第一版沒這麼做,單日查詢會得到和逐日查詢不同的狀態。設定也會先驗證:k_mean=NaN 這類錯誤原本會被輸出成看似正常的 not_yet。
| 原本以為 | 實際發現 |
|---|---|
| 把最早判定點從 28 提前到 21,應該能分開原本擠在下限的答案;我預期判定時間會更分散,而連續兩次通過的要求不變,估計品質應該差不多。 | default 門檻下答 21 的比例:合成 p01 46.5%、p02 52.5%,LifeSnaps 25 / 46 組。比 Day 15 答 28 的 84.0%、81.5%、30 / 46 分散,但仍有近一半落在新的下限。判定當下估計略差:p01 |mean 誤差| 90 百分位 0.504 → 0.573 個設定 SD,SD 比值 10 百分位 0.732 → 0.680。 |
| median/MAD 對少數極端值較不敏感,我預期相鄰檢查點的估計也會比較少跳動,能比 mean/SD 更早符合穩定判準。 | 變晚。p01 答 21 從 46.5% 降到 17.5%,到 42 筆仍未達成的從 0% 升到 14.0%;LifeSnaps 答 42 以上從 0 升到 8 / 46 組。判定當下中心誤差差不多(90 百分位 0.573 vs 0.553),尺度比值 10–90 百分位反而更寬(0.680–1.159 vs 0.615–1.227),和 MAD 效率較低一致。 |
| 事件加恢復只有 8 天,還不到 21 天視窗的一半,我以為 median 能擋住大部分影響,中心會比 mean 更接近設定的 45 ms。 | 第 43 天、200 組 seed,中心誤差中位數:mean/SD −0.43 個日間 SD,median/MAD −0.37。10 百分位兩者都約 −0.95。連續 8 天的中等偏移在 21 天視窗裡約占 38%,median 只少被拉低一點。 |
| 既然合成資料知道哪些日子是事件,我以為排掉後就能用剩下的乾淨觀測更新 baseline,代價主要是估計用的筆數減少。 | 中心誤差中位數回到約 0(0.010、−0.038),但 173 組 stable 全部是凍結值:排除 8 天後,21 天視窗最多剩 13 天,湊不到 14 筆。seed 1403 的第 43–56 天都沿用第 41 天的視窗。在這組參數下,事件剛結束的那幾天,「隔離事件」就等於「凍結」,視窗只容得下 7 天缺值。 |
| Day 15 多數組都能累積到穩定,我以為換成逐日 builder 後,大部分日期也能用當天視窗更新 baseline,凍結只會偶爾出現。 | LifeSnaps 2412 個目標日:insufficient 28.0%、not_yet 22.7%、stable 49.3%;stable 裡 11.4% 是凍結值,凍結天數中位數 7、最多 22 天,46 組中有 9 組凍結過。換成 median/MAD,這批資料的這些數字完全相同。累積穩定判準只看 mean/SD,但視窗能不能用還要看所選統計量的尺度是否 > 0;超過一半數值相同時 MAD 為 0、SD 不為 0,兩者就會分岔。 |
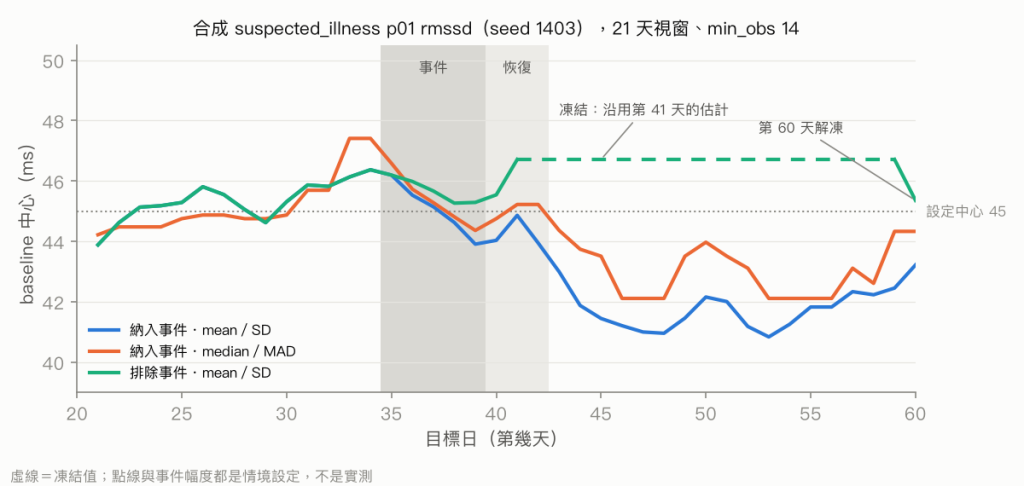
合成 suspected_illness p01(seed 1403)每個目標日的 baseline 中心。納入事件時兩種統計量都被拉低,median 只少一點;排除事件後第 42–59 天凍結,第 60 天解凍。點線是情境設定值,不是實測
這次的 stable 只表示從頭累積的估計通過相鄰變動判準;mean/SD 在 default 門檻下仍有近一半落在最早可判定的 21 筆,尚無法據此確定最低需要多少歷史。builder 也沒有重新檢驗每個滑動視窗的穩定性,median/MAD 的輸出沿用 mean/SD 的判定狀態。精度判準尚未實作,因此 stable 無法保證中心或尺度的誤差已足夠小,center ± 2·scale 的實際涵蓋率也未經本實驗驗證。21 天視窗、14 筆下限與 k = 2 都是本版的設計選擇;凍結期間沿用舊估計,多久算過時仍未設定,所以有 stable 標籤也需要一起看 frozen 與凍結天數。
事件污染實驗只改變同一合成情境的 seed;事件長度、偏移幅度、日間波動與缺測機制都是設定值,200 組結果不能當成 200 位真實使用者的表現。中心誤差摘要只計入 stable 的 seed,納入與排除事件後能進入摘要的組數也不同,解讀誤差時要連同可用組數一起看。腳本使用最終修訂版資料,僅確認資料曾抵達,未模擬每個目標日當時已收到哪些觀測;依已知標籤刪除事件與恢復日也依賴事先掌握事件真值。LifeSnaps 的 46 個使用者與輪次組合沒有這類標籤,這次只能描述該樣本的狀態與凍結比例,無法用它驗證事件排除的效果,也不能直接推論其他裝置或人群的 baseline 可用率。
baseline 不是一個數字,而是一組假設的輸出。今天把視窗、最小筆數、統計量、k 與判準版本全放進 BaselineConfig,每一列輸出都帶著 rule_version、有效筆數和凍結狀態。下游(Day 17 的偏離偵測、之後的 LLM)拿到的是像「這個中心沿用第 41 天的估計、已凍結 15 天,今天的視窗只剩 11 筆」這樣的描述(舊視窗有幾筆,要回查 frozen_from 那天),而不是一個看不出來源的 45 ms。
兩輪外部 code review 抓到的問題都不在統計,而在契約:單日查詢和逐日查詢答案不同、錯誤設定被當成「還沒穩定」。這類錯誤不會讓程式崩潰,只會安靜地產生看似合理的狀態,最後被 LLM 講成一句有自信的話。所以測試要寫成契約:同一天不管怎麼查答案都一樣,錯的設定在運算前就停下。
事件排除實驗也提醒:參數之間會互相牽制。21 天配 14 筆,等於規定最多容忍 7 天缺值;「排除生病日」這個看似合理的清理,在這組參數下讓事件剛結束的 baseline 直接凍結。改任何一個預設值,都要換判準版本,並重跑這些情境。


 iThome鐵人賽
 看影片追技術