
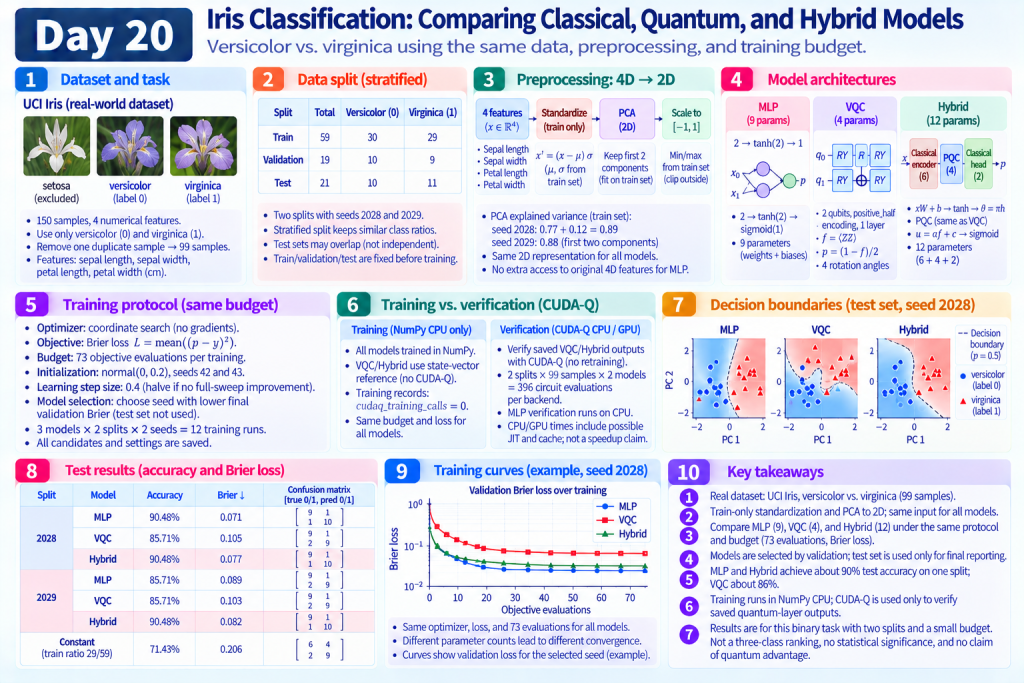
Day 18、19 在合成資料上比較模型、串接混合網路。今天第一次把同一套流程放到真實公開資料:UCI Iris。
想像三種不同引擎的車,改在同一條真實道路上試駕。路況、測速規則、油量預算都要先寫死;否則「誰比較快」說不清楚。本日只做 versicolor/virginica 二分類,四個原始特徵先經訓練集標準化與 PCA 壓成兩維,再送進 MLP、VQC 與 Hybrid。這不是完整三分類排行榜。
程式:iris_models.py、experiment.py、demo.py、plot_results.py。訓練全在 NumPy CPU;選定權重後再用 CUDA-Q CPU/GPU 核對含量子層的輸出。
Day20 compares MLP, VQC, and a hybrid model on UCI Iris versicolor/virginica after train-only standardization and PCA to two dimensions. Shared Brier loss and coordinate-search budgets select models by validation; CUDA-Q verifies saved quantum-layer outputs. Results are a restricted binary report, not a three-class ranking or quantum-advantage claim.
Iris 有 150 筆、四個數值特徵、三類各 50 筆。[D17] 本日保留 versicolor=0、virginica=1,排除 setosa,以沿用已驗證的二分類介面。
原始檔在 data/day20,含 UCI 來源、CC BY 4.0 與下載日期;程式記錄 SHA-256,可離線重跑。二分類子集 100 筆中有一筆特徵+標籤完全重複;切分前保留第一筆、移除列號 142,剩 99 筆。欄位順序固定:花萼長寬、花瓣長寬(cm)。
分層切分讓各組類別比例接近原資料。種子 2028/2029;每類打亂後約 60%/20%/20%:
| 分組 | 總數 | versicolor | virginica |
|---|---|---|---|
| 訓練 | 59 | 30 | 29 |
| 驗證 | 19 | 10 | 9 |
| 測試 | 21 | 10 | 11 |
兩切分的測試點可能重疊,不是獨立統計樣本。
四個原始特徵 → 標準化 → 兩維 PCA → 依訓練範圍縮放 → 截斷到 [-1,1]
標準化:減訓練平均、除以訓練母體標準差。PCA:找變動大的方向,只留前兩個;解釋變異比例描述保留多少變動,不是分類準確率。主成分符號固定為「最大絕對值係數為正」。驗證/測試只套用保存規則。[D14]
所有模型都只看到這份二維表示;一般 MLP 沒有額外拿到四維原特徵。因此本日不代表經典模型在完整四維上的最佳表現。
Split 2028 訓練 PCA 解釋變異約 0.77+0.12=0.89;2029 約 0.88。
| 模型 | 架構 | 參數 |
|---|---|---|
| MLP | Day 16:2→tanh(2)→sigmoid(1) | 9 |
| VQC | Day 14:positive_half、兩位元、一層模板、p1=(1−ZZ)/2 |
4 |
| Hybrid | Day 19:仿射+tanh 編碼 → PQC → 仿射+sigmoid | 12 |
每模型每切分種子 42/43 → 12 次訓練。Day 18 座標搜尋、步長 0.4、每次 73 次目標函數、共同 Brier;Hybrid 輸出倍率起始 0.8。依最終驗證 Brier 選種子;測試不參與。全部候選保留。
相同目標函數次數 ≠ 相同計算量。本日不用 Day 19 梯度下降或參數位移,避免把不同訓練成本混稱同一預算。
搜尋全在 NumPy CPU(VQC/Hybrid 用既有狀態向量參考)。training_summary.json 記錄 cudaq_training_calls=0。這不是 CUDA-Q 訓練,也不是 GPU 訓練加速。
選定後 verify 才切 CUDA-Q:每後端 2 切分 × 99 筆 × 2 個含量子模型=396 次 observe;MLP 仍在 CPU。訓練秒數與驗證秒數(可能含 JIT/快取)不可相除當加速比。
常數基準用訓練類別比例 p1=29/59(不是 Day 18 的 0.5)。參考測試成績(列=真實、欄=預測):
| Split | Model | Accuracy | Brier |
|---|---|---|---|
| 2028 | mlp / hybrid | 90.48% | ≈0.071/0.077 |
| 2028 | vqc | 85.71% | ≈0.105 |
| 2029 | mlp/vqc | 85.71% | ≈0.089/0.103 |
| 2029 | hybrid | 90.48% | ≈0.082 |
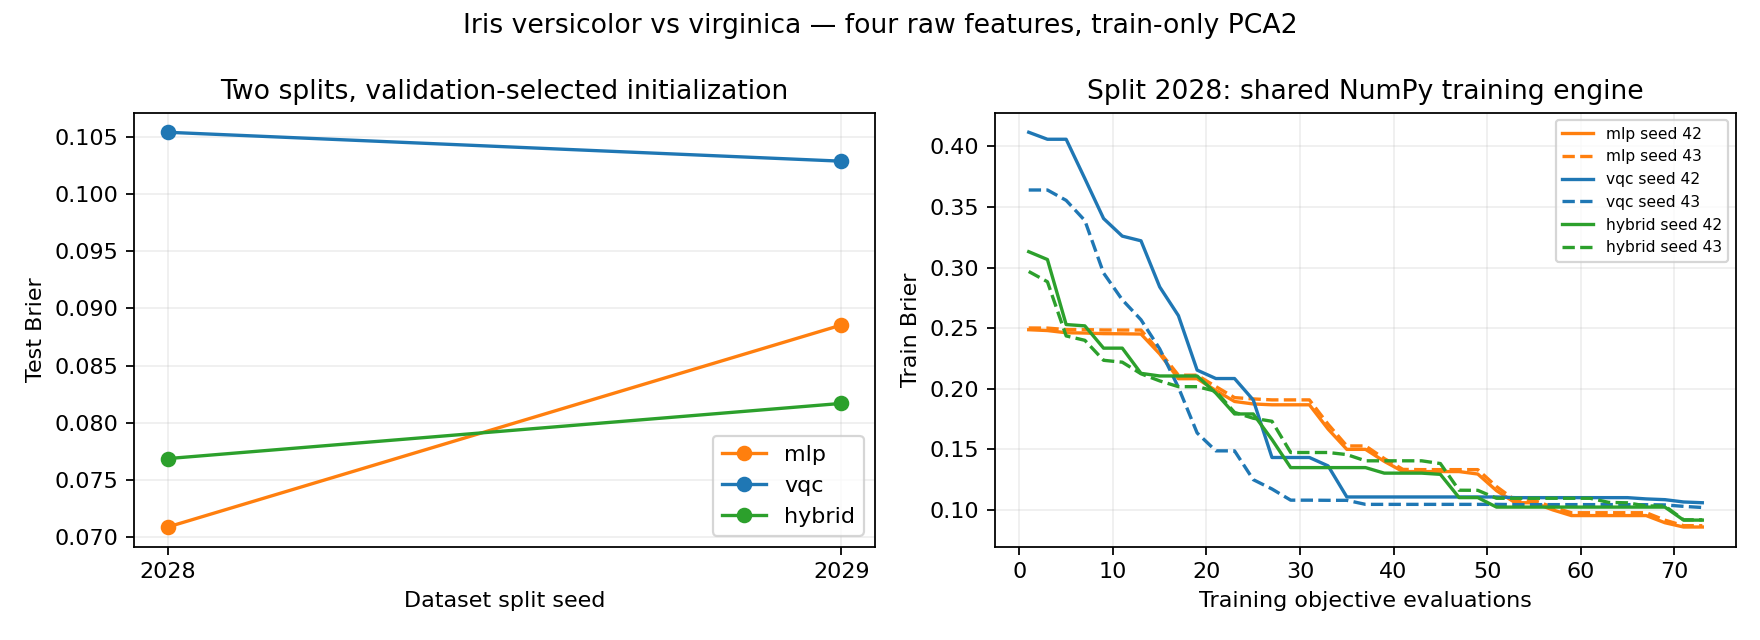
兩個切分、各兩個初始化只是有限穩定性觀察,不是完整交叉驗證或信賴區間。單次較好不能外推為模型家族優勢。細節見 結果紀錄。
source .venv/bin/activate
OMP_NUM_THREADS=1 python articles/day20/experiment.py train
OMP_NUM_THREADS=1 python articles/day20/experiment.py verify
OMP_NUM_THREADS=1 python articles/day20/experiment.py verify --backend nvidia
OMP_NUM_THREADS=1 python articles/day20/plot_results.py
OMP_NUM_THREADS=1 python articles/day20/demo.py --features 6.0 2.9 4.5 1.5
示範輸入四個 cm;可加 --split-seed 2029、--backend nvidia。結果在 results/day20/;重訓後應重跑兩個 verify 與繪圖。
OMP_NUM_THREADS=1 python -m unittest discover -s articles/day20 -p 'test_*.py' -v
OMP_NUM_THREADS=1 DAY20_TARGET=nvidia python -m unittest discover -s articles/day20 -p 'test_*.py' -v
測試檢查來源/去重/切分、train-only PCA、CUDA-Q/NumPy 對齊;不以測試準確率當通過門檻。
本日範圍:受限二分類、兩維表示、小預算、精確模擬器。沒有完整三分類、含噪訓練、QPU、GPU 訓練或量子優勢結論。
資料政策見 data/day20/README.md;索引見 REFERENCES.md。
下一篇 Day 21 比較 PCA、特徵選擇與可訓練壓縮層。
[N7] Jan Schnabel and Marco Roth. “Quantum kernel methods under scrutiny: a benchmarking study.” Quantum Machine Intelligence 7, 58 (2025);研究論文。原始來源;完整書目。
本章比較 Iris 上的電路分類器;該基準研究可對照共同評估規則與多資料集設計。核方法結果不能直接替代本章電路模型的實測。

 iThome鐵人賽
 看影片追技術
看更多

