
Day 09 的開頭有說,希望能在聽到播放清單的第二首歌時,把另一首歌插在它後面,但後來介紹的方法只有 append 和 prepend,一個加在尾巴、一個加在開頭,都不是插在中間的做法。今天就來看看怎麼插在中間(Insert),還有另外兩個操作:把其中一首歌從清單裡拿掉(Delete),以及把整條清單反轉(Reverse)~
三個操作共用同一份清單,為了方便說明,以下先把五首歌簡寫成 A 到 E:
A → B → C → D → E
在開始寫之前,先看看一個 Linked List 隨時都該滿足哪幾件事:head 指著第一個 node、tail 指著最後一個 node、tail.next 是 null、length 等於實際的 node 數量,且從 head 出發要走得到每一個 node。這幾件事合起來就是這個結構的 invariant(不變式),不管做了什麼操作,結束之後它們都要重新成立。後面處理邊界的時候,會一直拿它來對照。
要把 X 插在 B 後面,得先找到 B。
不過「插在 B 後面」這種說法對程式來說太模糊,我們需要用 index 來表示插入的位置,因此「把 X 插在 B 後面」的另一種說法就是「讓 X 插完之後站在 index 2」。原本 index 2 是 C,X 會落在 B 和 C 之間,也就是插在 B 後面。
那要走到哪一個 index 才能做到插入?X 會站在 index 2,但我們真正需要的是 index 1 的 B。原因是改連結的人是前一個 node,不是被插進來的那一個,新的 node 自己沒辦法讓任何人指向它。這件事在更動 Linked List 的時候會很常出現:要動的位置在 index,要拿到的 node 則在 index - 1。
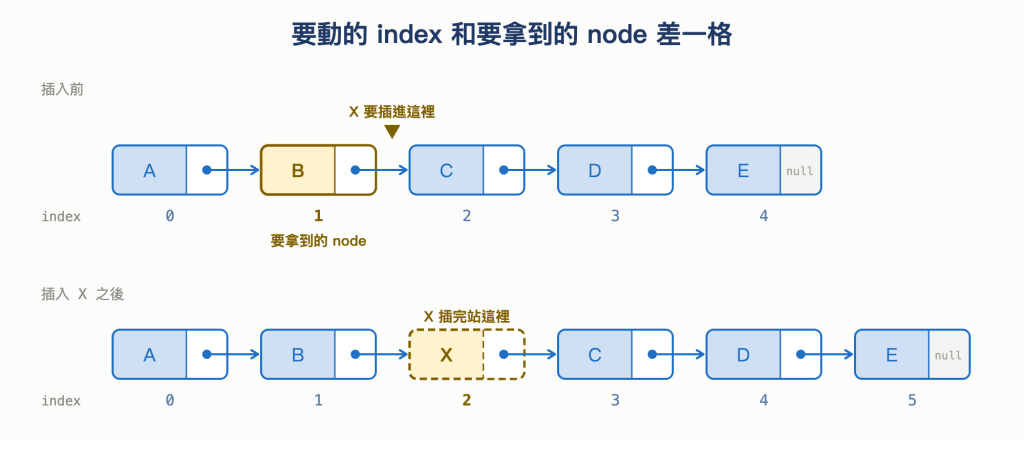
圖 1 要動的 index 和要拿到的 node 差一格
昨天的 lookup 已做過類似的事,差別在於 lookup 回傳的是 current.value,而現在要的是 node 本身,因為接下來要改它的 next。先寫一個只負責遍歷、回傳 node 的方法:
traverseToIndex(index) {
  let current = this.head;
  let count = 0;

  while (count < index) {
    current = current.next;
    count++;
  }

  return current;
}
traverseToIndex 看起來沒什麼問題,那如果要插在最前面呢?index 0 的前一個是 index -1,不存在 index -1 的 node。
因此插入要分成兩種情況:
next
LinkedList 自己存的 this.head
我們先看插在其他位置的情況,當我們拿到 B 之後,有兩條連結要處理:X 的 next 要指 C,B 的 next 要改成指 X。
問題是,C 在哪裡這件事,現在只有 B 的 next 知道。如果先改 B,那條唯一知道 C 在哪的線就被蓋掉了,後面三個 node 會一起不見。所以順序只有一種:先讓新的 node 接住前一個原本的 next,再讓前一個改指新的 node。
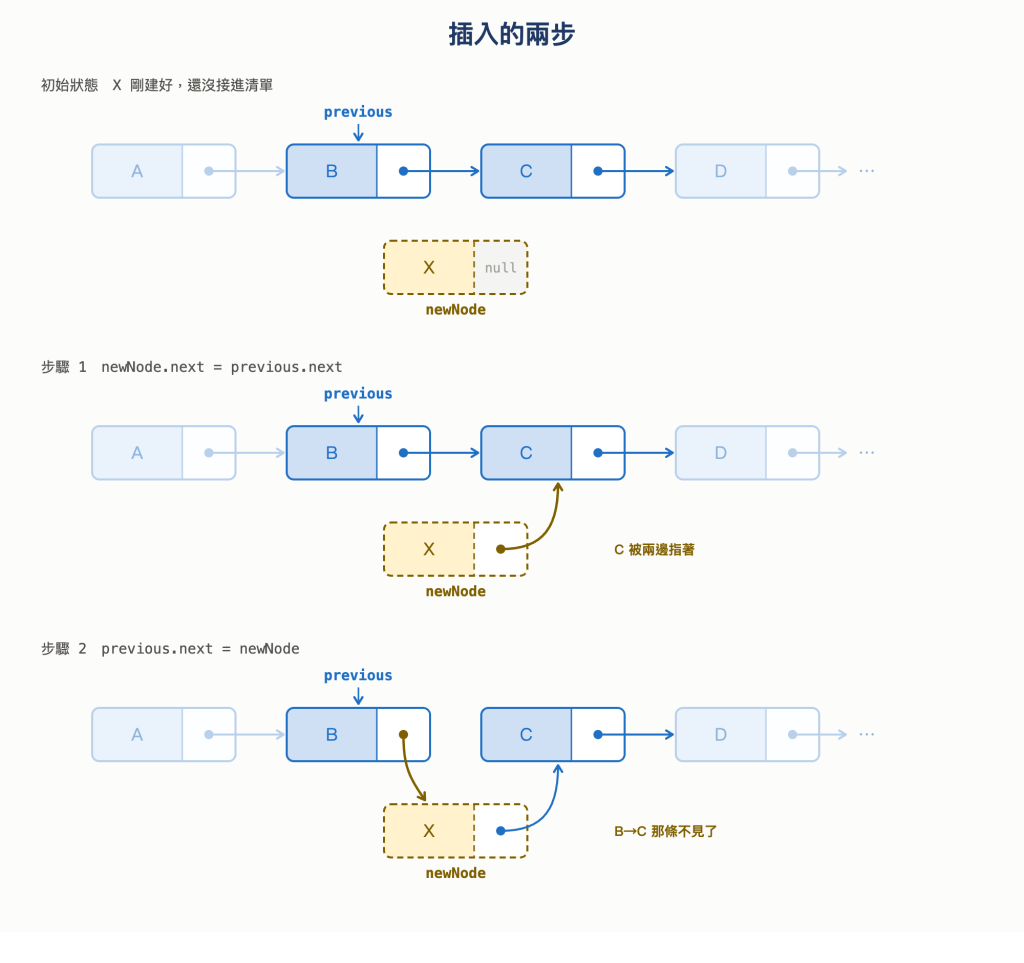
圖 2 插入的兩步:新 node 先接住 previous.next,previous 才改指新 node
再來看插在 head 位置的情況,這時沒有前一個 node 可以改,要動的是 this.head,這正是 Day 09 的 prepend,直接交給它即可。
插在最後面則是另一個可以直接交出去的情況,它其實屬於上面第一種,前一個 node 是存在的,只是那個 node 剛好就是 tail,本來就在手上,不用走過去找;而且插完之後 this.tail 要跟著移動,這些 append 都已經做過了。
合起來寫成程式:
insert(index, value) {
  if (index <= 0) return this.prepend(value);
  if (index >= this.length) return this.append(value);

  const newNode = new Node(value);
  const previous = this.traverseToIndex(index - 1);

  newNode.next = previous.next;
  previous.next = newNode;
  this.length++;

  return this;
}
開頭兩行就是在處理插在最前面和最後面這兩種位置,而它們少了之後壞的方式不一樣。index <= 0 這行交給 prepend,少了它,traverseToIndex(-1) 的 while (count < -1) 無法執行,直接回傳 head,於是 X 會被接到 head 後面、落在 index 1,位置就錯了。
index >= this.length 這行交給 append,少了它連結反而是對的,X 確實會接在 E 後面,但 this.tail 還指著 E,invariant 裡「tail 指著最後一個 node」那條就壞了。一個是連結接錯位置,一個是連結對但整體資訊沒跟上。
另外,這兩行也解決了空 list 情況,空 list 的 length 是 0,任何 index 都會落進其中一個特例,traverseToIndex 永遠不會在沒有 node 的 list 上被呼叫。
成本上,改連結固定就是那兩行,走過去才是花時間的部分,因此 insert 是 O(N),插在開頭那個特例是 O(1)。
那如果要把 C 從清單裡拿掉呢?
刪除和插入一樣要分兩種情況,刪的是 head,還是不是 head,理由也一樣,head 前面沒有 node,沒有人能替它改連結。
先看不是 head 的情況,要把 C 拿掉,就讓 B 的 next 跳過 C,直接指 D,比插入單純一些,因為新的連結只有一條要接。要拿到的也一樣是 index - 1 那個 node;拿到之後 previous.next 就是要刪掉的那一個,把它的 next 抄過來給 previous,C 就從這條路上消失了。
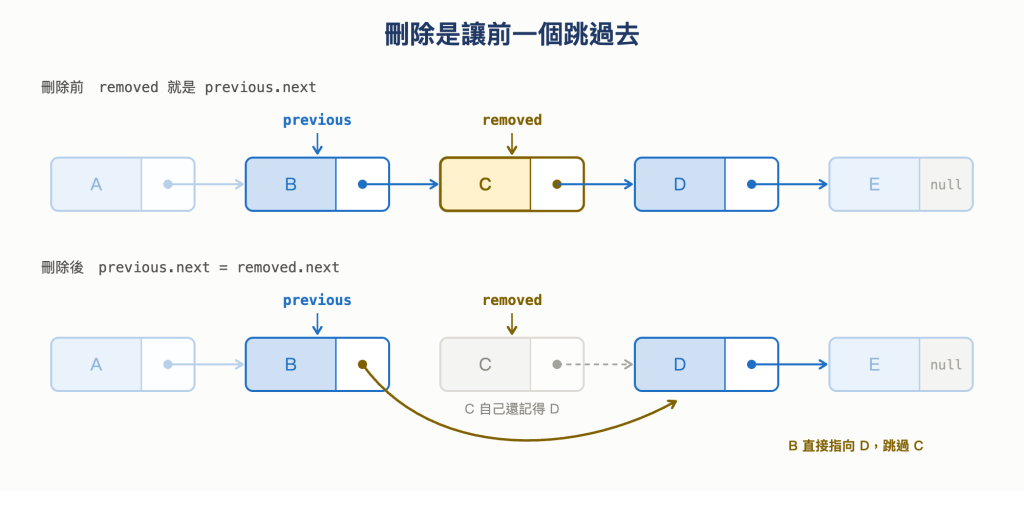
圖 3 刪除是讓前一個跳過去
另一種情況是刪掉 head,這時不需更動其他 node,把 this.head 移到第二個 node 身上就好,而這也是唯一一個完全不用走路的刪除,所以是 O(1)。
寫成程式如下:
remove(index) {
  if (index < 0 || index >= this.length) return null;

  if (index === 0) {
    const removed = this.head;

    this.head = removed.next;
    if (this.head === null) this.tail = null;
    this.length--;

    return removed.value;
  }

  const previous = this.traverseToIndex(index - 1); // 找要刪掉的前一個
  const removed = previous.next; // 要刪掉的前一個的下一個 = 要刪掉的那個

  previous.next = removed.next;
  if (removed === this.tail) this.tail = previous;
  this.length--;

  return removed.value;
}
removed 這個變數是為了最後要回傳被刪除的那個值,所以先把它存起來,以免 previous.next 一改,就找不到剛剛被移出去的那個 node。
另外,被刪掉的那個 C 其實沒有被清掉,自己的 next 還指著 D,只是清單裡再也沒有人指著它,從清單的角度看它已經不存在了。等到沒有任何東西指向它,JavaScript 的垃圾回收才會把那塊空間收走,這也是為什麼刪除不需搬移任何資料。
一邊走訪一邊刪的時候,這件事會差很多。假設有 1,000 封信要逐一檢查,符合條件的就刪掉,最後刪了 100 封。
我們可以用 Array 或 Linked List 兩種結構來處理,兩種結構的走訪都是 1,000 步,而兩者的差別則在刪除的那個步驟。Linked List 每刪一筆就是改一條連結,100 筆共 100 步,全程大約 1,100 步。Array 每刪一筆都要把後面的元素往前挪一格,而被刪的位置平均落在中間附近,所以每筆大約要搬 500 格,100 筆就是 5 萬步左右,全程 51,400 步。
乍看之下,Linked List 看起來蠻有優勢的,不過這優勢還有個前提,就是走訪和刪除得在同一趟裡完成。邊走邊刪的時候,那 1,000 步的走訪只有一次成本,100 次刪除和它共用成本,可以說每次刪除幾乎不用額外成本。但如果換成已經知道要刪哪幾個 index、再一筆一筆呼叫 remove,每次刪除都得自己從 head 走一趟,走訪就從 1 步變成 100 步。
head 和非 head 這個分支情況解決了連結該怎麼改,但 remove 還有幾個情況要考慮,它還要顧的是 tail 和 length 這些資訊,前言那份 invariant 才會在操作結束後繼續成立。
第一個是刪掉 tail,連結的部分和一般情況相同,previous.next 抄過來的 removed.next 剛好是 null,invariant 裡「tail.next 是 null」那條自動成立。要補的是另一個狀況,this.tail 還指著剛剛被移出去的那個 node,得改成指 previous。
第二個是清單只剩一個 node 時刪掉它,這一個 node 同時是 head 也是 tail,兩個入口都要處理,this.head 會變成 null,而 this.tail 如果沒有跟著歸零,就會一直指著一個已經不在清單裡的 node。
最後是 index 根本不對的情況,包含負數、超過長度,以及在空清單上刪除,這些一律在最前面就回傳 null。
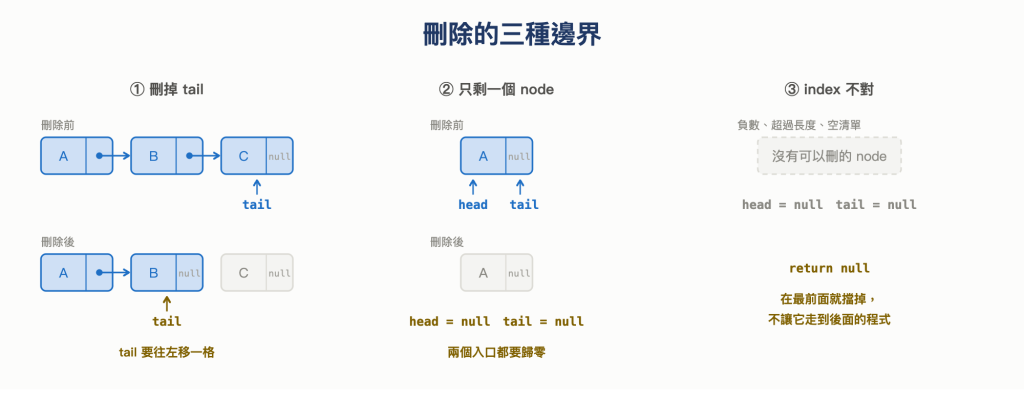
圖 4 刪除的三種邊界:連結怎麼改都一樣,難的是 tail 與 length 這些整體資訊
如果不想每次都區分 head 和非 head 兩種流程呢?有一個做法是在真正的第一個 node 前面,再放一個不存資料的 node,一般叫做 dummy head,它的 next 指向原本的 head,等於把 head 也變成一個「有前一個」的普通 node。這樣每個 node 都保證有前一個可以改,插入和刪除就都能統一成「對前一個 node 操作」,不用再分 head 和非 head 兩種情況。
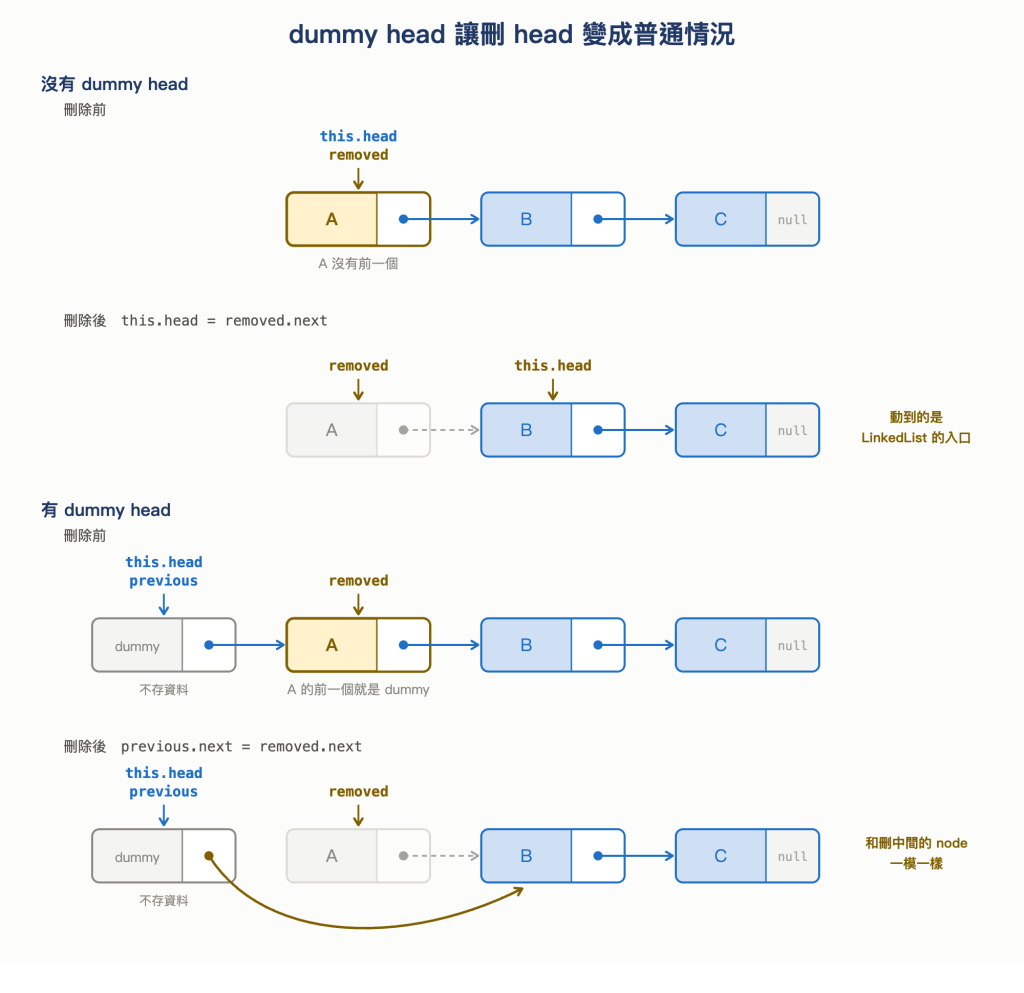
圖 5 dummy head 讓刪 head 變成普通情況
dummy head 改寫成程式會長這樣:
class LinkedList {
  constructor() {
    this.head = new Node(null); // dummy head,不存資料,也不算進 length
    this.tail = this.head;
    this.length = 0;
  }

  remove(index) {
    if (index < 0 || index >= this.length) return null;

    const previous = this.traverseToIndex(index); // 從 dummy 走 index 步
    const removed = previous.next;

    previous.next = removed.next;
    if (removed === this.tail) this.tail = previous;
    this.length--;

    return removed.value;
  }
}
和前面那版相比,index === 0 處理 head 的那個分支不見了,走訪的起點從第一個真正的 node 換成 dummy,所以原本的 index - 1 變成 index,dummy 剛好佔住了那個不存在的 index -1。而刪到最後一個 node 時,this.tail 會退回 dummy 身上,空清單就是 head 和 tail 同時指著 dummy,不必另外歸零。
dummy head 讓寫程式省事不少,但它也有代價:
換句話說,dummy head 是拿空間換寫程式的方便,值不值得就要看當下的情況。
最後一個操作是把整條清單反轉,讓 E 變成第一個、A 變成最後一個,也就是 reverse linked list。
先思考一下大概的流程,反轉不是把 node 重新排列,而是把每一條 next 都改成指向原本的前一個,A 原本指 B,反轉後要指 null;B 原本指 C,反轉後要指 A。
這裡的問題和插入時遇到的類似,走到 B、要把它的 next 改成指 A 的時候,C 在哪裡就只剩 B 的 next 知道,一改就走不下去了。所以每一輪都要先把「下一個是誰」存起來,再改連結。
也就是說每一輪手上要握著三樣東西:
previous)current)next)reverse() {
let previous = null;
let current = this.head;
while (current) {
const next = current.next;
current.next = previous;
previous = current;
current = next;
}
[this.head, this.tail] = [this.tail, this.head]; // 最後把頭尾交換
return this;
}
第一行 const next = current.next 把還沒處理的那一段存起來,第二行才改 current.next,最後兩行把 previous 和 current 各往前挪一格,讓下一輪重複同樣的事。
previous 的起始值是 null,因為第一輪處理的是 A,而 A 反轉後會變成最後一個,next 本來就該是 null。
把五輪逐步畫出來,比較清楚在做什麼:
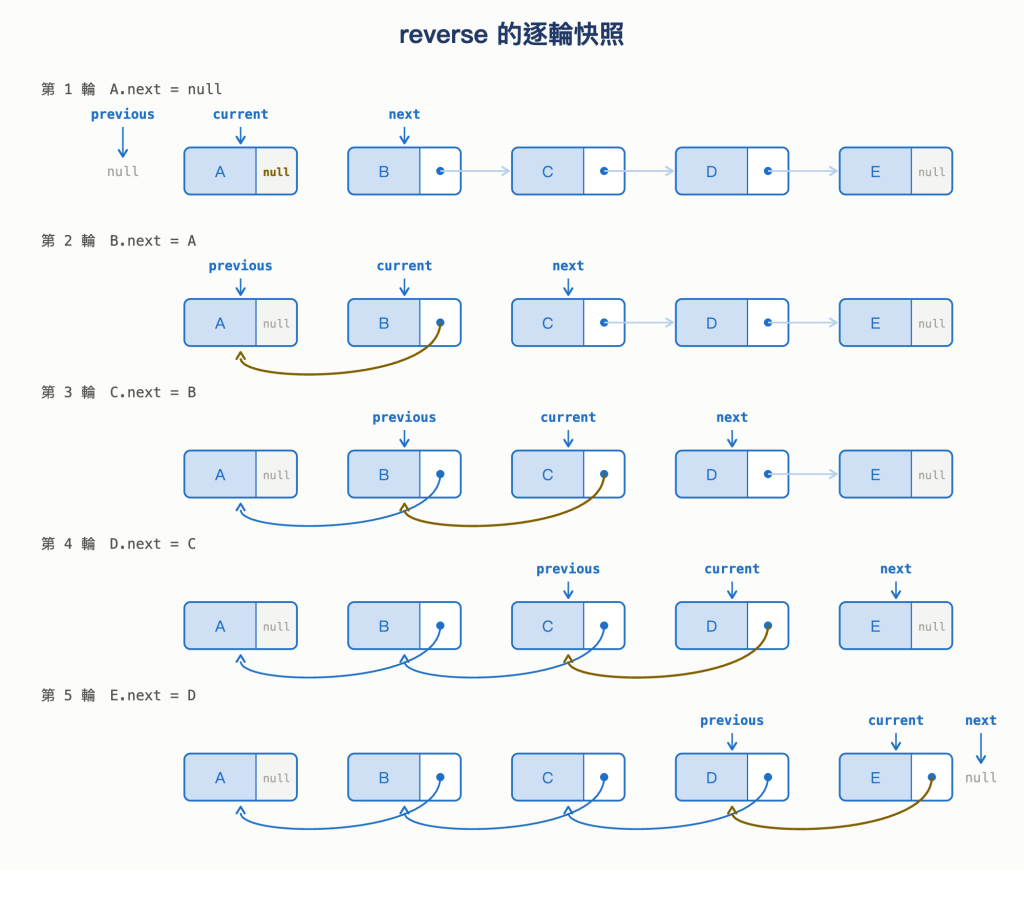
圖 6 reverse 的步驟示意圖
可以看到三個標記每一輪都往右挪一格,previous 永遠停在 current 的前一格、next 停在後一格,三個變數其實是同一條清單上相鄰的三格,只是一起往前移動。
那迴圈跑到一半時,這條清單長什麼樣子呢?其實這時候它是壞的。前半段已經全部反過來、後半段還沒動,而 this.head 還指著 A、A 的 next 卻已經變成 null,我們如果這時候從 head 走訪,只會拿到一個 node。要等到最後那行交換完,invariant 才會重新成立。而 previous 和 current 存在的意義也在這裡,它們在這段中間狀態裡替前後兩段各留一個入口。
迴圈結束時 current 是 null,previous 則停在 E,也就是新的第一個 node。至於最後那行交換,反轉之後新的 head 是原本的 tail、新的 tail 是原本的 head,把兩個入口對調就好。成本上,整條清單走一遍是 O(N),而不管清單多長,額外用到的變數永遠是那三個,因此 Auxiliary Space 是 O(1)。
另一種 reverse 的做法是先把所有值倒進一個 Array、反過來再寫回每個 node。這樣好寫很多,也不會踩到順序問題,但要多花 O(N) 的空間,而且它並沒有反轉這個結構,只是把值搬了位置。Linked List 該做的事情是改連結,繞回去搬資料就失去用它的理由了。
把今天三個操作的成本拆開來看,整理如下表:
| 操作 | 找位置 | 改連結 | 合計 |
|---|---|---|---|
| 插在開頭 | 不用找,head 在手上 | 2 行 | O(1) |
| 插在中間 | 走到 index - 1 |
2 行 | O(N) |
| 插在尾端 | 不用找,tail 在手上 | 2 行 | O(1) |
| 刪開頭 | 不用找 | 1 行 | O(1) |
| 刪中間 | 走到 index - 1 |
1 行 | O(N) |
| 刪尾端 | 走到 index - 1 |
1 行 | O(N) |
| 反轉 | 走完整條 | 每個 node 1 行 | O(N) |
不過插在尾端和刪尾端這兩個操作,成本為什麼會差這麼多呢?插入在尾端是 O(1),刪除尾端卻是 O(N),明明兩個都在動同一個位置,且 tail 都在手上,差別在於插入要改的是 tail 自己的 next,而刪除要改的是 tail 前面那一個的 next,tail 這個變數幫不上忙,還是得從 head 走一趟。這個不對稱不是實作寫得不好,而是結構造成的。
目前為止,我們介紹的 Linked List 結構,每個 node 只存一個連結 next,正式名稱是 Singly Linked List(單向連結串列),可以走的方向從一開始就只有一個。
回想一下今天寫的兩個方法,會發現它們都在做同一件麻煩事:明明知道要動哪個 node,卻得先從 head 走一趟去拿它的前一個。
如果手上已經有 C 這個 node 呢?直覺上應該可以直接把它刪掉,但實際上做不到。刪除要改的是 B 的 next,而 C 手上只有一張寫著「下一個是 D」的紙條,沒有任何線索能回頭找到 B。所以在 Singly Linked List 上,能做到的是「把你後面那一個刪掉」,而不是「把你自己刪掉」;想刪自己,就得從 head 重新走一次 O(N)。
用方法名稱來說也許會更清楚,Singly Linked List 真正能提供的操作是 removeAfter(node),而不是 removeHere(node)。今天寫的 remove(index) 表面上收的是一個 index,內部做的其實就是先走到 index - 1 那個 node,再對它做一次 removeAfter。整篇一直說「我們需要的 node 在 index - 1」,換個角度看就是這個結構只給了我們 removeAfter 這種能力。
那怎麼辦呢?有個巧妙辦法是,既然改不到前面那條線,那就換個方式,把下一個 node 的值複製到自己身上,然後跳過下一個,效果就等於刪掉自己。
function deleteHere(node) {
  node.value = node.next.value;
  node.next = node.next.next;
}
假設要刪除 C,它的值會先被 D 覆蓋,然後它的 next 跳過原本的 D 直接指 E,清單從外面看變成 A→B→D→E,結果和刪掉 C 一樣。實際被移出清單的是 D 那個 node,被刪掉的值卻是 C。
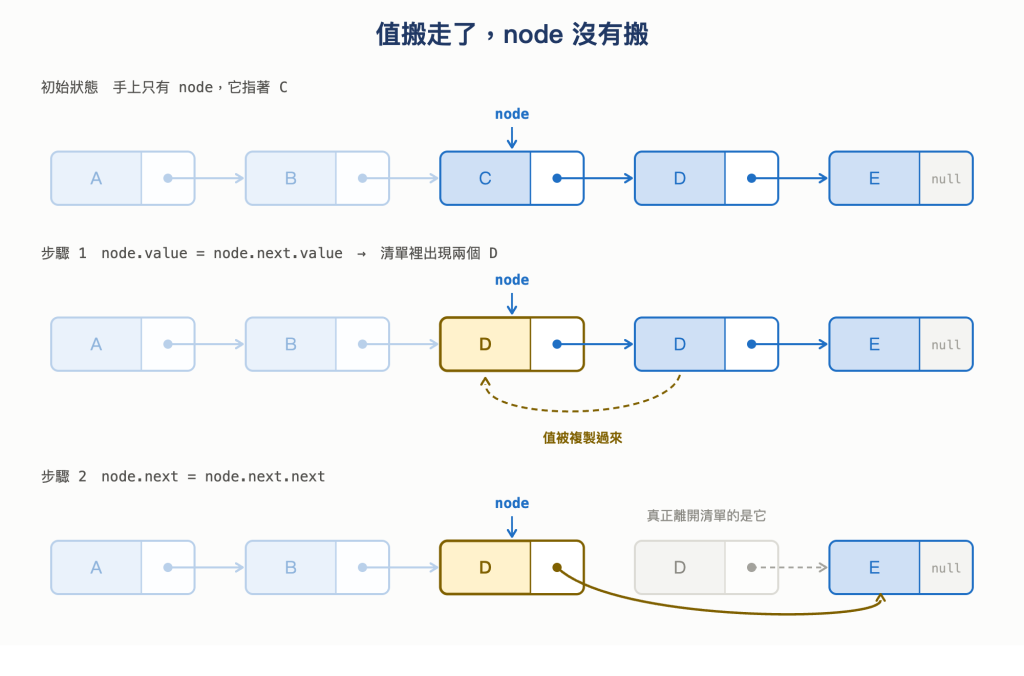
圖 7 值搬走了,node 沒有搬:被移出清單的是下一個 node,被刪掉的值才是這一個
這招有個限制,它不能用在 tail,因為 tail 沒有下一個 node,沒有值可以複製過來,也沒有東西可以跳過。而且這做法動到了資料本身,如果程式其他地方正握著那個 node,會發現手上的值突然變了。
因此這只是一個 workaround,不是真正的解法,而真正的解法是讓 node 除了記住下一個,也記住上一個,這就是 Doubly Linked List(雙向連結串列)。node 會記住 prev 和 next 兩件事:
class Node {
  constructor(value) {
    this.value = value;
    this.next = null;
    this.prev = null;
  }
}
比較 Singly 與 Doubly Linked List 的結構,差別如下:
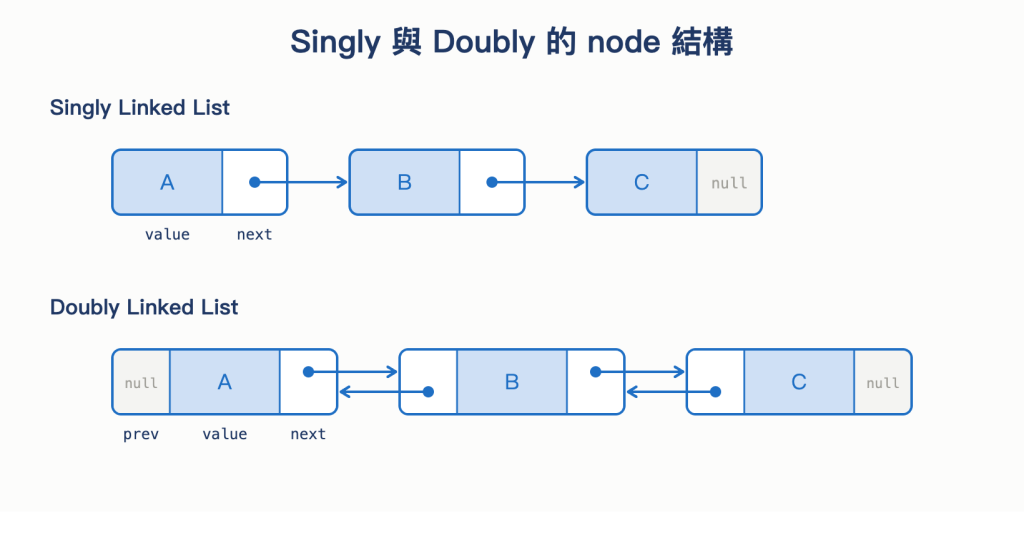
圖 8 Singly 與 Doubly 的 node 結構
有了 prev 之後,前面那個做不到的操作就直接成立了:
removeHere(node) {
  if (node.prev) node.prev.next = node.next;
  else this.head = node.next;

  if (node.next) node.next.prev = node.prev;
  else this.tail = node.prev;

  this.length--;

  return node.value;
}
不需要走訪,也不需要知道 index,手上有 node 就能刪掉它,成本是 O(1)。兩個 if 處理的是這個 node 位在頭或在尾的情況,沒有 prev 表示它是 head,沒有 next 表示它是 tail,這時候要改的是 LinkedList 的入口而不是連結,和前面提的邊界狀況類似。
不過 Doubly Linked List 也有代價:
而且寫錯一邊很難發現,因為清單從某個方向走起來完全正確,而多數測試也只會往一個方向走。
將 Singly 與 Doubly Linked List 整理成一張表如下:
| Singly | Doubly | |
|---|---|---|
| 每個 node 存的連結 | 1 個 | 2 個 |
| 手上有 node 時刪掉它 | 做不到,要從 head 重找 O(N) |
O(1) |
| 從尾端往前走 | 做不到 | 可以 |
| 改一次連結要動的線 | 1 條 | 2 條 |
| lookup | O(N) |
O(N) |
實際怎麼選,取決於會不會用到 prev,只往一個方向走、又希望節省記憶體時,Singly 就夠了。反過來,需要往回走,或情境常常是「手上已有這個 node,現在要把它移掉」,那多存 prev 所付出的代價就值得。
之前有提過 JavaScript 沒有內建 Linked List,但其他語言有的話,內建的幾乎都是 Doubly Linked List,例如 Java 的 LinkedList,文件第一句就寫著「Doubly-linked list implementation of the List and Deque interfaces.」。C++ 的 std::list 也是,實作上每個元素存兩條連結;另外 std::forward_list 則是單向的,每個元素只留一條,只能往前走。
這裡小小延伸一下實務應用,稍微看一下 Linux kernel 的做法。昨天和今天寫的 Linked List 裡面的 node 都是自己裝著資料,而實務上還有一種相反的做法,是讓資料裝著 node。
kernel 內部有很多型別各不相同的東西需要串起來,而 C 沒有泛型可用,node 裡的欄位型別一寫死,這個 node 就只能服務那一種資料。kernel 的解法是讓 node 只有兩條線、沒有任何資料欄位,想加入 list 的資料自己把它嵌進來當一個欄位:
struct list_head {              // node 只有兩條線,沒有資料
    struct list_head *next, *prev;
};

struct task_struct {            // kernel 用來記錄一個 process 的結構
    int pid;
    char comm[16];
    struct list_head tasks;     // 把 node 嵌進自己身上
};
這樣做的好處是,list_add、list_del 這些操作 list 的函式只需要寫一份,就能服務所有型別。因為它們從頭到尾只碰 next 和 prev,碰不到資料,也就不必知道外面包的是哪一種結構。這種把 node 嵌進資料裡的做法一般稱為 intrusive list。
代價則是在走訪時,next 指向的是下一個 task_struct 的 tasks 欄位,不是它的開頭,而我們想讀的 pid 在那個欄位外面。
那要怎麼從 tasks 回到整份 task_struct 呢?kernel 用一個叫 container_of 的巨集,而它的原理是減法:C 的 struct 在記憶體裡佔連續的一段,每個欄位從開頭數過去是第幾個 byte,在編譯時就固定了。以上面那個結構來說,tasks 固定在第 24 個 byte,所以如果某個 task_struct 從位址 8000 開始,它的 tasks 就在 8024;走訪時手上拿到 8024,減掉 24 就回到 8000,整份資料就都讀得到了。
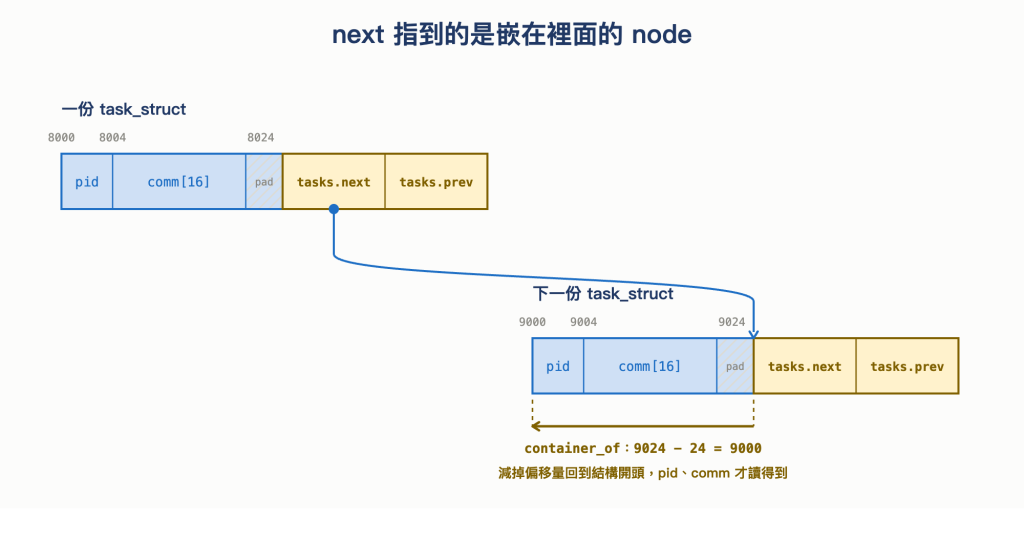
圖 9 next 指到的是嵌在裡面的 node,不是整份資料的開頭
為什麼是 24 而不是 20 呢?pid 佔 4 個 byte、comm 佔 16 個,加起來是 20,但 list_head 裡面是兩個指標,需要從 8 的倍數開始,所以編譯器在中間補了 4 個 byte 的空隙。這也是為什麼實際寫的時候要用 offsetof 去問編譯器那個偏移量,而不是自己數。另外,這種拿位址做加減的事 JavaScript 做不到,因為根本拿不到位址那個數字,正是 Day 09 提過的 C pointer 與 JS 參照的差別。(有興趣的可再參考 Reference 的連結~)
小小總結一下今天對 Linked List 操作的認識~
prev 之後差在哪? 換到了往回走和 O(1) 就地刪除的能力,代價是每個 node 多一個欄位,而且每次改動要維護兩條線而不是一條。next 改成指向原本的前一個,過程中靠三個變數讓已處理和未處理的兩段都保持接得到。最後補充幾點~
index - 1 那個 node,因為改連結的人是前一個。O(N) 花在走過去,所以「邊走邊改」省下的是那一趟走訪,先查 index 再一筆一筆改,每次都得重走一遍。Day 09 提過 cycle 通常是改連結的時候接錯了,今天把改連結的三種操作都寫過一遍,也就看到那些錯是怎麼發生的。而到目前為止,Array 和 Linked List 都是在談「資料實際怎麼存」,下一篇要換一個角度,看一種只在意「能做什麼操作」的結構~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。
LinkedList
std::forward_list
include/linux/list.h


 iThome鐵人賽
 看影片追技術