
第三幕結束在一個沒解決的問題上:四把尺量的都是「測試做了什麼動作」,沒有一把量得到「它以為的正確答案對不對」。
要判斷期望值對不對,得先有一個知道正確答案的東西。測試領域管它叫 oracle。
這個系列用過四種,每一種都出過事:
| 哪一天 | oracle 是什麼 | 出了什麼事 |
|---|---|---|
| Day 6 | 影子模型 | 兩邊都寫 r/12,五百組差分完全一致,而且都錯 |
| Day 7 | golden set | 它鎖的是「現在怎麼動」,不是「應該怎麼動」 |
| Day 9 | PRD + 人的裁決 | 寫不清楚的地方就留洞 |
| Day 20 | 現有測試的斷言 | 斷言弱,分數照樣漂亮 |
共同點:每一個都是人做的決定。 不是算出來的,是有人判斷過「什麼叫對」。
而 AI 寫測試時,它的 oracle 就是它自己。
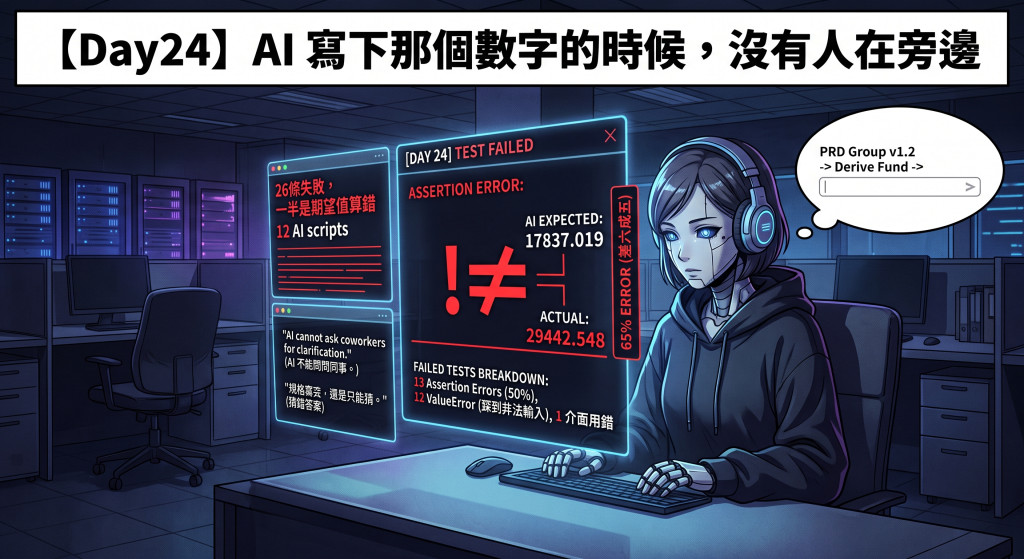
Day 22 的二十份腳本,十二份在未修改的實作上就是紅的。把它們逐條跑一次,按 pytest 印出的例外分類:
| 分類 | 條數 |
|---|---|
期望值算錯(AssertionError) |
13(50%) |
踩到非法輸入(ValueError) |
12(46%) |
| 介面用錯 | 1(4%) |
原始計數是 38 條,去重後 26 條:一個壞掉的共用 fixture 會讓五條測試一起紅,那要算一個錯,不是五個。兩個分母都列在 manifest.yaml,因為分母是我自己挑的。
assert 17837.01923076923 == 29442.548076923 ± 0.001
這條來自 run-A-PRD-05,完整規格那一組。它拿到 PRD v1.2 全部十二條條款:有公式、有索引定義、有通膨基準年鎖在哪一年。
它讀完,推導,寫下 17837.019。實際是 29442.548。
這並非因為「規格寫得不夠細」:Day 22 已經證明規格細度決定測試的天花板,而它拿到的已經是最詳細的版本。
規格完整、推導有據、數字錯了,而且沒有任何東西能在它寫下那一刻告訴它錯了。
一個 QA 卡在「這個值該是多少」的時候,手上有幾條路:自己用計算機算一遍、翻舊案例、問旁邊的同事、問 PM「規格這段我讀成這樣對嗎」,或者最誠實的那個:先不寫,標記待確認。
AI 手上只有提示詞。它寫下 17837.019 那一刻,那個數字的唯一來源是它自己對那段文字的推導。鏈上沒有第二來源,也沒有「等一下我去確認」這個動作。
它唯一能做的自保,是昨天那份產物留下的那句:
PRD-10 中
other_income規格未明確定義為月額或年額,跳過精確數值測試以免斷言失準
宣告自己不知道,是它能做的極限。遇到盲區時,如果叫另一個模型來核對,結果也是徒勞(Day 2 就劃過這條界),因為第二個模型同樣拿不到超出規格外的新資訊;若是交給人類親自核算 17837.019 這個數字,得把二十一年的提領期與通膨指數一項一項算過,成本跟自己重寫一條測試幾乎沒有區別。
當一份腳本有三十幾條斷言、每條都是七位數時,去核對它的代價實在太高。在這個代價下,所謂的「由人來把關」形同虛設。
既然「絕對答案是多少」核不動,不如轉換視角:
不再糾結絕對值,只問兩次執行之間該有什麼關係。
把所有金額放大十倍,目標金額該不該剛好也是十倍?把預期壽命延長一年,需要的錢該不該只增不減?這兩個問題不需要知道任何一次的正確答案就能回答,而且只要實作把公式寫錯,關係就會破。
這叫蛻變測試:不驗單次執行的絕對值,驗多次執行之間的蛻變關係。
對這個系列來說,它的意義不是多一種測試方法,而是:
它把要人審的東西,從「一個七位數」換成「一句關係」。
17837.019 對不對,我核不動。「金額 ×10,結果該 ×10」對不對,我三秒就能判。
但這種方法依然有漏洞。Day 22 有一份腳本忠實性 100%、全綠、殺傷力 0%,因為它驗的是 assert ls.age == 50(期望值正確,而且毫無意義)。換成關係也一樣:「金額變大,目標金額應該變大」這種恆真的廢話永遠不會紅。形式換了,這個病沒換。 那筆帳依然留著。
這支分類器壞了兩次,兩次都印出了看起來很合理的數字。
第一次好發現:沒附訊息的斷言,pytest 印的是 assert a > b 而不是 AssertionError,十一條被丟進「待人工覆核」。整欄都是待覆核,很刺眼。
第二次不一樣。例外在受測物裡拋出時,pytest 印的路徑是 shadow/calc_fixed.py 而不是測試檔,而我的過濾條件寫著「路徑要含 test_」,導致整個「踩到非法輸入」類別被系統性刪掉了。
當時報表印的是:期望值算錯 14%。沒有欄位空著,沒有一行異常,比例加起來剛好 100%。
我盯著那個 14% 想了一下,覺得「嗯,比預期低」。差一點就這樣寫下去了。
救回來的是後來加的對帳:比對「pytest 自己說有幾條失敗」和「我解析到幾條」,十二份裡十份對不上,直接中止。而我原本那道守衛只擋「一條都沒解析到」,它在 14% 那次完全沒觸發:因為確實解析到了東西。
能擋住「完全沒資料」,但防不住「少了六成」。
工作上最常見的長相,是報表某個維度忽然變好看。可能真的變好,也可能是那個維度的資料源斷了、只剩一部分還在進來。兩種在畫面上一模一樣,而且後者通常更好看。
現在我對「比預期低」跟「比預期好」用同一個反應:先去對分母。
這些比例不能拿來做什麼
十二份產物來自同一廠牌、同一組提示詞,不是獨立樣本。分類只看例外型別與訊息,不讀原始碼、不判斷「它為什麼那樣寫」。
有四條失敗長得很像 Oracle Problem:四份產物都把 balances_raw 的長度算錯了。但它們全部來自一句話那一組,完整規格那組無一犯錯,所以那是 Day 22 已量過的規格效應,不算在今天的論點裡。
「人可以去問、AI 不能問」是結構描述,不是量測。它成立的前提是這一輪的設計:全新對話、工具全關、不得反問。
逐份分類、原始輸出與限制在 manifest.yaml 與 raw/。
只帶走一件事
一個 QA 不確定的時候可以去問。
AI 不確定的時候,只能猜,然後把猜的結果寫成assert。
明天會先寫出四條蛻變關係。但寫出來只是第一步,一條關係也可能是毫無價值的廢話。必須先有能力判斷關係的品質,才有資格拿它去量測別人。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day24


 iThome鐵人賽
 看影片追技術