
昨天量的是「規格細度決定測試的天花板」。今天換一個角度看同一批腳本:它們挑的數字長什麼樣?
這件事Day 12 在文件層做過:把「規格寫了小於等於,就該有前一格、剛好、後一格」這個 QA 直覺寫成 bva_checker.py。當時量的是自然語言案例集。今天量的是可執行的 pytest 腳本。
判定的部分直接重用那支檢核器,同一條尺量兩層,數字才可比。新寫的只有取樣器。
這是整件事最麻煩的一步。
p = Params(current_age=30, retirement_age=65, life_expectancy=85, ...)
assert calculate(p).target_fund == 22938825.0
第一行的 30、65、85 是輸入,第二行的 22938825.0 是期望值。把後者算進「金額的分佈」,會得到一堆七位數,結論整個歪掉。
規則寫死兩條:
assert 節點底下的數值 → 期望值,排除第二條刻意只認欄位名,不認函式名。產物幾乎都會包一層自己的 helper(_p(...)、get_valid_params(...)),認 Params( 會整批漏掉。
還有一個老問題又出現了。產物常寫成 get_valid_params(retirement_age=65),呼叫點只看得到一個欄位,其餘來自預設值。Day 12 在文件層撞過同一件事(「同上」「其餘同 baseline」),到了代碼層它換個樣子又出現一次。處理方式是把欄位最多的那一處當基準情境併進去,並且把這個動作印出來:它是推論,不是讀到的事實。
事前假設是 Round-Number Bias:AI 會集中在 30、60、65、85 這種年齡,金額集中在一萬的倍數。
| 年齡是 5 的倍數 | 金額是一萬的倍數 | |
|---|---|---|
| 一句話組(Pro) | 100%(n=93) | 57% |
| 一句話組(Flash) | 99%(n=155) | 72% |
| PRD 組(Pro) | 80%(n=179) | 36% |
| PRD 組(Flash) | 95%(n=316) | 56% |
| golden set(人寫) | 72%(n=82) | 67% |
年齡那一欄假設成立,而且比想像中極端:一句話組九十三個年齡,沒有一個不是 5 的倍數。 人寫的是 72%。
金額那一欄則相反。PRD 組只有 36% 是整萬,比人寫的 67% 還低。
這點可以從取值清單看出差異:
| 最常出現的金額 | |
|---|---|
| AI | 1000、100、10000、50000 |
| 人 | 30000、800000、19391、24000 |
那個 19391 是真實情境裡抄下來的數字。二十份 AI 產物,一個都沒有。
AI 挑的是好手算的數:它要自己推出期望值,1000 比 19391 好乘。人挑的是像真的數,因為人寫 golden set 的目的是鎖住真實行為。
「AI 偏好整數」這個講法不夠精確。兩邊都有偏誤,只是方向不同:AI 挑好算的數,人挑像真的數。
事前假設的後半是「邊界 ±1 幾乎為零」,這個假設被數據推翻了。
把同一格五份的案例池在一起,看四條年齡關係式有沒有被打到(需要同時出現界內一步、剛好、界外一步,才算滿分):
| 現齡 < 退休年齡 | 退休 < 壽命 | 大筆支出不早於退休 | 大筆支出不晚於壽命 | |
|---|---|---|---|---|
| 一句話組(Pro) | 0% | 0% | 0% | 0% |
| 一句話組(Flash) | 67% | 33% | 0% | 33% |
| PRD 組(Pro) | 67% | 67% | 100% | 67% |
| PRD 組(Flash) | 67% | 67% | 67% | 100% |
| golden set(人寫) | 0% | 67% | 33% | 33% |
| 行為測試(人寫) | 0% | 0% | 0% | 0% |
PRD 組的命中率高於人寫的兩份對照。
一句話組四條全 0,它連有邊界這件事都不知道。而 PRD 組開始出現 61、62 這種年齡,那是為了構造相鄰年份硬擠出來的。規格寫了「現齡小於退休年齡小於預期壽命」,它就真的去把兩個年齡貼在一起試。
這是今天最意外的結果。規格夠細的話,AI 的邊界意識不比人差。
但若檢視那些命中邊界的案例,會發現這份 100% 命中率背後有隱患。
run-A-PRD-02 這份產物裡有這條測試:
def test_prd_04_validation():
    """PRD-04: 輸入校驗,不符規定時拋出例外"""
    invalid_params = [
        # A_r < A_d 不成立
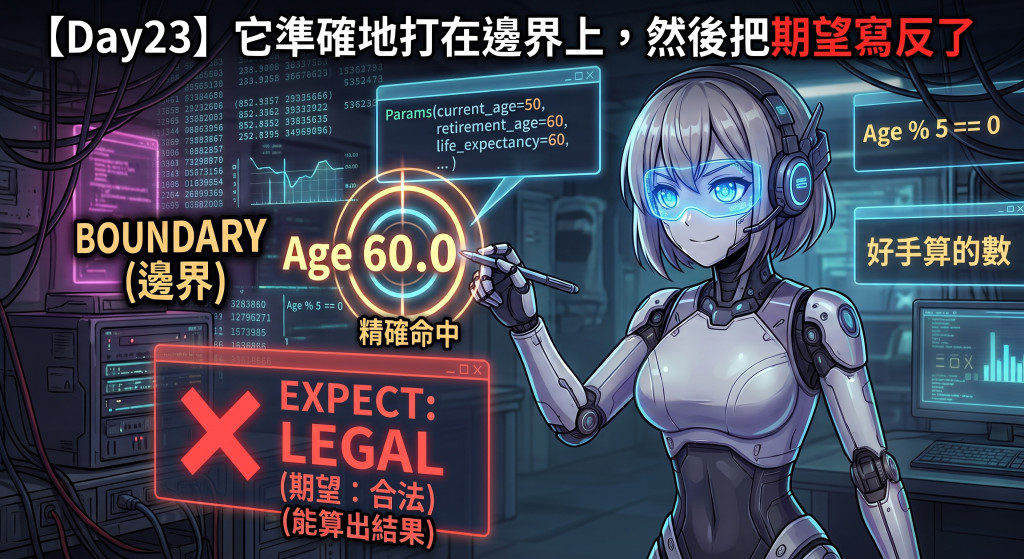
        Params(current_age=30, retirement_age=60, life_expectancy=60, ...),
        ...
    ]
它把「退休年齡等於預期壽命」列進非法輸入清單,寫了一條測試驗這種輸入必須拋錯。判斷完全正確。
而同一個檔案往下十幾行:
def test_prd_05_lump_sum_inflation():
    p = Params(current_age=50, retirement_age=60, life_expectancy=60, ...)
    res = calculate(p)          # ← 期待拿到一個結果
同一組非法值,這次它期待算出一個數字。
同一份產物、同一個邊界點,一條知道它非法,另一條把它當作合法用。後面那條就是昨天讓它在基準線那一關掛掉的原因之一。
人寫的 golden set 也踩了同一個點:def_b_equal,壽命等於退休年齡,但期望欄寫的是「被拒絕」。同一個座標,差別只在期望值。
而我的取樣器對這兩種情況一律報「命中」。它看的是輸入落在哪裡,完全不看期望寫的是什麼。
若將「邊界命中率」設為團隊 KPI,結果會很荒謬。
AI 會準確打到每一個邊界,然後把期望寫反,報表上依然是一片綠。這反映在今天的實驗數據上:命中率高達 100%,但其中一半的期望是錯的。
第三幕蓋了四把尺,每一把都在同一個地方失手:
| 尺 | 量得到 | 量不到 |
|---|---|---|
| 斷言忠實性 | 斷言嚴不嚴 | 在驗什麼 |
| 行覆蓋率 | 程式碼跑過沒 | 跑過的有沒有被檢驗 |
| 變異分數 | 改壞了會不會叫 | 目錄外的錯法 |
| 邊界命中率 | 打到邊界沒 | 打到之後期望對不對 |
四把尺量的都是「測試做了什麼動作」,沒有一把量得到「那個動作的期望值對不對」。 因為要判斷期望值對不對,得有一個知道正確答案的東西,而那正是這整個系列一開始就沒有的:一個 oracle。
取樣器寫完,第一個拿去測的是人寫的 test_golden_v2.py,結果印出的輸入數值是 0 個。
這是因為那 23 組案例全由 JSON 讀入,程式碼裡本來就沒有硬編數字。0 這個結果是正確的,但它帶來另一個風險:若忽略了這個實作細節,這個 0 極可能被過度解讀為「人寫的測試完全沒有硬編數值,品質極佳」。量測本身正確,解讀出的結論完全相反,且過程中沒有任何機制能攔截這個謬誤。
這種東西在工作上最常見的長相是掃描報告全綠。綠可能是真的沒問題,也可能是路徑設錯、掃描器根本沒讀到那幾個檔案。兩種報表長得一模一樣,而且都很好看,很容易就貼進週報了。
這個系列已經抓到兩次同型的了。Day 14 的校準器,在沒裝 pytest 的環境下會讓「必錯組」全部假通過;Day 17 的覆蓋率探針,測試沒跑完照樣印得出比值。三次都是同一句話:工具在什麼都沒做的時候,印出了一個看起來很合理的數字。
所以這支取樣器加了一條:全部加起來抽到零個輸入時直接中止。與其印一個 0%,不如什麼都不印。JSON 的讀法也是那天補的,對照組不該因為換了檔案格式就消失。
這些數字不能拿來做什麼
二十份腳本全部來自同一廠牌、同一組提示詞,不是獨立樣本。人寫的對照只有兩份,而且都是我自己寫的,沒有第三方基準,「AI 比人整」這句話的「人」只有一個。
基準情境的併入是推論,不是讀到的事實,它會影響邊界命中的分母。取樣器把這個動作印在報表上,但推論就是推論。
「邊界命中率不看期望值」是這支工具的設計缺陷,也是今天要示範的東西。這不是 bug,是刻意留著的展示品。真要修,得讓它去讀 assert 那一側,而那又是另一把新尺。
逐格的分佈、取值清單與四條限制在 manifest.yaml。
只帶走一件事
所有量測測試品質的指標,量的都是「測試做了什麼」。
沒有一個量得到「它以為的正確答案對不對」。
第三幕到此為止。四把尺全部失手在同一個地方:沒有 oracle,就判不了期望值的對錯。
這引出了第四幕的核心問題:測試時,有沒有可能根本不需要知道正確答案?
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day23


 iThome鐵人賽
 看影片追技術