
昨天的四條蛻變關係,結尾留了一個預測:AI 大概寫不出「對帳」那一種。
今天去驗。同一份規格只換一句話:不要算出答案,寫出關係。兩臺模型(gemini-3.1-pro-preview 與 gemini-3.8-flash)各跑五次,十份產物、143 條關係。
預測兌現了,但那不是今天最值得寫的。真正的是:沒有魔術數字的測試,不會比較好 review。
先過 Day 22 那條流水線:
第一項的提升有結構性成分:蛻變關係不必推導數值,Day 24 那種「期望值算錯」的失敗方式在本輪根本不存在,不宜當成模型變強。
那唯一一條紅的錯在單位。它主張「固定年支出與其他收入同時調增相同金額,目標金額不變」,理由是「兩者通膨基準都是現齡」,理由完全正確,但固定年支出是年額、其他收入是月額,程式裡會再乘十二。兩邊各加二十萬,實際差了十二倍。
推理對,關係錯,而斷言檢核器給這份 100% 忠實性:忠實性量的是斷言有沒有忠實表達它宣告的意圖,不是那個意圖對不對。
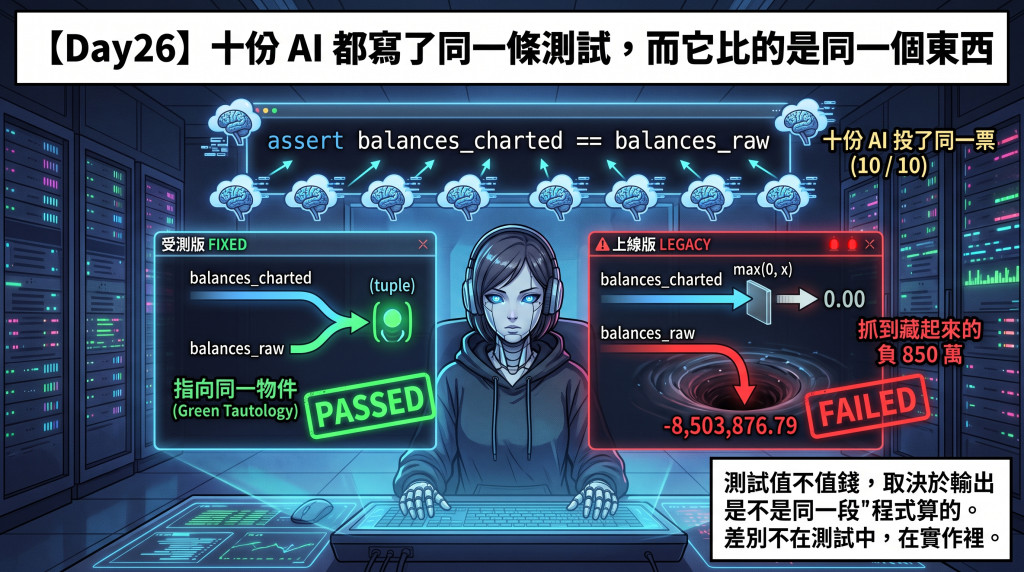
在 143 條關係中,有一條是十份產物全部涵蓋的(10/10):圖表用的餘額軌跡必須逐項等於真實的餘額軌跡。
assert res.balances_charted == res.balances_raw
兩個輸出、逐項比對、直接對應規格裡「圖表餘額不得下限截斷」那一條。十臺獨立生成都投了同一票。
實作長這樣:
balances_tuple = tuple(balances)        # 148
...
balances_raw=balances_tuple,            # 154
balances_charted=balances_tuple         # 156
兩個欄位指向同一個 tuple。這條斷言在比較一個東西跟它自己,折現算錯、通膨基準搞反、索引位移,它都不會紅。
把一個字都沒改的它放到上線那版:
tests/test_day26_demo.py::test_mr_charted_balances_veracity[legacy]  FAILED
tests/test_day26_demo.py::test_mr_charted_balances_veracity[fixed]   PASSED

E   AssertionError
E   At index 2 diff: 0.0 != -8503876.791881818
第三年就分歧。圖表顯示 0.00,真實餘額是負 850 萬,26 年裡 23 年被夾平。
charted.append(max(0.0, remaining))     # 121
...
balances_raw=tuple(raw),                # 127
balances_charted=tuple(charted),        # 128
兩條各自累積的 list,圖表那條把負餘額夾成 0。這塊遮羞布在第一幕編號成缺陷 A',它讓曲線貼著地面走,看起來像「剛好花完」。
同一條測試、同一個形狀,在一個實作上價值是零,在另一個實作上直接抓到缺陷。差別不在測試裡,在實作裡。
示範腳本裡另加兩條對照,用 is 而不是 ==:
def test_the_two_fields_are_the_same_object_in_fixed():
    res = fixed.calculate(get_base_params())
    assert res.balances_charted is res.balances_raw       # PASSED


def test_the_two_fields_are_separate_objects_in_legacy():
    res = legacy.calculate(get_base_params())
    assert res.balances_charted is not res.balances_raw   # PASSED
綠的那份之所以綠,不是因為實作對,是因為那兩個「輸出」根本是同一個東西。
看到 assert A == B 而兩邊都是程式的輸出,不要讀測試,去 grep 實作看那兩個欄位怎麼產生的:
| 查到什麼 | 這條測試值多少 |
|---|---|
| 同一個變數指過去兩次 | 零。恆綠,等於沒寫 |
| 一邊是另一邊的算術改寫 | 它在測別的東西,不是你以為的那個 |
| 兩邊各自算出來的 | 這才是對帳。留著 |
今天也出現了上述表格的第二種情況,十份產物中有五份寫出:
assert delta_gap == pytest.approx(-delta_savings) # 缺口的減少量 == 資產的增加量
這看似是跨輸出的對帳,但在程式中,缺口定義為「目標金額減資產」。代入後:
Δ缺口 ≡ Δ目標金額 − Δ資產          (定義,恆成立)
斷言 Δ缺口 == −Δ資產  ⟺  Δ目標金額 == 0
那五條都只動期初資金,所以它們真正斷言的是目標金額不受期初資金影響,也就是正交性。一條貨真價實、變異體打得到的關係,只是跟它的長相完全不同。
不是廢話,是它測的不是你以為的那個。這種最麻煩:報表綠的,關係也是真的,但你以為的覆蓋範圍跟實際的差了一截。
跟退休金無關的版本:
assert resp["count"] == len(resp["list"])
count = len(items) 是回傳前算的 → 零,任何實作下都綠count 來自 SELECT COUNT(*)、list 來自分頁查詢 → 很高,分頁 off-by-one、WHERE 不一致、快取沒失效全抓得到這個檢查不需要懂業務邏輯,看的是「這兩個值從哪來」而不是「這個金額算得對不對」,純結構判斷,可以直接寫進 code review checklist。
也就是說:不要讀測試,去讀那兩個欄位怎麼來的。 讀測試會讀到意圖,而意圖是寫測試的人(或模型)宣告的,跟程式實際做了什麼是兩件事。
十份裡八份刻意把月支出設到五十萬讓餘額跌破零,另外兩份沒有。那兩份即使放到有缺陷的版本一樣是綠的,餘額沒跌破零時 max(0, x) 就等於 x,兩條路徑還沒分岔。
所以要兩件事同時成立:
第二個條件容易被忽略。即便找對了關係,若僅輸入常規參數,錯誤也不會觸發。
143 條關係中,沒有任何一份寫出跨路徑的對帳(例如「資金設為目標金額,期末餘額應為 0」)。三次獨立的掃描均未出現此類測試。
它偏好寫起來順、讀起來合理的東西,而對帳那類繞、醜、容易寫錯。這個傾向前面量過兩次:Day 23 是它挑好算的數,Day 24 是它寫大量看起來合理的弱斷言。今天是第三次。
所以光說「寫蛻變測試」不夠,得加一句:
找出程式裡兩個必須吻合的出口,讓它們互相對帳。
不加,拿到的會是一堆縮放與單調:漂亮、有道理、抓不太到東西。
現成可以找的三個對帳點:
| 情境 | 該吻合的兩邊 | 先查什麼 |
|---|---|---|
| 報表 | 總計 vs 明細加總 | 總計是不是把明細加一次而已 |
| 匯出 | 畫面筆數 vs CSV 行數 | 兩邊是不是同一個 query |
| 對帳單 | 摘要餘額 vs 逐筆累加 | 摘要是不是快取了累加結果 |
這篇的主軸換了三次,前兩次都被我自己推翻。
第一版就是上面那條缺口關係。當時覺得抓到寶了,五份都寫了一條假的對帳,標題都想好了。隔幾個小時回頭對原始碼,代數一做完,寶就沒了。
比較難受的是判錯的方式。昨天才剛寫過一次同樣的教訓,把「殺 0 個變異體」讀成「這條關係是廢話」,隔一天又來一次。再往前翻還有第三次:把「兩次執行相加等於第三次」當成對帳,那時候也沒發現。
三次,同一個毛病,而且每一次當下都覺得自己看懂了。
這個系列寫到現在,量 AI 量了很多次。今天這一篇,有大半的時間其實是在量自己。
這些數字不能拿來做什麼
sort() 例子示範了「順序不變」與「長度加一」兩種形狀,而產出裡這兩類偏多。分布有一部分是提示詞自己的回音,所以本文不宣稱 AI 偏好哪一類關係逐條結果、事前預測、撤回經過與完整限制都在 manifest.yaml。
只帶走一件事
一條「兩個輸出該吻合」的測試,值不值錢,取決於那兩個輸出是不是同一段程式算出來的。
而這件事從測試本身看不出來,要去讀那兩個欄位怎麼產生的。
今天的檢查是人工做的:看到跨輸出的斷言,自己去 grep 實作。
十份產物、143 條關係,一條一條這樣查得完嗎?
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day26


 iThome鐵人賽
 看影片追技術