
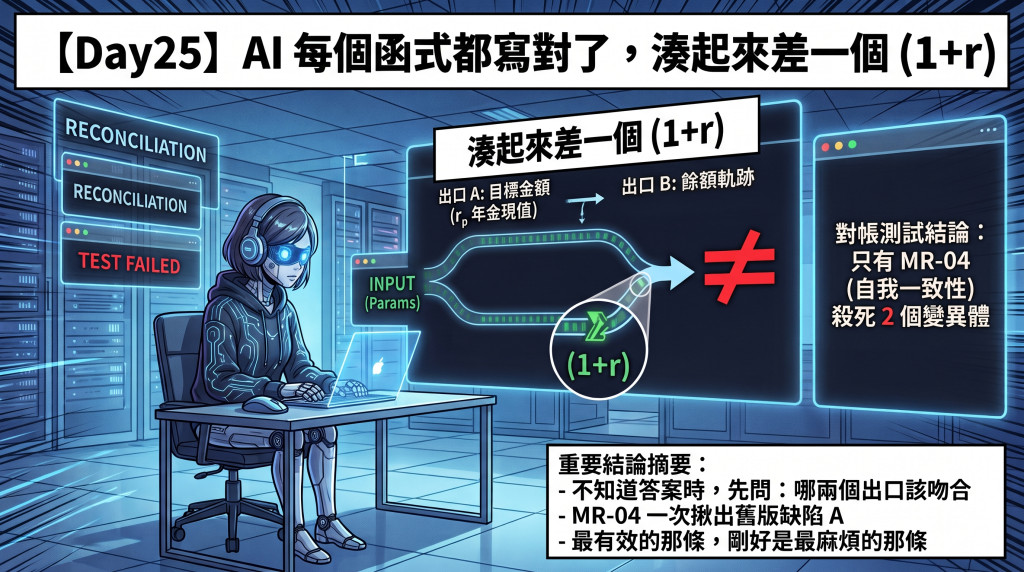
昨天的結論是:AI 寫測試時,那個期望值的唯一來源是它自己,而人核不動。所以換個問法:不問答案是多少,只問兩次執行之間該有什麼關係。
明天要把同一份規格交給 AI,要它寫這種測試。但在那之前得先確定一件事:這張考卷本身有沒有鑑別度。
拿一個沒驗證過價值的方法去考 AI,考不出什麼。所以今天先自己寫四條,然後想辦法確認哪一條真的抓得到東西。
| 編號 | 把輸入怎麼變 | 輸出該有什麼關係 |
|---|---|---|
| MR-01 | 所有金額同乘 k | 三個金額輸出剛好也乘 k |
| MR-02 | 月存↑/壽命↑/生活費↑/收入↑ | 方向固定:不減/不減/不減/不增 |
| MR-03 | 在月支出與固定年支出之間搬錢,年總額不變 | 三個輸出逐位元相同 |
| MR-04 | 資金設成剛好等於目標金額 | 缺口為 0、期末餘額為 0 |
四條都不需要知道任何一次的正確答案。
前三條十分鐘寫完。MR-04 花了最久:要先跑一次拿到目標金額,把報酬率和月存歸零好讓累積期退化成恆等式,再餵回去跑第二次。中間任何一步想錯,就會變成一條假的關係。
判準:把每條關係單獨拿去跑 Day 19 的十四個變異體,看它殺得掉幾個。
  MR-01 線性齊次     0
  MR-02 單調性      0
  MR-03 支出配置不變   0
  MR-04 自我一致性    2   (M01、M11)
最麻煩那條,是唯一抓到東西的。
前三條為什麼落空,事後看得很清楚:它們問的是「這支程式對自己一致嗎」,而它當然一致,bug 也會一致地壞下去。所有金額乘十倍,壞掉的實作照樣等比例地壞;生活費變貴,算錯的目標金額照樣跟著變大。
MR-04 問的是另一件事:這支程式的兩個不同部分,對彼此一致嗎。
(這裡要先講清楚:「殺 0 個」只代表這十四種錯法碰不到那三條關係,不代表它們沒用。如果實作把某個比例運算寫成「加一個固定常數」,MR-01 一秒就抓到,只是我設計的十四個變異體裡剛好沒有那種。這把尺只能證實,不能證偽。)
這支程式算的是同一件事的兩面:
它們在定義上必須對得起來。資金剛好等於目標金額,跑完二十一年就該剩 0,不多不少。
拿這條去跑舊版,也就是那支上線一年的原版:
assert math.isclose(res.balances_raw[-1], 0.0, abs_tol=1e-3)
E  where False = isclose(-28813.50481278846, 0.0, abs_tol=0.001)
差了兩萬八。
去翻實作:
# 目標金額(321–322 行):期末年金折現
target_for_expenses += net / (1 + p.post_retirement_return) ** i

# 餘額軌跡(372 行):期初扣款後滾存
remaining = (remaining - (net_expense + lump_this_year)) * (1 + p.post_retirement_return)
一段假設你年底才花錢,另一段假設你年初就花了。
把折現改成期初再跑一次:
| 目標金額 | 期末餘額 | |
|---|---|---|
| 現況(期末折現) | 328,752.69 | −28,813.50 |
| 改成期初折現 | 341,902.79 | −0.00 |
比值 1.040000,精確等於 1 + r_p。那就是 Day 4 推導的同一個因子:「沒有人能等到年底才吃第一頓飯」。
這是缺陷 A。第一幕花了四天驗屍才確認它,Day 6 的五百組差分測試抓不到(影子模型逐行複製原版,兩邊一起錯)。
一條對帳關係,一次就掉出來。而且從頭到尾不需要知道目標金額該是多少。
因為 AI 是一個函式一個函式寫的。
折現那段單獨看,是標準的年金現值公式,寫得完全正確。提領那段單獨看,是標準的餘額遞迴,也完全正確。兩段各自都對,沒有人要求它們之間要對得起來。
缺口就開在那裡。
這個手法可以直接搬去別的地方,只要找得到「同一份資料的兩個出口」:
| 情境 | 該吻合的兩邊 |
|---|---|
| 報表 | 總計 vs 明細加總 |
| API | 回傳的 count vs list 長度 |
| 對帳單 | 摘要頁餘額 vs 逐筆交易累加 |
| 匯出功能 | 畫面顯示的筆數 vs CSV 行數 |
每一組都不需要你知道正確答案,只需要知道它們必須相等。
M14 是「退休後收入不隨通膨調升」,從第一次量變異分數活到今天,沒有任何方法殺得掉。
跑之前我把四條關係逐一推過,寫進預測欄:齊次性抓不到(它改的是通膨指數,不是齊次性)、單調性抓不到(收入增加仍然讓目標金額下降)、支出配置抓不到(那是支出端的事)、自我一致性也抓不到(目標與軌跡用的是同一份壞掉的收入,兩邊仍然自洽)。
實測:四條全部抓不到。
要殺它需要一條關於「通膨率與收入怎麼交互」的關係。那不是套公式套得出來的,得有人真的想過,退休後的收入到底該不該跟著物價走。
四條關係裡我最喜歡 MR-01,最不想寫的是 MR-04。
MR-01 漂亮:一行數學性質,三個 k 值一次驗三個輸出,十行寫完,讀起來像教科書例題。MR-04 醜:繞兩次、設一堆為零的參數好讓公式退化、還得把前一次的輸出接回去當輸入,寫完自己讀都要想一下。
結果漂亮那條什麼都沒抓到,醜的那條抓到了缺陷 A。
這件事對明天很重要。最有效的關係,剛好是最難想到、最麻煩寫的那種,而前面幾天量過 AI 的傾向:它挑好算的數(1000 而不是 19391)、它寫大量看起來合理的弱斷言。它偏好寫起來順、讀起來合理的東西。
所以明天的預測,我先寫在這裡:AI 會寫出前三種那類的關係,寫不出第四種。
猜錯的話,那會是這一幕最值得寫的一天。
這些數字不能拿來做什麼
四條關係是我一個下午寫的,不代表「蛻變關係能做到的上限」。
「殺 0 個」不等於「沒用」,它只說明我設計的那十四種錯法碰不到那三條關係。這把尺只能用來證實一條關係有用,不能用來證明它沒用。原稿的標題本來寫「三條是廢話」,那是把一把已知有盲區的尺當成了真理,被讀者指出來之後改掉。
MR-04 抓到缺陷 A 是單一案例,不構成「對帳關係一定有效」的通則。它證明的是這個方法至少有一次抓到了其他方法漏掉的東西。
逐條結果、事前預測與限制在 manifest.yaml。
只帶走一件事
AI 寫的每個函式可能都是對的,而它們湊不起來。
找出兩個該吻合的出口讓它們對帳:你不必知道正確答案,只需要知道它們必須相等。
明天把同一份規格交給 AI,要它寫這種測試。考卷已經驗過了:四條關係裡有一條真的抓得到東西。
問題是它會不會挑那一條。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day25


 iThome鐵人賽
 看影片追技術