iT邦幫忙

2026 iThome 鐵人賽

DAY 1
0
Software Development

學校沒教的後端生存指南:30 天打造非同步 S3 微服務,部署 K8s 實現 HA 架構系列 第 1 篇

[ Day 1 ] 為甚麼本地端好好的,上線怎麼炸了?告別通靈除錯的架構演進之旅

  • 分享至 

  • xImage
  •  

為什麼明明在本地端跑都好好的,為什麼一上線就炸了?

剛踏入軟體工程師這個領域滿一年,這句話大概是我在心裡吶喊過最多次的一句話。以前在學校做專題或實驗時,專案較小,使用者不多,目標也很單純:「讓功能可以動」。資料庫能寫入、檔案能上傳,就算是大功告成。

然而真正進入企業,才發現真實世界的軟體工程領域到底有多龐大、多深不可測。實務上,面對大型系統與龐大的流量時,情況完全不同。我們寫的程式碼,是疊加在無數的底層網路、雲端服務與開源套件之上。在這種疊床架屋的龐大架構下,最怕的從來不是功能寫不出來,而是系統一上線,就在某個意想不到的環節徹底崩潰。
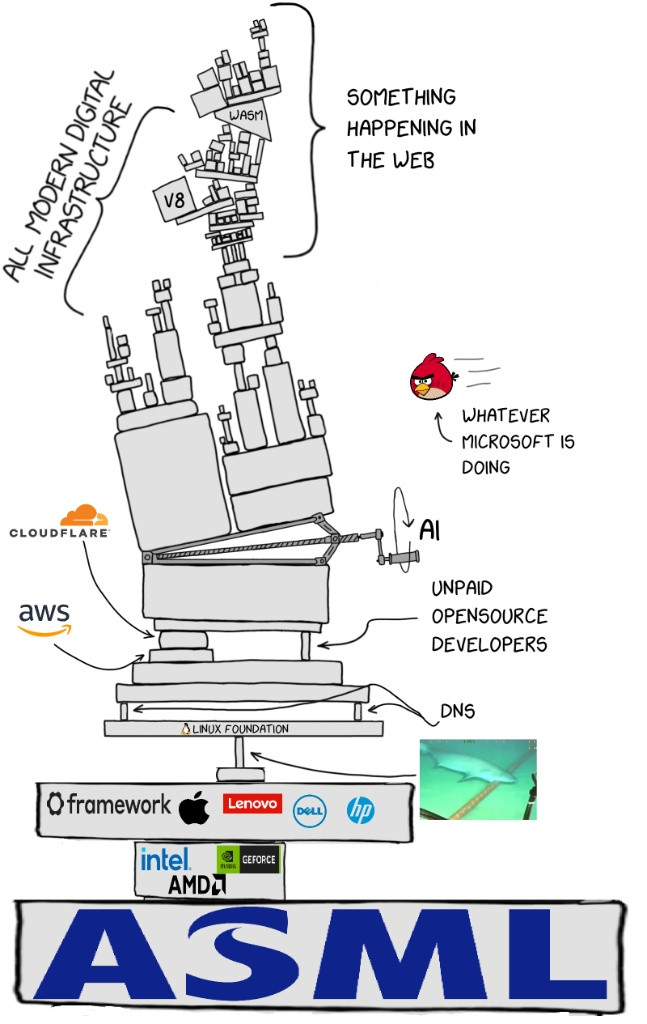
https://ithelp.ithome.com.tw/upload/images/20260828/20183864h9UdGFaIex.jpg
(圖片來源 : programmerHumor.io)

實習的震撼教育

說到這裡,想跟大家分享一個小故事。

記得之前還在實習的時候,主管請我去觀察一次壓力測試下的系統流量變化。當時的我對 CPU、Memory 或是 I/O 飆高代表的深層意義根本一知半解。於是,我理所當然地把監控 Dashboard 上的圖表全部截圖下來貼到報告裡,心想:主管比較有經驗,把圖放上去他一定看得懂吧!

結果開會時,主管指著其中一張圖問我:這張圖你想表達什麼?
我當下腦袋一片空白,一句話都說不出來。
主管就嚴肅的說:如果你不知道這張圖要表達什麼,就代表它不用放上來。

當下真的覺得好可怕(嗚嗚嗚),但也讓我對實習還有工作心態上有所轉變

它讓我徹底體悟到一個核心價值:每個技術決策與產出,背後都要有清晰的原因和數據支撐。 以前在學校,可能是老師規定,或是學長姊怎麼做我們就跟著做;但現在面對真實的大型系統,達到目的的路徑有千百條,我們必須清楚知道為什麼選這條路,而不是一昧地遵循,而這也是我在AI時代中很大的感觸,我們慢慢從開發者的角色轉變成決策者,也因此每次都決定都必須清楚知道目的與利弊,使用AI查資料或寫程式時也必須時時質疑和了解每一個決策背後的意義(好啦有點跑題了)。

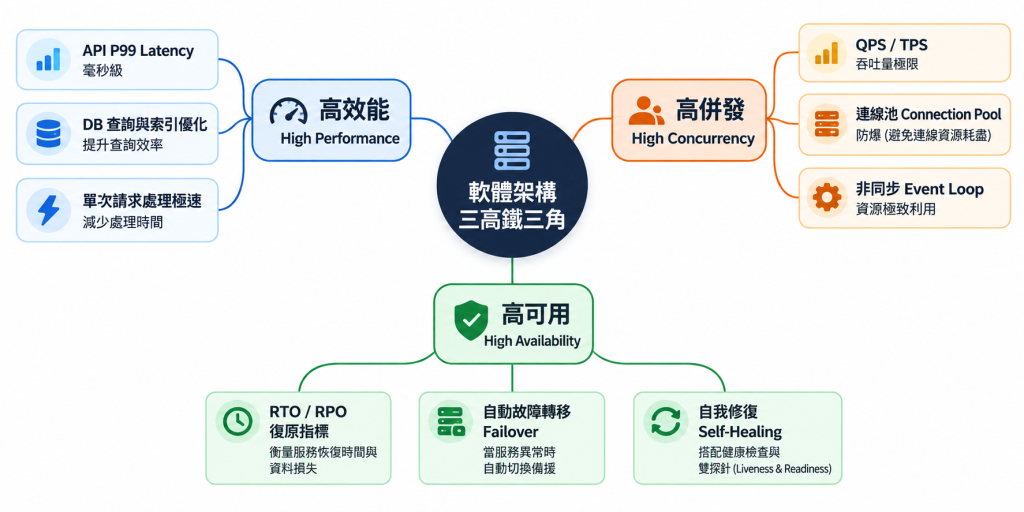
軟體架構的鐵三角:高併發、高可用、高效能

回到正題,學校可能學過一個好的軟體架構,是為了解決真實世界的挑戰,必須跳脫把功能做完的思維,轉而擁抱現代軟體架構的核心,也就是俗稱的三高:
https://ithelp.ithome.com.tw/upload/images/20260928/20183864Qvz8PvUe0L.png

  • 高效能 (High Performance): 系統處理單一請求的速度有多快?(例如:如何降低 API 的 Latency、如何優化資料庫查詢)。
  • 高併發 (High Concurrency): 系統同時能接待多少客人?(例如:當一萬人同時上傳檔案時,伺服器的連線池會不會崩潰?)。
  • 高可用 (High Availability, HA): 系統有多耐操?(例如:遇到網路延遲、封包遺失,甚至是伺服器硬體死機時,系統能不能自動恢復,確保服務不中斷?)。

在大型的服務系統裡面,很常遇到突發狀況,如果今天有一萬個使用者,同時在網路訊號極差的高鐵上,試圖上傳報表或照片到 AWS S3,我們的系統還能活著嗎?會不會因為幾次 Timeout,就導致系統卡死?會不會因為短暫的斷線,產生一堆重複的髒資料?以及部署之後要怎麼確保程式碼可以持續整合跟持續部署,這就是我們這 30 天要解決的問題。

這 30 天,我們會學到什麼?

帶著大家了解軟體工程的重要觀念,打造一個高併發的AWS S3 儲存微服務,並且最終部屬在K8s的叢集上,實作真正的HA架構,詳細內容會包含:

  1. 底層引擎的抉擇(效能與併發): 拋棄傳統同步的 Apache HTTP Client,實作基於 Netty 的非同步連線,測試效能差異。
  2. 對抗惡劣網路的防呆機制(可用性): 捨棄笨重且不現實的三階段提交,實作更輕量、高彈性的 Double-Check Pattern 搭配客戶端重試機制,確保在各種 Timeout 與斷線下,檔案狀態依然保持一致。
  3. 殘酷的壓力測試: 利用 JMeter 在本地端模擬高延遲、封包遺失與極端流量,見證單機 Docker 容器是如何被流量榨乾的。
  4. 邁向真正的高可用架構: 當單機達到極限,我們將服務搬上 Kubernetes (K8s),再次進行與前階段相同的壓力測試,見證 K8s 如何實現真正的 HA。

第一階段:簡介與底層核心理論

第二階段:連線引擎的抉擇與微服務開發實戰

第三階段:惡劣網路與分散式一致性防禦

第四階段:容器化、可觀測性與單機極限

第五階段:邁向 K8s 高可用叢集與 HPA 壓測

第六階段:狀態持久化、CI/CD 與完賽總決算

Github Repo

我已經將文章中所有用到的程式碼以及完整的s3-service微服務放到github上,大家都可以pull下來參考,或是自己來實作喔!
Github : 2026-ithome-s3-service

本系列技術棧預備清單

我們不需要先具備複雜的 K8s 或雲端架構經驗,我會帶著大家從 localhost 一步步動手建置:

  • 核心語言與框架:Java 21, Spring Boot 3, Netty, AWS Async SDK v2
  • 防禦與架構元件:Resilience4j, Semaphore, Double-Check Pattern, Idempotency Token
  • 容器與監控工具:Docker, Docker Compose, Prometheus, Grafana, JMeter
  • 叢集與 CI/CD:Kubernetes (Minikube), kubectl, HPA, PV/PVC, GitHub Actions, AWS ECR, AWS EC2

清楚知道每個技術決策背後的意義,並用數據來證明它,這才是一個能持續自我提升、不會被時代淘汰的工程師應具備的能力!

準備好你的 IDE 和終端機,我們就要正式開始啦!


下一篇
[ Day 2 ] 理想與現實的落差:大型系統到底在考量什麼?
系列文
學校沒教的後端生存指南:30 天打造非同步 S3 微服務,部署 K8s 實現 HA 架構 共 30 篇
圖片
  熱門推薦
圖片
{{ item.channelVendor }} | {{ item.webinarstarted }} |
{{ formatDate(item.duration) }}
直播中

尚未有邦友留言

立即登入留言